Postingan AI Trending & Rangkuman Riset Terbaru - Halaman 1720
Claude Opus 4.7 vs GPT-5.5: Mana Lebih Stabil untuk Riset Panjang?
17 sumber0Belum ada uji publik dengan topik, alat, batasan, dan penilaian yang sama yang membuktikan Claude Opus 4.7 atau GPT 5.5 selalu lebih jarang gagal fokus.
Ukuran Gambar GPT Image 2: Apa yang Benar-benar Dikonfirmasi OpenAI API
18 sumber0Yang bisa dikonfirmasi: GPT Image 2 ada di dokumentasi API OpenAI, Images API memiliki field size, dan contoh edit gambar menampilkan 1024x1024 [1][14][18].
Apa Itu Kimi K2.6? 5 Pertanyaan Sebelum Memakai API, Local Run, Benchmark, dan Deploy
12 sumber0Kimi K2.6 diposisikan sebagai model terbaru Kimi untuk coding jangka panjang, agent, dan input multimodal; evaluasinya sebaiknya tidak hanya melihat satu angka benchmark.
Cek Fakta Kimi K2.6 Agent Swarm: Ada Menu Website, PPT, dan Sheets, tetapi Klaim Sekali Jadi Belum Terbukti
12 sumber0Yang bisa diverifikasi: Kimi K2.6 disebut memiliki Agent Swarm, long horizon execution, dan kemampuan coding; situs Kimi juga menampilkan menu Websites, Slides/PPT, dan Sheets/tabel.[2][6][7]
Kimi K2.6 via Moonshot API: endpoint benar dan cara cek model ID
18 sumber0Untuk Kimi K2.6 di API resmi Moonshot, gunakan base url https://api.moonshot.ai/v1 dan endpoint /chat/completions; model ID sebaiknya diambil dari GET /models.
GPT-5.5 vs Claude Opus 4.7: Claude Unggul di Benchmark, GPT-5.5 Kuat di Workflow
20 sumber0Claude Opus 4.7 punya sinyal benchmark coding agent yang lebih kuat dalam sumber publik yang dikutip: 64,3% di SWE bench Pro, dibanding 58,6% yang dilaporkan untuk GPT 5.5.[33][39]
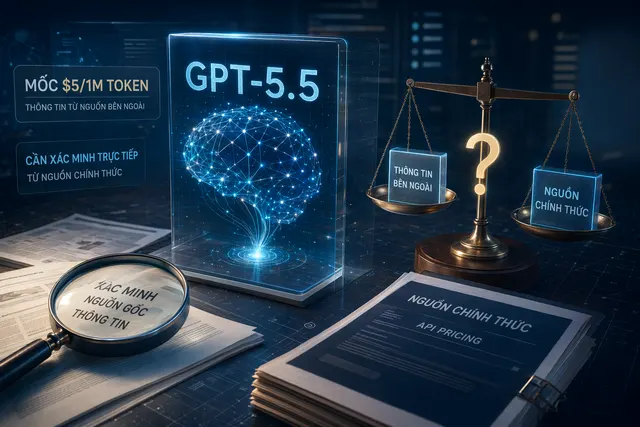
Harga GPT-5.5: apakah US$5 per 1 juta token sudah resmi?
19 sumber0Patokan paling spesifik yang tersedia saat ini: Economic Times menyebut API GPT 5.5 mulai dari US$5 per 1 juta token; tetapi halaman OpenAI API Pricing yang diperiksa belum menampilkan baris harga khusus GPT...
GPT-5.5 vs GPT-5.4: peningkatan nyata, tapi belum tentu wajib migrasi
15 sumber0GPT 5.5 tampak lebih kuat, tetapi peningkatannya inkremental: OpenAI melaporkan 84,9% di GDPval untuk GPT 5.5, dibanding 83,0% untuk GPT 5.4.[14][12]
GPT-5.5 vs GPT-5.4: Kapan Layak Upgrade, Kapan Sebaiknya Menunggu
19 sumber0GPT 5.5 dirilis pada 23 April 2026 dan diposisikan untuk pekerjaan nyata seperti coding, riset online, analisis informasi, dokumen, spreadsheet, dan workflow lintas alat.[22][15]
Legitimasi Polisi di Hong Kong: Kepercayaan, Protes, dan Akuntabilitas
7 sumber0Legitimasi polisi di Hong Kong paling tepat dipahami sebagai hubungan yang bersifat kondisional antara otoritas, kepercayaan publik, persepsi keadilan, dan akuntabilitas [1][3][4][7].
GPT-5.5 vs Claude Opus 4.7: mana yang lebih tepat untuk coding, UI, dan biaya API?
20 sumber0GPT 5.5 unggul di Terminal Bench 2.0 dengan 82,7% dibanding Claude Opus 4.7 di 69,4%, tetapi tabel yang sama memberi catatan bahwa harness evaluasinya berbeda.[8]
GPT-5.5 vs GPT-5.4: mana yang lebih tepat untuk kerja nyata?
19 sumber0GPT 5.5 secara umum lebih kuat untuk pekerjaan yang menuntut kemampuan maksimal; OpenAI melaporkan skor 84,9% di GDPval, 78,7% di OSWorld Verified, dan 98,0% di Tau2 bench Telecom [22].