ट्रेंडिंग AI पोस्ट और हॉट रिसर्च कैचअप - पेज 1726
GPT-5.5 बनाम Claude Opus 4.7: Benchmarks और सही मॉडल चुनने की गाइड
23 स्रोत0कोई universal winner नहीं है: GPT 5.5 Terminal Bench 2.0 पर 82.7% और FrontierMath Tier 4 पर 35.4% reported है, जबकि Claude Opus 4.7 SWE Bench Pro पर 64.3% और MCP Atlas पर 77.3 79.1% दिखता है; सही चुनाव workl...
Codex बनाम Claude Code: 2026 में AI कोडिंग के लिए कौन सस्ता है?
17 स्रोत0API कीमतों में gpt 5.1 codex mini सबसे सस्ता दिखता है: 10 लाख input + 10 लाख output tokens के सरल उदाहरण में लागत $2.25 है।
Codex बनाम Claude Code: AI कोडिंग वर्कफ़्लो के लिए सही चुनाव
18 स्रोत0Codex तब बेहतर बैठता है जब टीम को OpenAI ecosystem में CLI, IDE, web/app, review, automations, worktrees और integrations वाला व्यापक coding agent workflow चाहिए।
Codex vs Claude Code: आपके workflow के लिए कौन बेहतर है?
15 स्रोत0एक ही tool से शुरुआत करनी हो और आपका काम existing repositories, codebase understanding और git workflows पर केंद्रित है, तो Claude Code बेहतर default है; caveat यह है कि यह universal benchmark verdict नहीं, w...
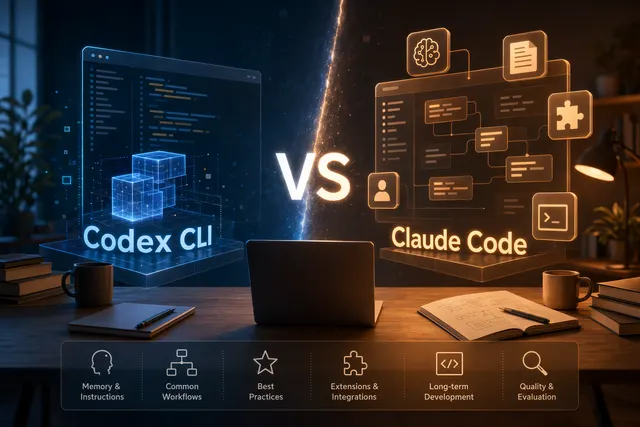
Codex CLI बनाम Claude Code: मुख्य AI Coding Agent चुनने की गाइड
17 स्रोत0रोज़मर्रा के मुख्य AI coding agent के लिए पहले Claude Code आज़माना ज्यादा सुरक्षित विकल्प दिखता है, क्योंकि उसकी आधिकारिक docs में instructions/memories, common workflows, best practices, extensions, platfor...
Claude Code vs Codex: UI डिज़ाइन और Figma-to-code में कौन बेहतर?
15 स्रोत0Figma to Next.js तुलना में Claude Code ने design structure और assets को बेहतर संभाला; Codex ने काम करने वाला page बनाया और 4 गुना कम tokens इस्तेमाल किए, लेकिन original theme/layout से ज्यादा दूर रहा [6]।
OpenAI Codex बनाम Claude Code: लोकल डेवलपमेंट, PR ऑटोमेशन और कीमत
24 स्रोत0लोकल repo में लंबे debug, refactor और test run वाले काम के लिए Claude Code पहले आज़माएँ; PR review, Slack, multi interface और cloud based tasks के लिए OpenAI Codex ज्यादा सीधा विकल्प है [15][37].
Claude Code बनाम OpenAI Codex: आपकी टीम के लिए सही AI कोडिंग टूल कौन-सा?
19 स्रोत0Claude Code codebase aware local development, multi file workflow और granular permissions के लिए बेहतर documented fit दिखता है।
GPT-5.5 बनाम Claude Opus 4.7, DeepSeek V4 और Kimi K2.6: कौन किस काम में बेहतर?
22 स्रोत0समग्र Intelligence Index में GPT 5.5 xhigh 60 और GPT 5.5 high 59 पर है, जबकि Claude Opus 4.7 Adaptive Reasoning Max Effort 57 पर है.[2]
Claude Opus 4.7 बनाम GPT-5.5, DeepSeek V4 और Kimi K2.6: प्रचार नहीं, सबूतों से तुलना
29 स्रोत0उपलब्ध सार्वजनिक प्रमाणों से कोई एक मॉडल निर्विवाद रूप से सबसे अच्छा साबित नहीं होता; बेंचमार्क और स्पेक्स समान आधार पर उपलब्ध नहीं हैं।
GPT-5.5 बनाम Claude Opus 4.7 बनाम DeepSeek V4 बनाम Kimi K2.6: किस काम के लिए कौन-सा मॉडल बेहतर?
17 स्रोत0Claude Opus 4.7 reasoning और SWE Bench Pro में मजबूत दिखता है; GPT 5.5 Pro tool use और browsing में आगे है; GPT 5.5 Terminal Bench 2.0 में स्पष्ट बढ़त रखता है।
Claude Opus 4.7, GPT-5.5, DeepSeek V4 और Kimi K2.6: 2026 बेंचमार्क में असली बढ़त किसकी?
26 स्रोत0उपलब्ध सार्वजनिक डेटा से चारों मॉडलों की पक्की 1–4 रैंकिंग तय नहीं होती। Claude Opus 4.7 का BenchLM 97/100 और SWE bench Verified 82.4%, GPT 5.5 के GDPval 84.9% जैसे स्कोर अलग अलग मूल्यांकन धुरियों पर हैं [2]...