Publicaciones de AI en tendencia e investigación al día - Página 1733
Codex vs. Claude Code: cuál conviene para programar con IA
18 fuentes0Elige Codex si buscas un agente de programación integrado en varias superficies de trabajo: app, IDE, CLI, web, revisiones, automatizaciones, worktrees y entornos locales [2].
Codex vs Claude Code: cuál encaja mejor en tu flujo de desarrollo
15 fuentes0Si vas a empezar con una sola herramienta y trabajas sobre repositorios existentes, comprensión de código y flujos con git, Claude Code es el punto de partida más razonable.
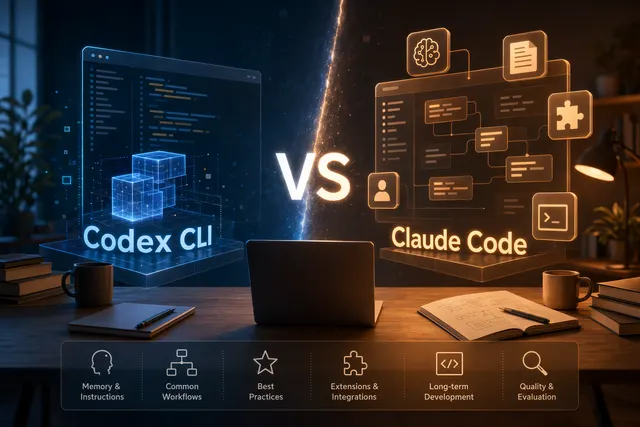
Codex CLI vs Claude Code: cuál elegir como agente de programación con IA
17 fuentes0Si necesitas escoger hoy un agente de programación con IA para uso diario, Claude Code es el primer candidato más prudente: su documentación oficial cubre instrucciones y memorias, flujos comunes, buenas prá...
Claude Code vs. Codex para diseño UI: ¿cuál conviene para Figma a código?
15 fuentes0Para trabajos UI con mucho peso visual, empieza con Claude Code: en una prueba de Figma a Next.js conservó mejor la estructura del diseño y las imágenes; Codex fue más eficiente y usó 4 veces menos tokens [6].
OpenAI Codex vs Claude Code: cuál elegir para desarrollo local, PR y automatización
24 fuentes0Si trabajas sobre repositorios locales, terminal, refactorizaciones largas y depuración, empieza por Claude Code; si tu prioridad es revisión de PR, Slack, Web, CLI, IDE, iOS y tareas en la nube, Codex es má...
Claude Code vs. OpenAI Codex: qué herramienta de IA encaja con tu equipo
19 fuentes0Claude Code aparece mejor documentado para desarrollo local sobre repositorios, trabajo entre varios archivos y permisos granulares.
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: benchmarks, precio y mejores usos
22 fuentes0GPT 5.5 tiene la señal agregada más fuerte: Artificial Analysis sitúa GPT 5.5 xhigh en 60 y GPT 5.5 high en 59, por delante de Claude Opus 4.7 en 57.[2]
Claude Opus 4.7 vs GPT-5.5 vs DeepSeek V4 vs Kimi K2.6: qué dice la evidencia
29 fuentes0No hay un ganador global defendible con la evidencia pública disponible: los benchmarks y fichas técnicas no son plenamente comparables entre los cuatro modelos [4][22][32][37].
GPT-5.5, Claude Opus 4.7, DeepSeek V4 y Kimi K2.6: qué modelo elegir según el benchmark
17 fuentes0Claude Opus 4.7 lidera GPQA Diamond con 94,2 % y HLE sin herramientas con 46,9 %; GPT 5.5 Pro lidera HLE con herramientas (57,2 %) y BrowseComp (90,1 %), mientras GPT 5.5 encabeza Terminal Bench 2.0 (82,7 %)...
Claude Opus 4.7 vs GPT-5.5 vs DeepSeek V4 vs Kimi K2.6: el ranking único no cuenta toda la historia
26 fuentes0No hay una clasificación pública homogénea que ordene de forma limpia a los cuatro modelos.
DeepSeek V4 vs GPT-5.5: qué benchmarks importan y qué modelo elegir
21 fuentes0GPT 5.5 es más fácil de evaluar para producción vía API: OpenAI publica el ID gpt 5.5, precio de $5/$30 por millón de tokens, contexto de 1M, salida máxima de 128K y herramientas oficiales [22].
GPT-5.5 vs Claude Opus 4.7: qué benchmark importa para tu carga de trabajo
20 fuentes0No hay vencedor universal: GPT 5.5 lidera Terminal Bench 2.0 con 82,7% frente a 69,4%, mientras Claude Opus 4.7 lidera SWE Bench Pro con 64,3% frente a 58,6%.