Claude Opus 4.7 vs. Opus 4.6: ¿vale la pena actualizar ahora?
Claude Opus 4.7 se presenta como una actualización directa de Opus 4.6 en el mismo rango de precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida, según LLM Stats.[8] Las mejoras más claras se concentran en ingeniería de software avanzada, agentes de larga duración y visión; L...
Publicado porEditado con GPT-5.5Imágenes generadas con GPT Image 2
Claude Opus 4.7 se presenta como una actualización directa de Opus 4.6 en el mismo rango de precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida, según LLM Stats.[8]
Las mejoras más claras se concentran en ingeniería de software avanzada, agentes de larga duración y visión; LLM Stats reporta 87,6 % en SWE bench Verified, 6,8 puntos porcentuales por encima de Opus 4.6.[6][8][9]
Aun así, buena parte de los datos públicos procede de benchmarks autorreportados o casos internos de socios, por lo que no conviene asumir que todos los flujos de trabajo con 4.6 mejorarán automáticamente.[3][6]
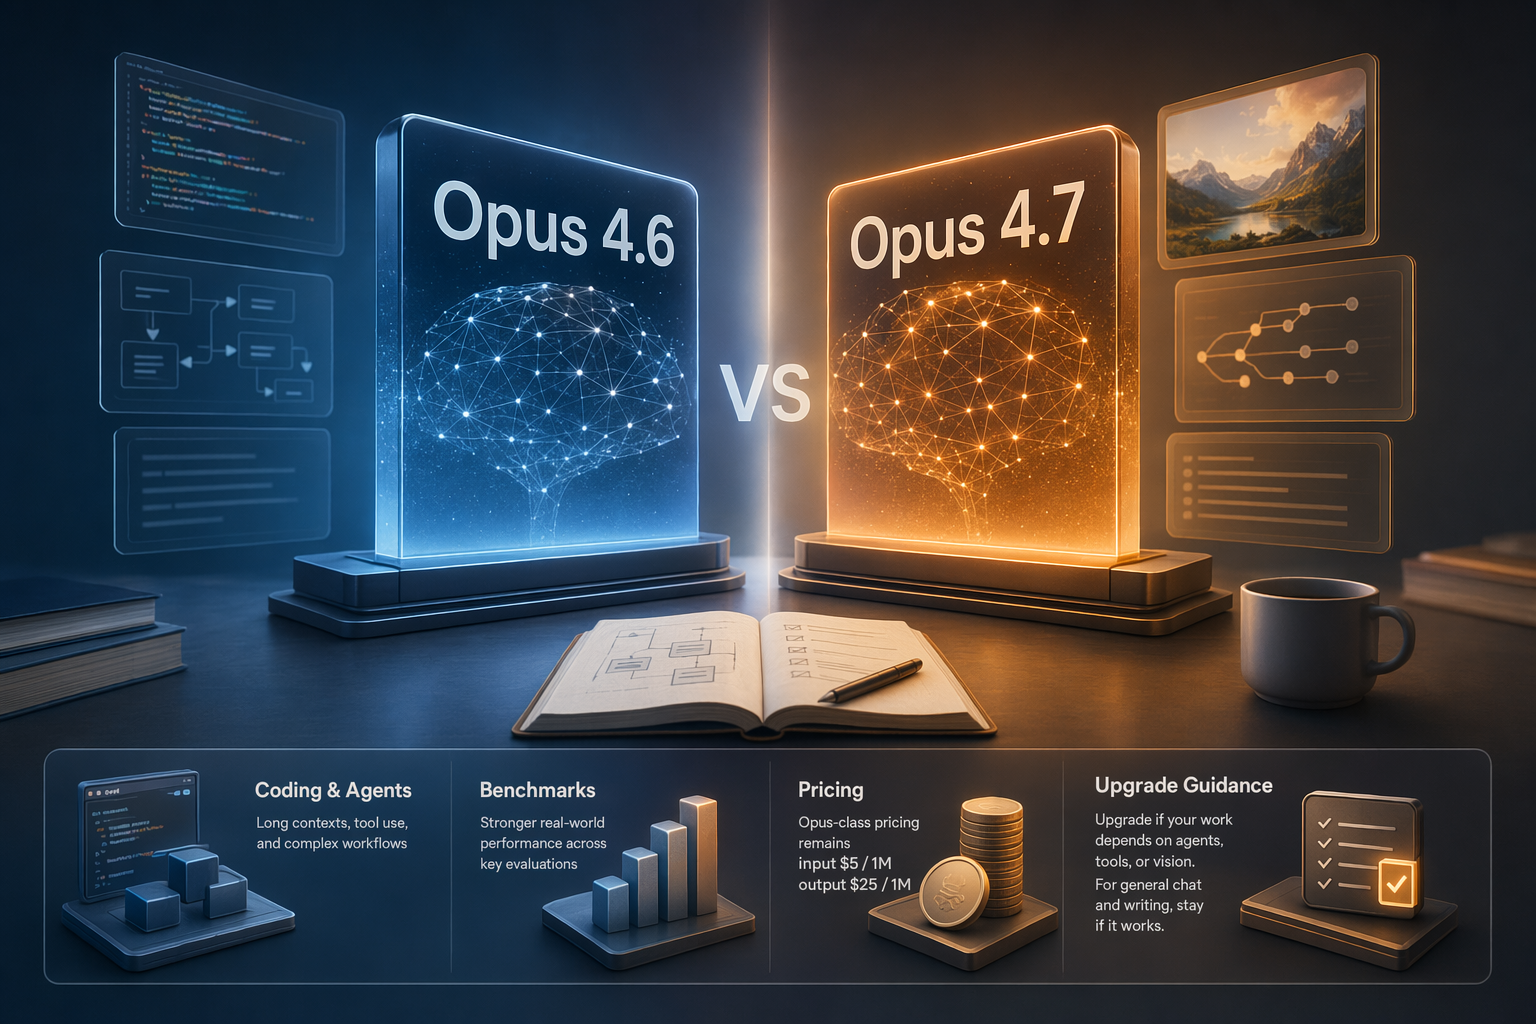
Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議AI 生成的 Claude Opus 4.7 vs Opus 4.6 比較主視覺。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議. Article summary: Claude Opus 4.7 在 2026 04 16 上線,公開資料顯示 Opus 級價格仍是每百萬 input $5、output $25;若你做 coding agent、長流程工具調用或視覺理解,值得優先試升,但一般聊天或文案不必只為版本號遷移。[6][8][9]. Topic tags: ai, anthropic, claude, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade Now? A route-first upgrade guide that compares Claude Opus 4.7 and Claude Opus 4.6 through workflow fit, benchmark" source context "Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade ..." Reference image 2: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source
openai.com
La respuesta corta: Claude Opus 4.7 no es una actualización que todo el mundo deba activar a ciegas. Es, más bien, una mejora dirigida dentro de la misma familia Opus, con foco claro en programación compleja, agentes que usan herramientas durante varios pasos y tareas de visión con imágenes más exigentes.
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
¿Cuál es la respuesta corta a "Claude Opus 4.7 vs. Opus 4.6: ¿vale la pena actualizar ahora?"?
Claude Opus 4.7 se presenta como una actualización directa de Opus 4.6 en el mismo rango de precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida, según LLM Stats.[8]
¿Cuáles son los puntos clave a validar primero?
Claude Opus 4.7 se presenta como una actualización directa de Opus 4.6 en el mismo rango de precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida, según LLM Stats.[8] Las mejoras más claras se concentran en ingeniería de software avanzada, agentes de larga duración y visión; LLM Stats reporta 87,6 % en SWE bench Verified, 6,8 puntos porcentuales por encima de Opus 4.6.[6][8][9]
¿Qué debo hacer a continuación en la práctica?
Aun así, buena parte de los datos públicos procede de benchmarks autorreportados o casos internos de socios, por lo que no conviene asumir que todos los flujos de trabajo con 4.6 mejorarán automáticamente.[3][6]
Si ya usas Opus 4.6 para revisar repositorios, corregir bugs, coordinar agentes o interpretar capturas y documentos visuales, Opus 4.7 merece una prueba A/B pronto. Si tu uso principal es conversar, resumir, traducir o pulir textos, la evidencia pública todavía no justifica una migración completa solo por el cambio de versión.
Lo esencial en una tabla
Aspecto
Qué cambia en Opus 4.7
Qué significa para decidir
Disponibilidad
LLM Stats sitúa el lanzamiento de Opus 4.7 el 16 de abril de 2026, y Anthropic indica que los desarrolladores pueden usar claude-opus-4-7 mediante Claude API.
Ya se puede planificar una prueba real, no solo esperar una promesa de producto.
Precio
LLM Stats describe Opus 4.7 como una actualización directa de Opus 4.6 al mismo precio: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida.
El coste unitario no sube, aunque la factura final dependerá de tokens generados, reintentos y diseño del flujo.
Programación
Anthropic lo posiciona como más fuerte en ingeniería de software avanzada, sobre todo en tareas difíciles; LLM Stats reporta 87,6 % en SWE-bench Verified, 6,8 puntos porcentuales más que Opus 4.6.
Es el primer candidato para probar en agentes de código, análisis de repositorios, refactorizaciones y reparación de tests.
Agentes y tareas largas
LLM Stats menciona mejoras de autoverificación en trabajo agentivo de larga duración, y Anthropic también destaca avances en tareas largas.
Visión
Anthropic afirma que 4.7 mejora claramente en visión y puede trabajar con imágenes de mayor resolución; LLM Stats habla de unas 3,3 veces más resolución de imagen.
Nuevos controles
Recopilaciones de terceros mencionan xhigh effort y funciones como Task Budgets, orientadas a agentes y programación.
Cómo leer los benchmarks sin pasarse de entusiasmo
Los benchmarks públicos apuntan en una dirección bastante clara: Opus 4.7 parece mejor preparado que Opus 4.6 para programación difícil, flujos con agentes y visión de mayor resolución. El dato más citado es el 87,6 % en SWE-bench Verified, con una mejora de 6,8 puntos porcentuales frente a Opus 4.6, y LLM Stats afirma que 4.7 supera a 4.6 en 12 de 14 benchmarks reportados.
Pero hay que leer esos números con cuidado. LLM Stats advierte que los benchmarks de su comparativa son autorreportados por Anthropic. Además, Verdent AI señala que algunos ejemplos destacados, como los de Notion y Rakuten, proceden de contextos internos o benchmarks propietarios, no de una evaluación pública y controlada aplicable a cualquier equipo.
En la práctica, eso significa que los datos sí respaldan una hipótesis razonable: 4.7 probablemente sea mejor para tareas de código complejas, agentes largos y entradas visuales exigentes. Lo que no respaldan es una conclusión automática del tipo: todo lo que hoy haces con 4.6 va a salir igual de estable, más barato y mejor.
Precio: mismo coste por token, no siempre misma factura
El punto más cómodo para probar Opus 4.7 es que, según LLM Stats, mantiene el precio de Opus 4.6: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida. Para equipos que ya pagan el nivel Opus, eso reduce la fricción inicial: no hay que justificar una tarifa por token más alta antes de medir calidad.
Aun así, el coste real se calcula por tarea completada, no solo por tarifa. Si 4.7 produce respuestas más largas, cambia el número de reintentos o se combina con nuevos niveles de esfuerzo, la factura puede moverse. También puede ocurrir lo contrario: si reduce errores de herramientas, correcciones humanas o ciclos fallidos, el coste total del proceso puede bajar aunque el precio por token sea idéntico.
Por eso la pregunta correcta no es solo cuánto cuesta el millón de tokens. Es cuánto cuesta resolver el mismo trabajo con calidad aceptable, latencia razonable y menos intervención humana.
Quién debería probar Opus 4.7 cuanto antes
Equipos de software y agentes de código. Si ya usas Opus 4.6 para leer repositorios, arreglar bugs, generar parches, revisar pull requests, reparar tests o coordinar cambios en varios archivos, las mejoras públicas de 4.7 encajan justo con tu caso de uso.
Flujos con herramientas y varios pasos. Cuando un agente debe planificar, llamar herramientas, comprobar resultados, corregirse y continuar, pequeñas mejoras de estabilidad pueden tener mucho impacto. Las fuentes públicas destacan precisamente el trabajo agentivo de larga duración como una de las áreas donde 4.7 avanza respecto a 4.6.
Productos que dependen de imágenes. Si tus usuarios suben capturas de pantalla, tablas, documentos escaneados, diagramas de arquitectura, mockups o imágenes con mucho detalle, el salto de visión puede ser más tangible que en un chat de texto puro.
Equipos que ya aceptan el coste Opus. Si 4.6 ya está dentro de tu presupuesto, probar 4.7 es más fácil porque el precio unitario reportado se mantiene igual.
Quién puede esperar
Si tu uso principal es conversación general, resúmenes, traducción, lluvia de ideas o redacción ligera, no hay una razón fuerte para migrar todo de inmediato. No porque 4.7 sea peor, sino porque la evidencia pública se concentra en código, agentes y visión, no en demostrar una mejora igual de visible en todos los usos cotidianos.
También conviene esperar si tu sistema de producción está muy afinado para Opus 4.6. Cambiar de modelo puede alterar tono, formato, longitud de respuesta o distribución de errores. Incluso cuando el modelo nuevo es más capaz, puede romper supuestos que tus prompts, validadores o flujos posteriores daban por estables.
Lista práctica para una prueba A/B
Antes de reemplazar 4.6 por 4.7 en todo el tráfico, conviene comparar con tus propios casos reales:
Elige tareas representativas. Incluye casos fáciles, casos donde 4.6 suele fallar, tareas largas, entradas visuales y trabajos de alto valor.
Mantén igual el entorno. Usa los mismos prompts, herramientas, límites y datos siempre que sea posible. Cambia solo el modelo para no confundir mejoras de prompt con mejoras del modelo.
Mide resultados de negocio. Registra tasa de éxito, tiempo de corrección humana, errores de herramientas, tokens de entrada y salida, reintentos, latencia y coste por tarea.
Prueba xhigh por separado.xhigh aparece en recopilaciones sobre 4.7 como un nuevo control de esfuerzo, pero no tiene por qué beneficiar todos los flujos. Compáralo aparte de la configuración estándar.
Evalúa visión con material real. Si te importa la lectura de imágenes, usa capturas, diagramas, tablas y documentos parecidos a los de producción, no solo ejemplos limpios.
Conserva un fallback a 4.6. Empieza con poco tráfico, revisa coste y estabilidad, y amplía solo cuando los resultados sean consistentes.
Recomendación final
Para programación avanzada, agentes de larga duración y visión, Claude Opus 4.7 es un candidato de actualización de alta prioridad. La combinación de mejoras reportadas y mismo precio por token lo vuelve especialmente atractivo para quienes ya estaban usando Opus 4.6 en tareas exigentes.
Para usos generales, la recomendación es más prudente: probar, medir y decidir. No actualices solo por el número de versión. Actualiza si tus pruebas muestran mejores resultados en tus propios prompts, datos, restricciones de formato, latencia y costes.
llm-stats.comClaude Opus 4.7 vs Opus 4.6 - LLM Stats
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
verdent.aiClaude Opus 4.7 vs 4.6: Agentic Coding Comparison - Verdent AI
help.apiyi.comClaude Opus 4.7 VS 4.6 Comprehensive Comparison