studioglobal
Discover

Antworten - Seite: 1717 | Entdecken

Entdecken
AlleAntwortenBerichteCodeArbeitsabläufeGalerieTrends
  • Ilustración editorial sobre cómo comprobar el acceso a GPT-5.5 en España en ChatGPT, Codex y la API

    GPT-5.5 in Spanien: So prüfen Sie, ob Ihr Konto schon Zugriff hat

    vor 7 Monaten18 Quellen
  • Editorial illustration for a guide to trying GPT-5.5 in ChatGPT

    GPT-5.5 kostenlos testen: So prüfen Sie den Zugang in ChatGPT

    vor 7 Monaten12 Quellen
  • 抽象比較 Claude Opus 4.7 與 GPT-5.5 在 AI 工作流中的選型差異

    Claude Opus 4.7 vs. GPT-5.5: Benchmarks richtig lesen

    vor 7 Monaten11 Quellen
  • Split-screen editorial illustration comparing Claude Opus 4.7 and GPT-5.5 for coding, agents, research and design

    Claude Opus 4.7 vs. GPT-5.5: Welches KI-Modell passt zu Coding, Agenten, Recherche und Design?

    vor 7 Monaten17 Quellen
  • GPT-5.5の利用可否をChatGPT、Codex、APIで確認するイメージ

    GPT-5.5 jetzt testen: Was in ChatGPT, Codex und API offiziell geht

    vor 7 Monaten15 Quellen
  • 네 개의 AI 모델 벤치마크 점수를 비교하는 추상적인 대시보드 일러스트

    GPT-5.5, Claude Opus 4.7, DeepSeek V4, Kimi K2.6: Benchmark-Sieger nach Aufgabe

    vor 7 Monaten24 Quellen
  • Ilustración editorial de benchmarks de Claude Opus 4.7 con gráficos de rendimiento y código

    Claude Opus 4.7 im Benchmark: Was die 87,6 % in SWE-bench Verified bedeuten

    vor 7 Monaten12 Quellen
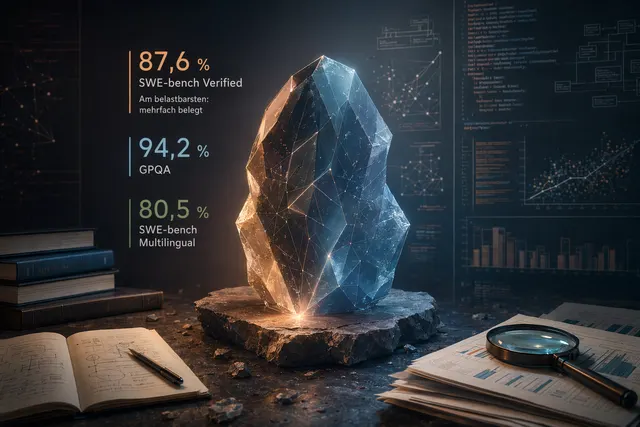
  • Abstrakte Visualisierung von Claude Opus 4.7 Benchmarks mit Diagrammen und Code-Elementen

    Claude Opus 4.7 Benchmarks: SWE-bench, GPQA und Quellencheck

    vor 7 Monaten16 Quellen
  • Ilustración de un panel de benchmark de IA con código y métricas para Claude Mythos Preview

    Claude Mythos Preview: Was 93,9 % in SWE-bench wirklich bedeuten

    vor 7 Monaten17 Quellen
  • Abstrakte KI-Benchmark-Grafik zu Claude Mythos Preview mit Code- und Score-Elementen

    Claude Mythos Benchmarks: 93,9 % SWE-bench – und warum die Scores schwer vergleichbar sind

    vor 7 Monaten17 Quellen
  • Panel comparativo de modelos de IA generativa con Kimi K2.6, DeepSeek V4, GPT-5.5 y Claude Opus 4.7

    Kimi K2.6, DeepSeek V4, GPT-5.5 und Claude Opus 4.7 im Vergleich

    vor 7 Monaten20 Quellen
  • Illustration eines Benchmark-Dashboards für DeepSeek V4, Kimi K2.6, Claude Opus 4.7 und GPT-5.5

    DeepSeek V4, Kimi K2.6, Claude Opus 4.7 und GPT-5.5: Wer gewinnt welche Benchmarks?
    vor 7 Monaten16 Quellen
ZurückWeiter