الإجاباتمنشور16 المصادر
أهم أرقام Claude Opus 4.7… وما مدى الاعتماد عليها؟
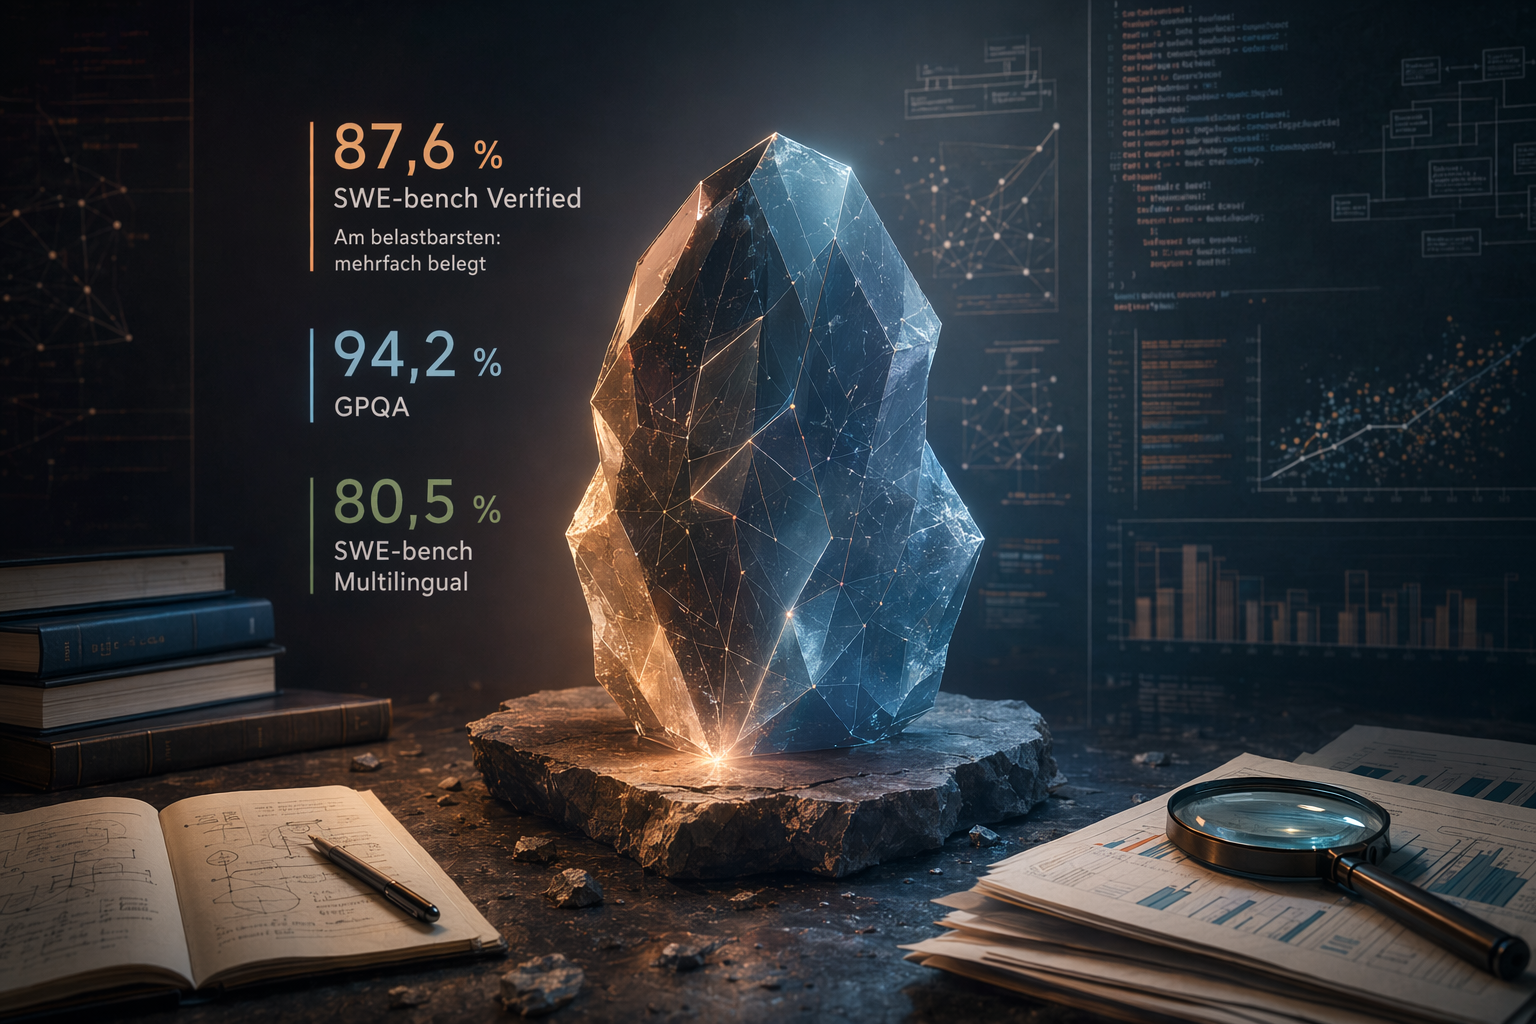
أبرز الأرقام المنشورة لـ Claude Opus 4.7 هي 87.6٪ على SWE bench Verified، و94.2٪ على GPQA، و80.5٪ على SWE bench Multilingual. الرقم الأقوى توثيقاً هو SWE bench Verified لأنه مذكور في أكثر من مصدر متاح، بينما يحتاج رقما GPQA وSWE bench Multilingual إلى قراءة أكثر حذراً.
نشر بواسطةتم التحرير باستخدام GPT-5.5تم إنشاء الصور باستخدام GPT Image 2
إجابة البحث
الوجبات السريعة الرئيسية
- أبرز الأرقام المنشورة لـ Claude Opus 4.7 هي 87.6٪ على SWE bench Verified، و94.2٪ على GPQA، و80.5٪ على SWE bench Multilingual.
- الرقم الأقوى توثيقاً هو SWE bench Verified لأنه مذكور في أكثر من مصدر متاح، بينما يحتاج رقما GPQA وSWE bench Multilingual إلى قراءة أكثر حذراً.
- قرار استخدام النموذج لا ينبغي أن يعتمد على الاختبارات وحدها؛ فنافذة السياق، الرؤية، مستوى xhigh، وتغيّر الـ tokenizer قد تؤثر في التكلفة والأداء الفعلي.
موجّه الذكاء الاصطناعي
openai.comCreate a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre Belastbarkeit. Article summary: Claude Opus 4.7 wird öffentlich mit 87,6 % auf SWE bench Verified, 94,2 % auf GPQA und 80,5 % auf SWE bench Multilingual genannt; am belastbarsten ist der SWE bench Verified Wert, weil er mehrfach belegt ist.. Topic tags: ai, anthropic, claude, llm, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In short: Anthropic has released Claude Opus 4.7, its most capable generally available" source context "Claude Opus 4.7 leads on SWE-bench and agentic reasoning ..." Reference image 2: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In sh
إذا كنت تفاضل بين نماذج الذكاء الاصطناعي لأعمال البرمجة أو الوكلاء الذكيين، فالأرقام وحدها قد تبدو مغرية. لكن في حالة Claude Opus 4.7، الصورة الأدق هي أن هناك ثلاثة أرقام عامة بارزة: 87.6٪ على SWE-bench Verified، و94.2٪ على GPQA، و80.5٪ على SWE-bench Multilingual. الرقم الأكثر صلابة في المصادر المتاحة هو نتيجة SWE-bench Verified، لأنه مذكور بوضوح في أكثر من مصدر.
الأرقام الأساسية في لمحة
| الاختبار | النتيجة المنشورة لـ Claude Opus 4.7 | كيف نقرأها؟ |
|---|---|---|
| SWE-bench Verified |
Studio Global AI
مواصلة البحث الخاص بك
تتضمن هذه الصفحة إجابة مدعومة بالمصدر يمكنك المتابعة داخل Studio Global.
يسأل الناس أيضا
ما هي الإجابة المختصرة على "أهم أرقام Claude Opus 4.7… وما مدى الاعتماد عليها؟"؟
أبرز الأرقام المنشورة لـ Claude Opus 4.7 هي 87.6٪ على SWE bench Verified، و94.2٪ على GPQA، و80.5٪ على SWE bench Multilingual.
ما هي النقاط الأساسية التي يجب التحقق منها أولاً؟
أبرز الأرقام المنشورة لـ Claude Opus 4.7 هي 87.6٪ على SWE bench Verified، و94.2٪ على GPQA، و80.5٪ على SWE bench Multilingual. الرقم الأقوى توثيقاً هو SWE bench Verified لأنه مذكور في أكثر من مصدر متاح، بينما يحتاج رقما GPQA وSWE bench Multilingual إلى قراءة أكثر حذراً.
ماذا يجب أن أفعل بعد ذلك في الممارسة العملية؟
قرار استخدام النموذج لا ينبغي أن يعتمد على الاختبارات وحدها؛ فنافذة السياق، الرؤية، مستوى xhigh، وتغيّر الـ tokenizer قد تؤثر في التكلفة والأداء الفعلي.
المصادر
rabinarayanpatra.comClaude Opus 4.7: Benchmarks, Breaking Changes, Migration Guide | Rabinarayan Patra
llm-stats.comClaude Opus 4.7: Benchmarks, Pricing, Context & What's New
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
binance.comAnthropic Launches Claude Opus 4.7 With Higher ...
almcorp.comClaude Opus 4.7: Pricing, Benchmarks & Context Window - ALM Corp