أقوى رقم مختصر لأداء GPT‑5.5 هو 84.9٪ على GDPval؛ إذ تقول OpenAI إن هذا المعيار يختبر إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.[1] أرقام مثل 73.1٪ على Expert‑SWE أو 80.5٪ على BixBench تقيس مجالات مختلفة، لذلك لا ينبغي مقارنتها مباشرة بنتيجة GDPval.[8][10] للمقارنات الخارجية، يضع Artificial Analysis نموذج GPT‑5.5 في صد...
نشر بواسطةتم التحرير باستخدام GPT-5.5تم إنشاء الصور باستخدام GPT Image 2
أقوى رقم مختصر لأداء GPT‑5.5 هو 84.9٪ على GDPval؛ إذ تقول OpenAI إن هذا المعيار يختبر إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.[1]
أرقام مثل 73.1٪ على Expert‑SWE أو 80.5٪ على BixBench تقيس مجالات مختلفة، لذلك لا ينبغي مقارنتها مباشرة بنتيجة GDPval.[8][10]
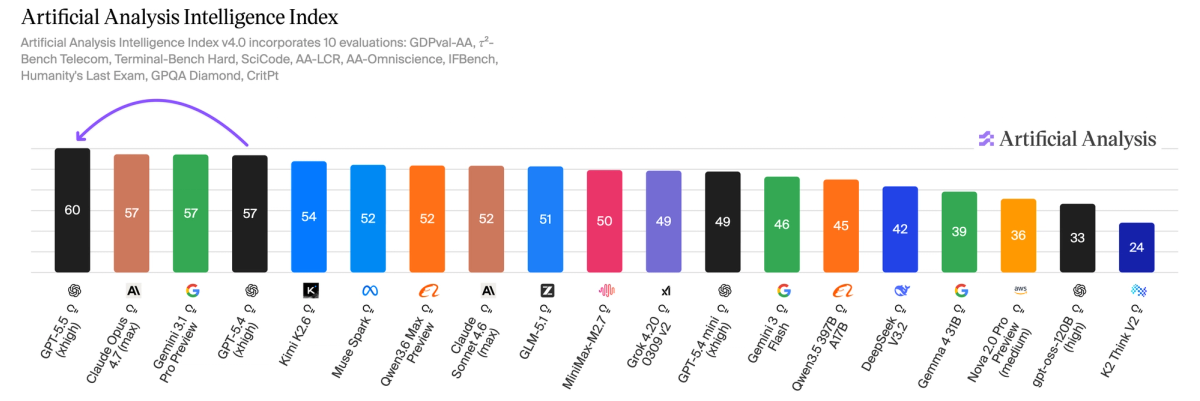
للمقارنات الخارجية، يضع Artificial Analysis نموذج GPT‑5.5 في صدارة مؤشره بفارق 3 نقاط، لكنه لا يعني الفوز في كل اختبار فرعي.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
موجّه الذكاء الاصطناعي
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
إذا أردت إجابة قصيرة عن Benchmark أو اختبار أداء GPT‑5.5، فالرقم الأنظف هو: 84.9٪ على GDPval. تقول OpenAI إن GDPval يقيس قدرة وكلاء الذكاء الاصطناعي على إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.
لكن لا تتعامل مع هذه النسبة كأنها درجة ذكاء عامة أو حكم نهائي على كل استخدامات النموذج. هي تقيس نوعاً معيناً من المهام المهنية والمعرفية، لا البرمجة وحدها، ولا المعلوماتية الحيوية وحدها، ولا كل مؤشرات المقارنة الخارجية.
الرقم الذي يصلح كإجابة مختصرة
الصياغة الأدق عند الحديث العام هي:
يحقق GPT‑5.5، بحسب OpenAI، نتيجة 84.9٪ على GDPval، وهو معيار يختبر إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.
Studio Global AI
مواصلة البحث الخاص بك
تتضمن هذه الصفحة إجابة مدعومة بالمصدر يمكنك المتابعة داخل Studio Global.
ما هي الإجابة المختصرة على "اختبار أداء GPT‑5.5: ماذا تعني 84.9٪ على GDPval؟"؟
أقوى رقم مختصر لأداء GPT‑5.5 هو 84.9٪ على GDPval؛ إذ تقول OpenAI إن هذا المعيار يختبر إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.[1]
ما هي النقاط الأساسية التي يجب التحقق منها أولاً؟
أقوى رقم مختصر لأداء GPT‑5.5 هو 84.9٪ على GDPval؛ إذ تقول OpenAI إن هذا المعيار يختبر إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.[1] أرقام مثل 73.1٪ على Expert‑SWE أو 80.5٪ على BixBench تقيس مجالات مختلفة، لذلك لا ينبغي مقارنتها مباشرة بنتيجة GDPval.[8][10]
ماذا يجب أن أفعل بعد ذلك في الممارسة العملية؟
للمقارنات الخارجية، يضع Artificial Analysis نموذج GPT‑5.5 في صدارة مؤشره بفارق 3 نقاط، لكنه لا يعني الفوز في كل اختبار فرعي.[3]
هذه الجملة مهمة لأنها لا تذكر الرقم وحده، بل تذكر ما يقيسه. واسم GDPval هنا هو اسم معيار تقييم؛ أي أن المقصود ليس رقماً اقتصادياً مباشراً، بل اختبار لأداء النموذج في مهام عمل معرفية محددة.
لماذا لا تكفي النسبة وحدها؟
الخطأ الشائع هو وضع كل النسب في سطر واحد وكأنها جاءت من الامتحان نفسه. في الواقع، كل معيار يسأل سؤالاً مختلفاً:
GDPval يسأل: هل يستطيع النموذج إنتاج مخرجات عمل معرفي محددة بوضوح عبر مجموعة واسعة من المهن؟
Expert‑SWE أقرب إلى تقييم مهام البرمجة وتطوير البرمجيات.
BixBench يدور حول مهام في المعلوماتية الحيوية.
Artificial Analysis Intelligence Index مؤشر خارجي للمقارنة العامة بين النماذج، وليس اختباراً رسمياً واحداً من OpenAI.
لذلك، السؤال الأفضل ليس: أي رقم هو الأعلى؟ بل: أي معيار يشبه استخدامك الفعلي للنموذج؟
أبرز الأرقام المتداولة في سياقها
المعيار أو المقارنة
الرقم المنشور
ماذا يقيس؟
كيف يُقرأ الرقم؟
GDPval
84.9٪
عمل معرفي محدد جيداً عبر 44 مهنة
الرقم مذكور مباشرة في إعلان OpenAI، لذلك هو أنسب إجابة مختصرة عند الحديث العام عن GPT‑5.5.
Expert‑SWE
73.1٪
مهام برمجة؛ ورد أنه تقييم داخلي لمهام يُقدّر إنجازها بنحو 20 ساعة
مهم لمجال تطوير البرمجيات، لكنه لا يقيس الشيء نفسه الذي يقيسه GDPval.
BixBench
80.5٪
معيار واقعي في المعلوماتية الحيوية
مفيد عند الحديث عن هذا المجال تحديداً، مع التنبيه إلى أن توثيقه في المصادر المتاحة هنا ليس مباشراً مثل رقم GDPval المنشور من OpenAI.
Artificial Analysis Intelligence Index
المركز الأول بفارق 3 نقاط
مؤشر خارجي واسع للمقارنة بين النماذج
يعطي صورة مقارنة عامة، لكنه ليس اختباراً رسمياً منفرداً من OpenAI.
ماذا يقول مؤشر Artificial Analysis؟
بحسب Artificial Analysis، يتصدر GPT‑5.5 مؤشر Intelligence Index بفارق 3 نقاط. لكن التفصيل مهم: يذكر المصدر نفسه أن OpenAI تتقدم في خمسة من الاختبارات الرئيسية، بينما تأتي في ثلاثة اختبارات أخرى خلف Gemini 3.1 Pro Preview.
بمعنى آخر، المركز الأول في مؤشر خارجي لا يعني أن النموذج يفوز في كل اختبار فرعي. هو يعني أنه يتصدر وفق طريقة حساب ذلك المؤشر تحديداً.
انتبه للأرقام اللامعة خارج سياقها
تظهر أحياناً أرقام أخرى في العناوين، مثل 91.7٪ في سياق قدرات الذكاء الاصطناعي القانونية، أو 82.7٪ في سياق agentic coding. هذه الأرقام قد تكون مفيدة لمن يهتم بتلك الحالات المتخصصة، لكنها ليست أفضل إجابة عامة عن أداء GPT‑5.5 إذا لم يكن واضحاً ما هو الاختبار، ومن هي مجموعة المقارنة، وما الذي تقيسه النتيجة بالضبط.
أي رقم تقتبس؟
إذا كان الحديث عاماً عن أداء GPT‑5.5، فاقتبس هذا:
GPT‑5.5 يسجل 84.9٪ على GDPval، وهو معيار تقول OpenAI إنه يختبر قدرة الوكلاء على إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.
أما إذا كان سؤالك محدداً، فغيّر المعيار وفق المجال:
العمل المعرفي العام: 84.9٪ على GDPval.
تطوير البرمجيات: 73.1٪ على Expert‑SWE.
المعلوماتية الحيوية: 80.5٪ على BixBench، مع توضيح أن مصدره المتاح هنا أضعف من رقم OpenAI المباشر.
مقارنة عامة بين النماذج: المركز الأول في Artificial Analysis Intelligence Index بفارق 3 نقاط.
الخلاصة
أفضل رقم مختصر يمكن استخدامه عن GPT‑5.5 هو 84.9٪ على GDPval. قوته أنه موثق مباشرة من OpenAI وأن نطاقه واضح: عمل معرفي محدد جيداً عبر 44 مهنة. أما بقية الأرقام، فقد تكون أهم في مجالاتها، لكنها يجب أن تُذكر دائماً مع اسم الاختبار وما يقيسه.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
هذه الجملة مهمة لأنها لا تذكر الرقم وحده، بل تذكر ما يقيسه. واسم GDPval هنا هو اسم معيار تقييم؛ أي أن المقصود ليس رقماً اقتصادياً مباشراً، بل اختبار لأداء النموذج في مهام عمل معرفية محددة.
لماذا لا تكفي النسبة وحدها؟
الخطأ الشائع هو وضع كل النسب في سطر واحد وكأنها جاءت من الامتحان نفسه. في الواقع، كل معيار يسأل سؤالاً مختلفاً:
GDPval يسأل: هل يستطيع النموذج إنتاج مخرجات عمل معرفي محددة بوضوح عبر مجموعة واسعة من المهن؟
Expert‑SWE أقرب إلى تقييم مهام البرمجة وتطوير البرمجيات.
BixBench يدور حول مهام في المعلوماتية الحيوية.
Artificial Analysis Intelligence Index مؤشر خارجي للمقارنة العامة بين النماذج، وليس اختباراً رسمياً واحداً من OpenAI.
لذلك، السؤال الأفضل ليس: أي رقم هو الأعلى؟ بل: أي معيار يشبه استخدامك الفعلي للنموذج؟
أبرز الأرقام المتداولة في سياقها
المعيار أو المقارنة
الرقم المنشور
ماذا يقيس؟
كيف يُقرأ الرقم؟
GDPval
84.9٪
عمل معرفي محدد جيداً عبر 44 مهنة
الرقم مذكور مباشرة في إعلان OpenAI، لذلك هو أنسب إجابة مختصرة عند الحديث العام عن GPT‑5.5.
Expert‑SWE
73.1٪
مهام برمجة؛ ورد أنه تقييم داخلي لمهام يُقدّر إنجازها بنحو 20 ساعة
مهم لمجال تطوير البرمجيات، لكنه لا يقيس الشيء نفسه الذي يقيسه GDPval.
BixBench
80.5٪
معيار واقعي في المعلوماتية الحيوية
مفيد عند الحديث عن هذا المجال تحديداً، مع التنبيه إلى أن توثيقه في المصادر المتاحة هنا ليس مباشراً مثل رقم GDPval المنشور من OpenAI.
Artificial Analysis Intelligence Index
المركز الأول بفارق 3 نقاط
مؤشر خارجي واسع للمقارنة بين النماذج
يعطي صورة مقارنة عامة، لكنه ليس اختباراً رسمياً منفرداً من OpenAI.
ماذا يقول مؤشر Artificial Analysis؟
بحسب Artificial Analysis، يتصدر GPT‑5.5 مؤشر Intelligence Index بفارق 3 نقاط. لكن التفصيل مهم: يذكر المصدر نفسه أن OpenAI تتقدم في خمسة من الاختبارات الرئيسية، بينما تأتي في ثلاثة اختبارات أخرى خلف Gemini 3.1 Pro Preview.
بمعنى آخر، المركز الأول في مؤشر خارجي لا يعني أن النموذج يفوز في كل اختبار فرعي. هو يعني أنه يتصدر وفق طريقة حساب ذلك المؤشر تحديداً.
انتبه للأرقام اللامعة خارج سياقها
تظهر أحياناً أرقام أخرى في العناوين، مثل 91.7٪ في سياق قدرات الذكاء الاصطناعي القانونية، أو 82.7٪ في سياق agentic coding. هذه الأرقام قد تكون مفيدة لمن يهتم بتلك الحالات المتخصصة، لكنها ليست أفضل إجابة عامة عن أداء GPT‑5.5 إذا لم يكن واضحاً ما هو الاختبار، ومن هي مجموعة المقارنة، وما الذي تقيسه النتيجة بالضبط.
أي رقم تقتبس؟
إذا كان الحديث عاماً عن أداء GPT‑5.5، فاقتبس هذا:
GPT‑5.5 يسجل 84.9٪ على GDPval، وهو معيار تقول OpenAI إنه يختبر قدرة الوكلاء على إنتاج عمل معرفي محدد جيداً عبر 44 مهنة.
أما إذا كان سؤالك محدداً، فغيّر المعيار وفق المجال:
العمل المعرفي العام: 84.9٪ على GDPval.
تطوير البرمجيات: 73.1٪ على Expert‑SWE.
المعلوماتية الحيوية: 80.5٪ على BixBench، مع توضيح أن مصدره المتاح هنا أضعف من رقم OpenAI المباشر.
مقارنة عامة بين النماذج: المركز الأول في Artificial Analysis Intelligence Index بفارق 3 نقاط.
الخلاصة
أفضل رقم مختصر يمكن استخدامه عن GPT‑5.5 هو 84.9٪ على GDPval. قوته أنه موثق مباشرة من OpenAI وأن نطاقه واضح: عمل معرفي محدد جيداً عبر 44 مهنة. أما بقية الأرقام، فقد تكون أهم في مجالاتها، لكنها يجب أن تُذكر دائماً مع اسم الاختبار وما يقيسه.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News