答案已發布15 個來源
GPT Image 2 生成繁體中文準嗎?海報、招牌、IG 圖能不能直接用
公開資料顯示 GPT Image 2/ChatGPT Images 2.0 朝多語文字渲染與文字密集視覺改善,但未提供繁體中文商用準確率;可用來起稿,不建議未校對就發布。[9][12][40] 報導中的 Chinese 不等於已證明繁體中文、香港/台灣用字、繁簡不混、小字可讀與平台壓縮後效果都能穩定零錯。 較適合用於 moodboard、構圖、背景、風格探索與低風險草稿;招牌、餐牌、價錢、地址、日期、廣告投放圖仍應逐字對稿並保留可編輯文字層。
發布者使用 GPT-5.5 編輯圖片由 GPT Image 2 生成
研究答案
重點整理
- 公開資料顯示 GPT Image 2/ChatGPT Images 2.0 朝多語文字渲染與文字密集視覺改善,但未提供繁體中文商用準確率;可用來起稿,不建議未校對就發布。[9][12][40]
- 報導中的 Chinese 不等於已證明繁體中文、香港/台灣用字、繁簡不混、小字可讀與平台壓縮後效果都能穩定零錯。
- 較適合用於 moodboard、構圖、背景、風格探索與低風險草稿;招牌、餐牌、價錢、地址、日期、廣告投放圖仍應逐字對稿並保留可編輯文字層。
AI 提示詞
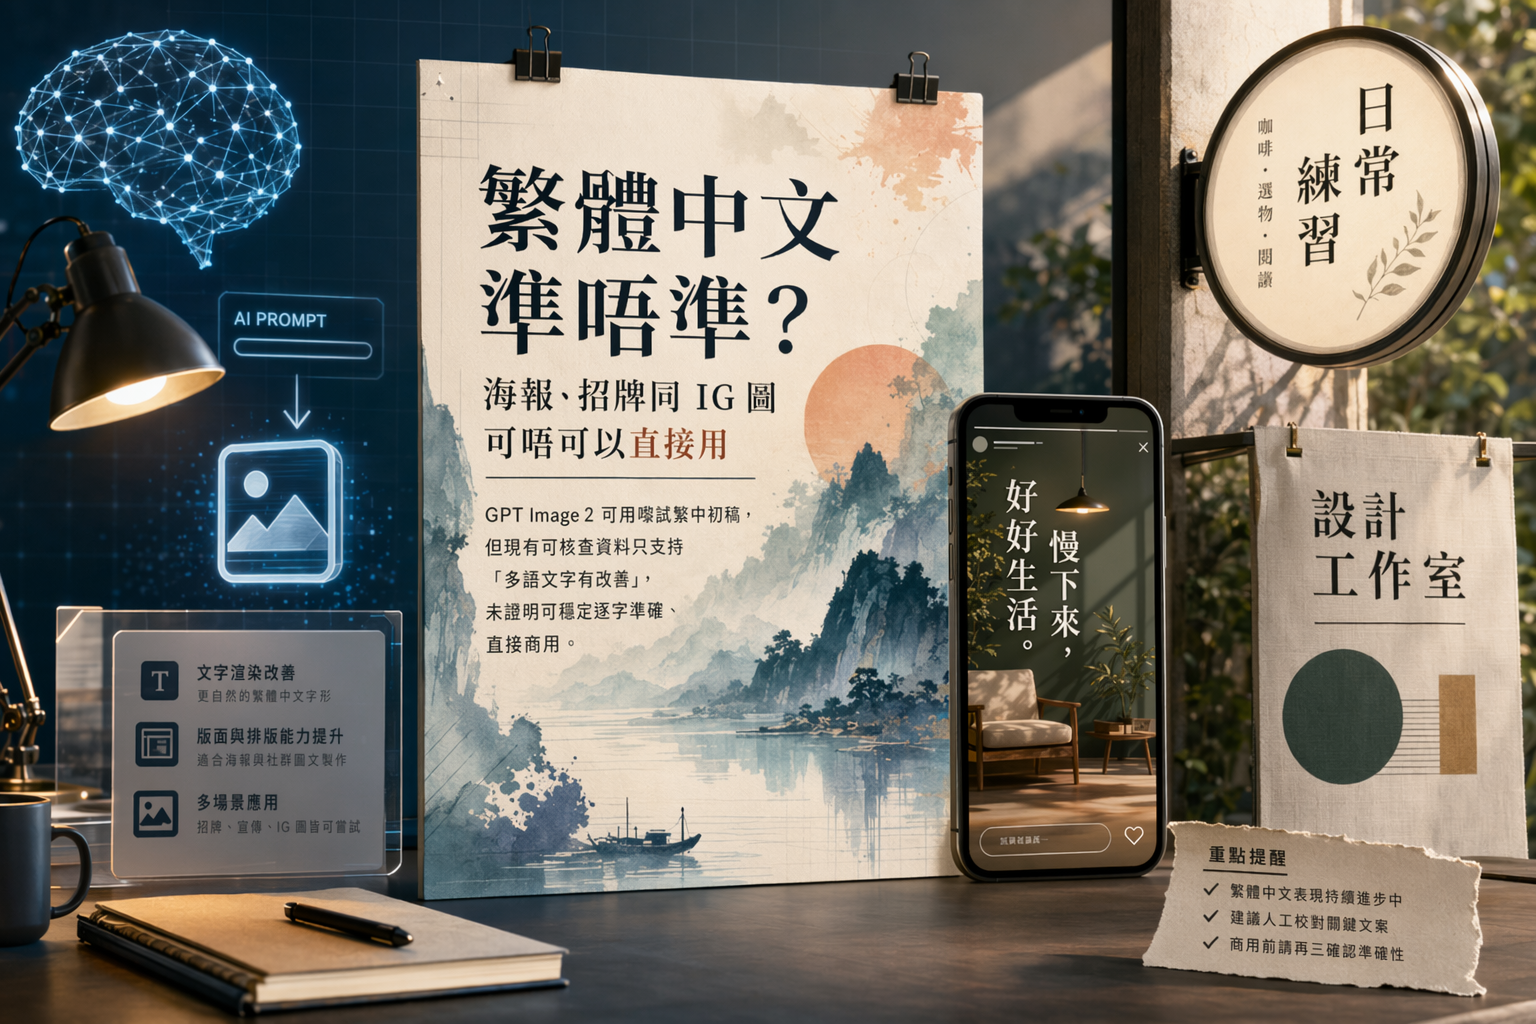
openai.comCreate a landscape editorial hero image for this Studio Global article: GPT Image 2 整繁體中文準唔準?海報、招牌同 IG 圖可唔可以直接用. Article summary: GPT Image 2/ChatGPT Images 2.0 可以用嚟試繁體中文海報、招牌同 IG 圖初稿,但現有可核查資料只支持「多語文字有改善」,未證明繁中可以穩定逐字準確、直接商用。[9][12][40]. Topic tags: ai, openai, gpt image, image generation, traditional chinese. Reference image context from search candidates: Reference image 1: visual subject "#### LIFESTYLE熱門話題. # ChatGPT Images 2.0 重磅升級!從產品海報到 IG 貼文,一句話生出完稿級圖像. 記得2025年第一次用 ChatGPT 畫圖時的驚艷嗎?當時只要輸入幾句話,AI 就能瞬間生出有模有樣的插畫與照片,開啟了全民創作時代。但這一年用下來,當你真的想把它拿來做「可以發出去的東西」,比方說 IG 貼文、活動" source context "ChatGPT Images 2.0 重磅升級!從產品海報到IG 貼文,一句話生出 ..." Reference image 2: visual subject "Stop 用 GPT Images 2 只係生成「一張圖」,佢其實唔止出圖咁簡單, 試咗幾個GPT Images 2新玩法, 例如做 product 圖,以前一定要砌背景、搵 reference、再慢慢排版,, 而家直接出 360 場景,一張圖已經係成個展示空間,product 自然放晒入去。, thumbnail 都係,, 以前要諗幾個方向逐張改,而家" Style: premium digital editorial illustration,
結論先說:可以起稿,不建議一鍵發布
如果你想用 GPT Image 2/ChatGPT Images 2.0 生成含有繁體中文的海報、店面招牌、菜單、價目表或 IG 宣傳圖,最安全的定位是:把它當成視覺概念與初稿工具,而不是最終的繁體中文排版工具。
公開資料確實顯示,ChatGPT Images 2.0 正在強化圖片中的文字能力。OpenAI 官方頁面展示了 ChatGPT Images 2.0 的多語文字渲染範例;OpenAIDevs 貼文摘要指出 gpt-image-2 改善 multilingual text rendering,並強化 diagrams、infographics、charts、comics、multi-panel 等結構化圖片生成;媒體報導也稱新模型能以較高準確度在圖片中生成包括 Chinese 在內的文字,應用情境包含 posters、explainers、diagrams 與 comics。
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「GPT Image 2 生成繁體中文準嗎?海報、招牌、IG 圖能不能直接用」的簡短答案是什麼?
公開資料顯示 GPT Image 2/ChatGPT Images 2.0 朝多語文字渲染與文字密集視覺改善,但未提供繁體中文商用準確率;可用來起稿,不建議未校對就發布。[9][12][40]
最值得優先驗證的重點是什麼?
公開資料顯示 GPT Image 2/ChatGPT Images 2.0 朝多語文字渲染與文字密集視覺改善,但未提供繁體中文商用準確率;可用來起稿,不建議未校對就發布。[9][12][40] 報導中的 Chinese 不等於已證明繁體中文、香港/台灣用字、繁簡不混、小字可讀與平台壓縮後效果都能穩定零錯。
接下來在實務上該怎麼做?
較適合用於 moodboard、構圖、背景、風格探索與低風險草稿;招牌、餐牌、價錢、地址、日期、廣告投放圖仍應逐字對稿並保留可編輯文字層。
來源
openai.comIntroducing ChatGPT Images 2.0
x.comText-heavy visuals get more practical. gpt-image-2 improves ...
timesofindia.indiatimes.comOpenAI launches ChatGPT Images 2.0 with improved text rendering: Availability, price and more - The Times of India
developers.openai.comGPT Image 1 Model | OpenAI API