答案已發布16 來源
Puffin-World:AI 唔止識生成畫面,仲要知道鏡頭喺 3D 世界點樣郁
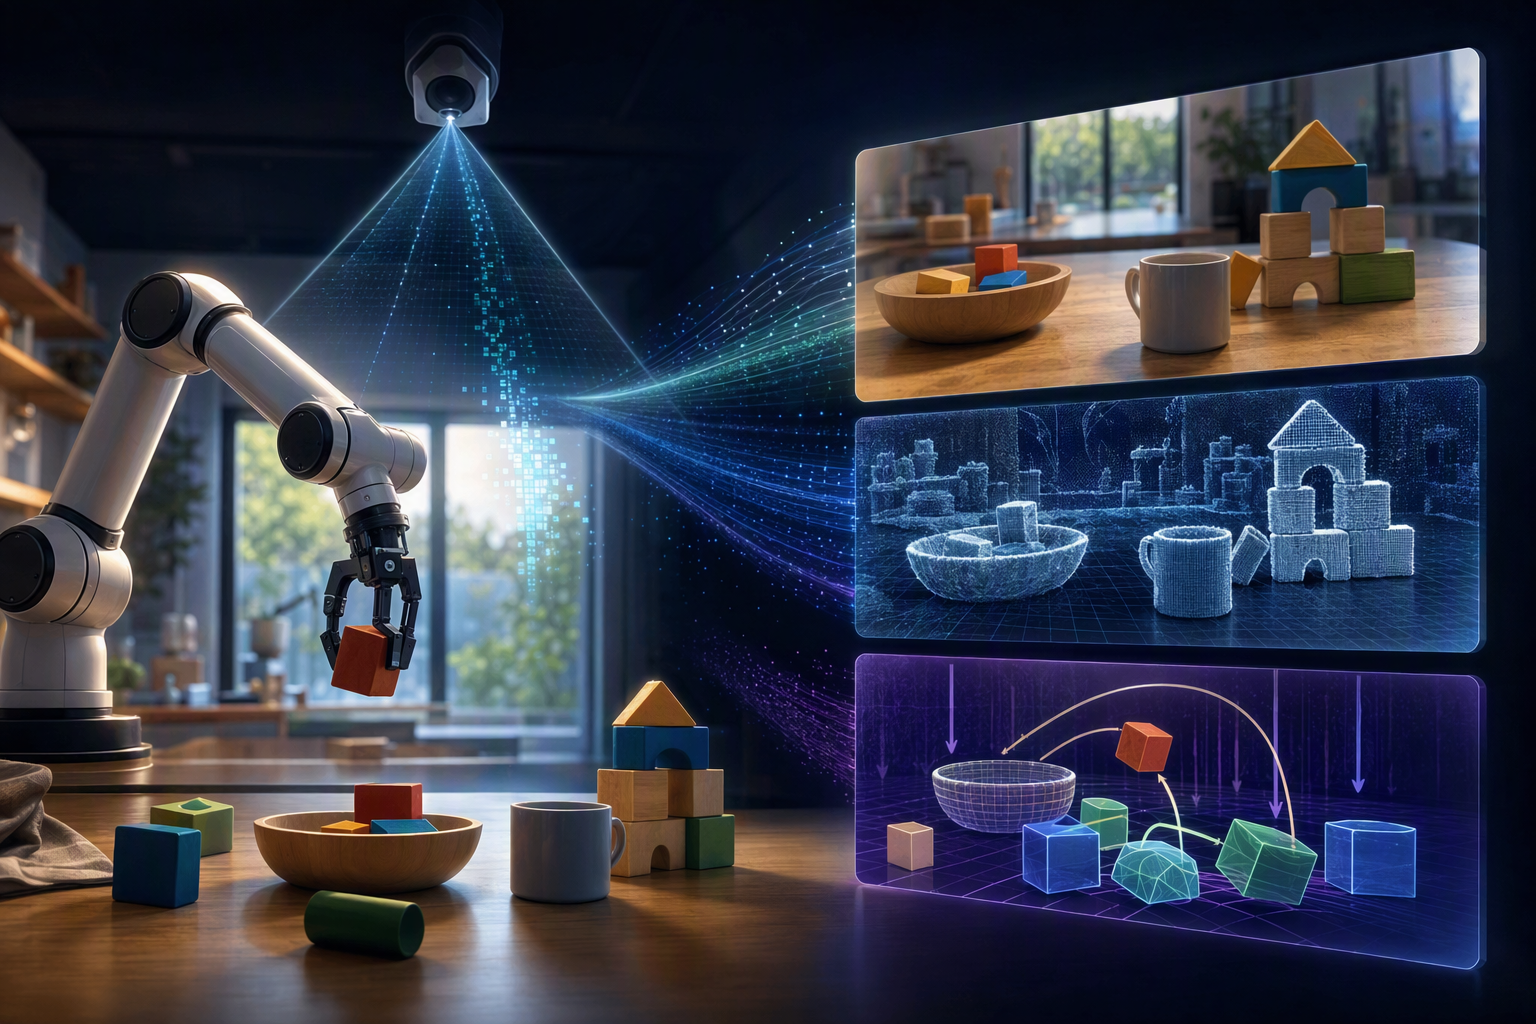
Puffin World 將物理、幾何同外觀視為三種原生 3D 狀態:分別以重力及緯度、密集深度、RGB 影像表示。 核心 Omni Camera 為 9 通道相機條件,結合以重力為錨點的絕對視角資訊與基於光線的相對幾何,令鏡頭移動同旋轉有一致參照。
發布者使用 GPT-5.6 Terra 編輯圖片由 GPT Image 2 生成
研究答案
重點
- Puffin World 將物理、幾何同外觀視為三種原生 3D 狀態:分別以重力及緯度、密集深度、RGB 影像表示。
- 核心 Omni Camera 為 9 通道相機條件,結合以重力為錨點的絕對視角資訊與基於光線的相對幾何,令鏡頭移動同旋轉有一致參照。
- 團隊公開程式碼、3 個模型檢查點及 Puffin 16M;作者報稱其在多個相機姿態基準測試取得領先結果。
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Puffin-World, the open-source multimodal world model developed by ACE Robotics, NTU S-Lab, Beijing Jiaotong University, and the Univ. Article summary: Puffin-World is an open-source, camera-centric multimodal world model that treats a world not merely as RGB video, but as three jointly modeled native states: gravity-aware physics, dense 3D geometry, and visual appearan. Topic tags: general, academic, general web. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake num
一段 AI 生成影片可以睇落好真,但當鏡頭一轉,地平線會唔會歪、視角有冇跟住漂移、物件喺 3D 空間係咪仍然對得上,先係難題。Puffin-World 想處理嘅正正係呢一層:唔只生成 RGB 畫面,而係將鏡頭同世界之間嘅物理方向、深度結構同視覺外觀一齊建模。 1
5
Puffin-World 由 ACE Robotics、南洋理工大學 S-Lab、北京交通大學及密歇根大學相關研究人員推出,並以開源形式發佈。它是一個以相機為中心的多模態世界模型,可在同一框架內理解、模擬、生成及重建 3D 場景。 1
5
重點唔係「畫得似」,而係世界要對得準
Puffin-World 將 3D 世界拆成三個互相連接嘅原生狀態:
換句話講,模型除咗要知道「畫面有咩」,亦要理解相機相對重力嘅方向,以及當相機移動時,應該由乜嘢位置同角度望返同一個場景。呢種設計主要針對連續生成不同視角時常見嘅地平線、重力方向或相機姿態漂移問題。 5
6
Omni-Camera:9 通道條件點樣將相機釘喺世界座標?
Puffin-World 嘅關鍵表示法叫 Omni-Camera。佢係一個 9 通道、密集式嘅相機條件表示,結合兩類資訊: 5
- 重力感知嘅絕對透視場:為相機提供相對物理世界嘅固定參照,包括相機相對重力嘅方向;
- 基於光線嘅相對幾何:描述視點之間嘅旋轉、平移、相機內參,以及複合式移動。
系統會由參考畫面推斷重力方向,再沿住指定鏡頭軌跡傳遞呢個重力資訊。官方所述目的,是令生成出嚟嘅新視角維持喺同一個物理座標框架,減少按幀或按視角順序生成時出現嘅「天地倒轉」或地平線飄移。 5
6
一個模型可以做咩?
單張相推斷相機姿態
只靠一張影像,理解分支可預測相機嘅絕對滾轉角(roll)、俯仰角(pitch)及垂直視場角(vertical FoV);之後可轉換成模型所需嘅重力及透視場資訊。 5
呢點對一般讀者嚟講,可以理解成:AI 唔只認到相入面有建築物或房間,仲嘗試判斷張相係咪影斜咗、鏡頭望緊上定向下,以及鏡頭到底有幾廣角。
指定鏡頭路線,生成自由視點畫面
Puffin-World 支援由文字提示加相機控制生成畫面,亦可以由輸入影像加指定鏡頭軌跡,模擬新視角。可控制項目包括旋轉、平移、內參,以及同時混合多種動作嘅軌跡;旋轉涵蓋 roll、pitch 同 yaw。 5
一次過產生 RGB 同深度,再重建 3D 場景
模型沿軌跡聯合生成 RGB 影像同深度資料,即 RGB-D 視圖。之後可將呢啲結果整合成帶顏色嘅 3D 點雲,而唔需要另外交畀獨立、離線嘅幾何重建流程處理。 5
閉環探索與自我校準示範
公開版本包括模仿探索(mimic exploration)及自我校準示範。文件稱,重力感知座標框架可用作重新錨定生成軌跡,限制姿態不一致隨時間累積。值得留意嘅係,公開資料未完整交代漂移修正控制迴路嘅演算法細節,所以較準確嘅講法是:團隊展示咗相關能力,而唔係已經公開咗完整控制機制。 5
6
架構:視覺理解加擴散式多視角生成
Puffin-World 結合咗幾個組件:幾何對齊嘅 C-RADIO 視覺編碼器、Qwen 語言模型、SD3.5 擴散生成器,以及輕量連接器。架構將自回歸式嘅相機與物理理解,同擴散式嘅多視角 RGB-D 生成分工處理,但保留喺同一個系統之內。 5
公開發佈列出 3 個檢查點:
- Puffin-World-Base:Qwen2.5-7B、C-RADIOv3-H、SD3.5-medium;
- Puffin-World-Pro:Qwen2.5-1.5B、C-RADIOv4-H、SD3.5-large;
- Puffin-World-Caption:Qwen3.5-0.8B、C-RADIOv3-H,集中處理物理描述與相機理解。
5
程式碼、模型、訓練與評估指引、數據集建構文件及數據集均已隨發佈公開。 5
Puffin-16M:大規模、帶相機資訊嘅訓練數據
Puffin-16M 約有 1,650 萬個樣本,由兩部分構成。 14
Puffin-Cam-15M 約有 1,500 萬組「視覺—語言—相機」三元組,從約 90 萬張全景圖渲染而成。其相機設定涵蓋 −45° 至 +45° 嘅 roll 與 pitch,垂直 FoV 則由 20° 至 105°。 5
另一部分 Puffin-Traj-1M 提供 100 萬條較具挑戰性嘅相機軌跡,包括長軌跡、極端旋轉,以及 pitch、yaw、roll 混合嘅複合動作。不過,現有公開材料未提供各種動作類別嘅可靠數量分布。 5
11
資料亦支持數據涵蓋室內、室外、真實及合成影像,但未有足夠資料證實各場景類別嘅精確比例。 7
為 28 個公開數據集補上相機姿態標註
團隊亦用 Puffin-World 為 28 個公開數據集加上絕對 roll、pitch 及垂直 FoV 估計:當中包括 22 個單張影像數據集,以及 6 個連續或 3D 數據集,合共約 4,450 萬項相機標註。論文指,呢批標註反映多個數據集存在「相機大多保持水平」嘅偏差、通常向下望嘅 pitch,以及相當大嘅 FoV 差異。 1
意義在於,若世界模型只知道兩個視角之間「郁咗幾多」,仍未必知道相機相對重力或共同世界座標實際朝向邊度;而絕對相機資訊正補上呢個缺口。
基準成績:表現由作者報告,仍待獨立驗證
項目方報稱,在 Stanford2D3D、MegaDepth、TartanAir 及 LaMAR 四個相機到世界座標基準中,Puffin-World 在 12 項中位誤差比較全部最佳;連同並列計算,36 項 AUC 指標中有 33 項最佳。呢啲都係作者自行報告嘅結果,所提供來源未見獨立重現。 5
部分數字包括:
- Stanford2D3D:roll 中位誤差 0.29°、pitch 0.53°、垂直 FoV 1.62°。
1
- roll 誤差:MegaDepth 為 0.28°、TartanAir 為 0.31°、LaMAR 為 0.26°。
- RealEstate10K 世界模型測試:17.22 PSNR、0.318 LPIPS。
- 重力傳播消融測試:PSNR 由 19.87 升至 20.54,LPIPS 由 0.23 降至 0.21,並報告 roll 與 pitch 誤差亦有改善。
- 挑戰軌跡基準:roll 中位誤差 0.80°,pitch 中位誤差 1.10°。
團隊亦報告 Puffin-Cam-Bench 嘅相機控制效果,包括上方向、緯度與重力相關嘅低誤差。值得審慎看待嘅係,一份項目摘要提到重力誤差為 1.32°,README 則採用另一個重力指標;現有資料未足以確認兩者評估定義一致,因此唔應直接比較。 4
5
佢未係完整物理模擬器
Puffin-World 所講嘅「物理」,主要係重力同緯度,而唔係完整模擬物件碰撞、力學互動或所有動態環境。發佈內容主要針對靜態場景,亦未聲稱能處理長時間尺度嘅複雜動態。 5
所以較恰當嘅定位是:Puffin-World 係令視覺世界模型更有空間一致性、亦更貼近物理參照嘅一步;佢距離能模擬所有現實變化嘅通用世界模擬器,仲有一段路。
Studio Global AI
繼續你的研究
此頁麵包含一個有來源支援的答案,您可以在 Studio Global 內繼續。
人們還問
「Puffin-World:AI 唔止識生成畫面,仲要知道鏡頭喺 3D 世界點樣郁」的簡短答案是什麼?
Puffin World 將物理、幾何同外觀視為三種原生 3D 狀態:分別以重力及緯度、密集深度、RGB 影像表示。
首先要驗證的關鍵點是什麼?
Puffin World 將物理、幾何同外觀視為三種原生 3D 狀態:分別以重力及緯度、密集深度、RGB 影像表示。 核心 Omni Camera 為 9 通道相機條件,結合以重力為錨點的絕對視角資訊與基於光線的相對幾何,令鏡頭移動同旋轉有一致參照。
接下來在實務上我該做什麼?
團隊公開程式碼、3 個模型檢查點及 Puffin 16M;作者報稱其在多個相機姿態基準測試取得領先結果。
來源
kangliao929.github.ioPuffin-World · Scaling with Native 3D World States