答案已發布26 來源
AI 代理取代人類上網,點擊經濟仲行得通嗎?
Parag Agrawal 認為,當 AI 代理取代人類成為網絡主要使用者,廣告曝光同點擊就未必再足以支撐出版商。 Parallel Web Systems 於 2026 年 4 月完成 1 億美元 B 輪融資,公司估值據報達 20 億美元;此前 2025 年 11 月完成 1 億美元 A 輪,估值 7.4 億美元。
發布者使用 GPT-5.6 Luna 編輯圖片由 GPT Image 1.5 生成
研究答案
重點
- Parag Agrawal 認為,當 AI 代理取代人類成為網絡主要使用者,廣告曝光同點擊就未必再足以支撐出版商。
- Parallel Web Systems 於 2026 年 4 月完成 1 億美元 B 輪融資,公司估值據報達 20 億美元;此前 2025 年 11 月完成 1 億美元 A 輪,估值 7.4 億美元。
- Parallel 的 Index 讓內容擁有人了解 AI 代理點樣使用其內容,並以 Shapley value 估算每個來源對 AI 輸出的增量貢獻,再作為補償參考。
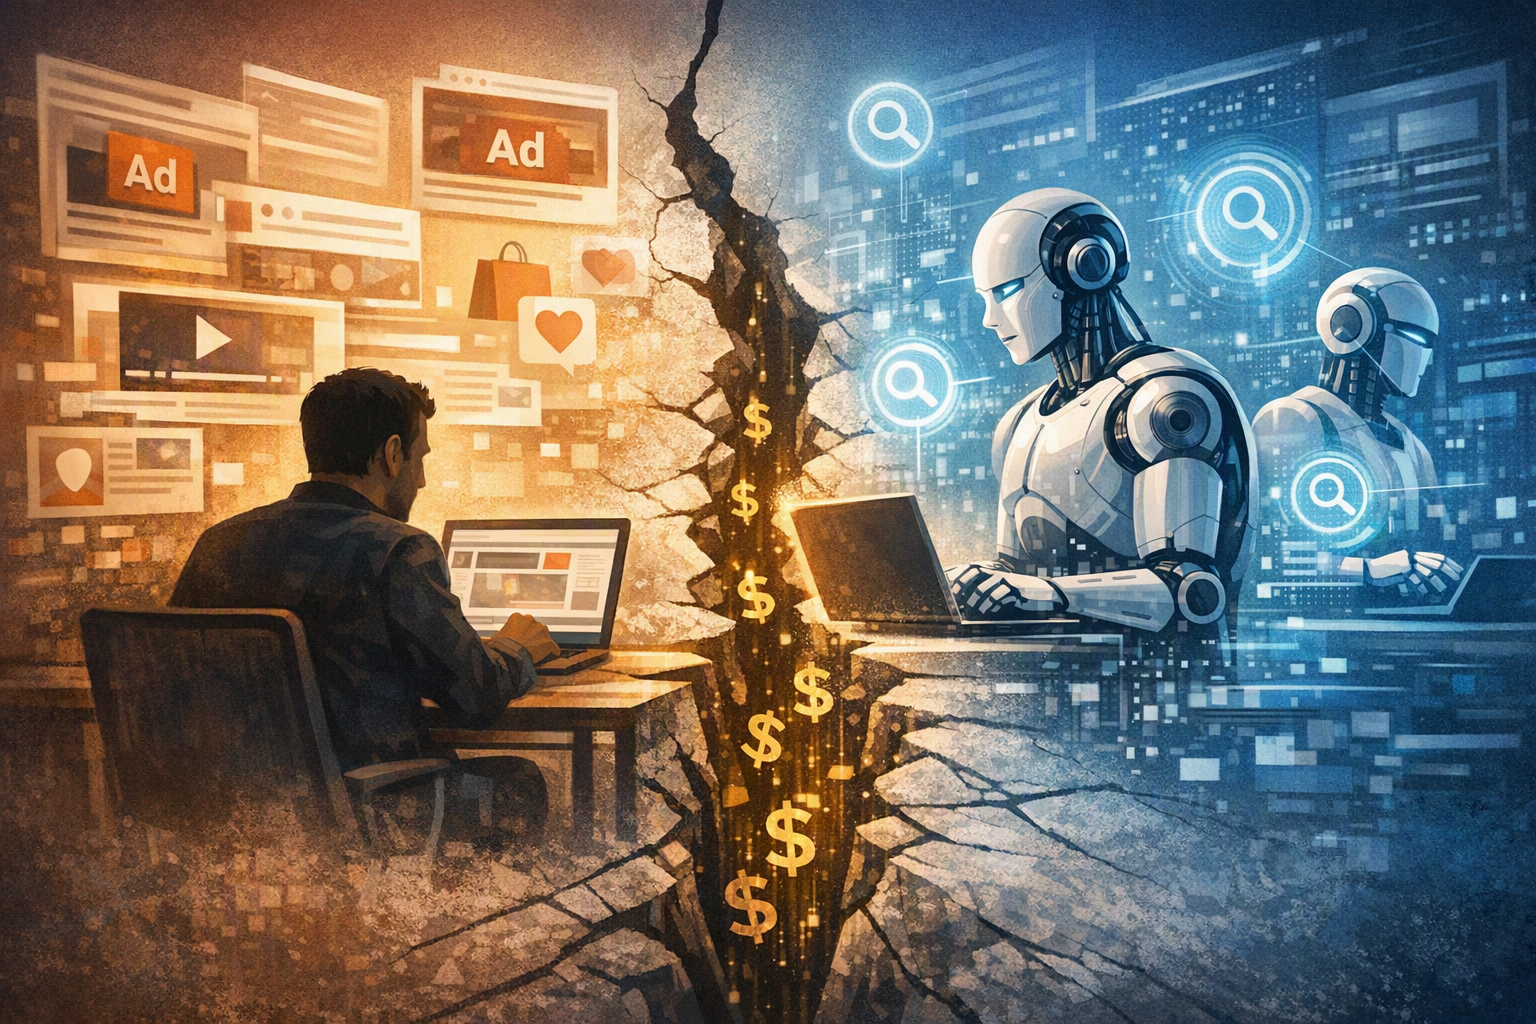
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: What is former Twitter CEO Parag Agrawal’s argument that the internet’s advertising- and click-based business model cannot survive if AI age. Article summary: Agrawal’s central claim is that a web funded by human attention breaks when AI agents, rather than people, do most of the reading and searching. Agents do not view ads, develop brand preferences, or produce meaningful cl. Topic tags: general, news, general web, user generated, documentation. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, water
Parag Agrawal 的核心論點其實好直接:現時網絡的生意模式,係圍繞人類注意力建立——人搜尋、撳入網站、睇廣告,出版商就可以靠流量同廣告收入維持運作。
但如果將來最常上網的唔係人,而係 AI 代理呢?AI 代理可以一次過搜尋大量來源,擷取重點、互相比較,再直接將整理好的答案交畀用戶。原本提供資料的網站,可能完全收唔到一次人類點擊,亦未必有廣告曝光。Agrawal 認為,當呢種使用方式成為主流,傳統以點擊計算價值的網絡經濟就會出現根本問題。14
44
Agrawal 目前創辦的 Parallel Web Systems,正正係想為 AI 代理打造一層新的網絡基礎設施。佢哋稱之為網絡的「第二位使用者」:唔係要即刻取代面向人類的網站,而係在現有網絡之上,加入一套適合 AI 代理搜尋、擷取資料、研究、追蹤來源同付款的系統。40
47
點解點擊可能唔再代表價值?
對人類使用者而言,網絡價值鏈相對容易睇到:有人搜尋,撳入搜尋結果,閱讀文章,見到廣告,之後可能記住某個出版品牌,或者再次回訪。於是「點擊」同時扮演兩個角色:一方面帶來流量同廣告收入,另一方面亦俾搜尋系統用作判斷相關性。
AI 代理的行為就完全唔同。佢可能同時查閱幾十個來源,只抽取幾段相關內容,再整合成一個答案,最後由代理直接回覆用戶。原始頁面可能完全冇人類訪客。
咁樣一來,點擊就未必反映一個來源真正做過幾多功課:一篇文章可能提供咗關鍵事實、驗證咗一個結論,或者令整個研究任務成功,但最後冇人撳入去。Agrawal 認為,網絡需要量度的,應該係一份資料對 AI 代理完成任務有幾有用,而唔係單純計算有冇人撳條連結。
Parallel 的說法係,AI 代理將來使用網絡的頻率可能達到人類的「1,000 倍」。呢個數字係公司的核心預測,而唔係已經獲得廣泛驗證的行業共識。14
「平行網絡」究竟想改變甚麼?
Parallel 所講的「平行網絡」,比較似係一層面向 AI 代理的基礎設施,而唔係另起一個完全獨立、同人類網站互不相干的互聯網。
公司的 API 涵蓋網絡搜尋、內容擷取、深度研究、實體搜尋、聊天及持續監察等功能,目的係令 AI 代理可以更有效率地使用網絡資料。25
傳統網絡系統慣常將注意力、連結數量同點擊,當作判斷相關性的實用指標。Agent-native 系統就可能改問以下問題:
- 呢個來源有冇幫代理搵到準確答案?
- 佢有冇協助完成一個研究任務?
- 佢有冇釐清某個人物、公司或者事實?
- 佢有冇支援一個決策或者工作流程?
- 佢有冇改善最後交付畀用戶的答案?
換句話講,來源的價值唔再只係「多人睇」或者「多人撳」,而係取決於佢對某一項具體任務有幾大幫助。Parallel 亦形容,直接收集 AI 代理對資料是否有用的回饋,可以取代主要依賴人類點擊數據去排序同建立索引的做法。44
45
不過,呢個仍然係 Parallel 的公司理念同產品方向,並唔係整個網絡已經採用的標準。要真正普及,出版商、內容擁有人、AI 代理開發者、搜尋服務商同其他基礎設施公司都要一齊參與。
用 Shapley value 計算出版商應得幾多?
Parallel 提出的補償模式,建基於 Shapley value——可以簡單理解為:幾個來源一齊完成一個結果時,計算每個來源到底增加咗幾多價值。
套用到網絡內容,就係問:在其他資料都可用的情況下,某一個來源對 AI 代理成功完成任務,究竟作出咗幾大貢獻?
例如,一個來源提供咗其他地方冇有的關鍵資料,或者令最後答案出現重大改變,理論上就應該比單純重複其他來源內容的網站得到更多功勞。16
29
呢個概念希望將內容補償由「帶來幾多流量」或者「一口價授權費」,轉向「對結果作出幾多邊際貢獻」。但實際執行仍然有幾多難題:
- 點樣定義一個 AI 任務算唔算成功?
- 點樣用一致方法計算每個來源的貢獻?
- 點樣避免內容擁有人或者 AI 系統操控評分?
- 點樣令不同平台之間的計算結果可以互相比較?
現有資料只顯示,Shapley value 係一個正在提出的設計方向,未足以證明佢可以取代現行廣告模式。
Index 點樣支援呢套模式?
Index 係 Parallel 面向出版商、資料供應商同獨立創作者的一部分。Parallel 表示,Index 會讓內容擁有人了解 AI 代理點樣使用佢哋的資料,包括:內容回答咗邊啲查詢、被引用幾頻密,以及對代理完成任務有幾獨特的貢獻。29
之後,系統會根據估算出來的 Shapley value,將補償同來源的實際貢獻掛鈎。理想情況下,即使冇人類使用者撳入一篇文章,只要文章對 AI 代理產生了有用、不可取代的資訊,內容擁有人仍然有機會獲得回報。
Index 的推出夥伴包括 The Atlantic、Fortune 及 PR Newswire,亦包括 PitchBook、Enigma、RocketReach、ZoomInfo 等商業及資料情報供應商,以及部分獨立創作者。6
所以,Index 想同時處理兩個問題:第一係「出版商睇唔睇到 AI 點樣用佢哋的內容」;第二係「如果冇點擊,內容又應該點樣得到報酬」。
Parallel 融資幾多?有邊啲客戶?
Parallel 於 2024 年 1 月完成 3,000 萬美元種子輪融資。2025 年 11 月,公司宣布完成 1 億美元 A 輪,當時據報估值為 7.4 億美元,由 Kleiner Perkins 及 Index Ventures 共同領投。11
33
到 2026 年 4 月,公司再完成 1 億美元 B 輪,由 Sequoia Capital 領投,據報估值升至 20 億美元。Kleiner Perkins、Index Ventures、Khosla Ventures、First Round、Spark、Terrain 及 Abstract 等現有投資者亦有參與。1
10
15
Parallel 的公開資料將公司定位為 AI 代理產品的搜尋及研究 API 供應商。A 輪公布時,公司列出 Clay、Sourcegraph 及 Owner 等企業作為客戶或使用者。40
不過,現有資料未能證實一份完整客戶名單,亦未有足夠獨立證據確認實際開發者數目。因此,所謂「有幾多開發者使用」仍然唔應該講得過分肯定。
點解 Google Cloud 合作咁重要?
Parallel 亦已經成為 Google Cloud 客戶建立企業 AI 代理時,可以選用的搜尋及 grounding 方案之一。據報,相關整合讓開發者在使用 Google 的 Gemini 相關代理工具時,可以將 Parallel Search 同 Google Search 一齊作為網絡 grounding 選項。12
對 Parallel 而言,呢個合作提供咗一條通往大型企業客戶的分發渠道。企業正逐步測試可以自行研究資料、處理多個子任務及執行工作流程的 AI 代理,而 Google Cloud 本身就掌握龐大企業客戶網絡。
但雙方亦存在策略上的微妙關係:Google 既係重要合作夥伴,同時亦擁有自己的搜尋及 AI 基礎設施。因此,Parallel 既可以借助 Google Cloud 擴大接觸面,亦要面對一個可能同自己競爭的主要平台。5
12
點解 Agrawal 預期 12 至 24 個月內出現轉變?
Agrawal 所講的 12 至 24 個月,係一項預測,唔係客觀量度出來的行業共識。
背後的押注主要有三部分:模型能力持續提升、AI 代理使用工具及拆解任務的能力變得成熟,以及企業可以透過現有雲端平台同 API 更容易部署代理。對一個人類請求而言,AI 代理可以自行發出大量搜尋,再逐步完成多個子任務。
如果 AI 代理開始產生遠多於人類的網絡查詢,但回傳的是整合好的答案,而唔係將流量逐一送到每個原始網站,點擊經濟所受的壓力,可能會早過一般消費者改變日常上網習慣之前出現。
不過,Parallel 所講的「1,000 倍」仍然應該視為公司的信念同預期,而唔係已經證實的未來數字。14
最大的不確定性:邊個來定義「有價值」?
Agrawal 其實唔係宣布現行廣告模式已經壽終正寢,而係提出一個假設:如果 AI 代理將來成為人類接觸網絡資料的主要介面,單靠點擊可能唔再足以支撐搜尋排序、內容創作同出版商收入。
Index、代理回饋同 Shapley-based compensation,提供咗一個可能方向——按照內容對 AI 輸出的實際貢獻,重新分配資訊價值。但呢套模式仍然要解決歸因、付款標準、防止操控,以及不同平台能否共同採用等問題。
所以,Parallel 最強的版本並非「廣告模式明日就會消失」,而係一個有條件的預測:如果 AI 代理真的成為網絡的主要使用者,網絡的經濟訊號可能會由人類點擊,轉向代理任務結果、來源可追溯性,以及對可量度資訊貢獻的付款。
Studio Global AI
繼續你的研究
此頁麵包含一個有來源支援的答案,您可以在 Studio Global 內繼續。
人們還問
「AI 代理取代人類上網,點擊經濟仲行得通嗎?」的簡短答案是什麼?
Parag Agrawal 認為,當 AI 代理取代人類成為網絡主要使用者,廣告曝光同點擊就未必再足以支撐出版商。
首先要驗證的關鍵點是什麼?
Parag Agrawal 認為,當 AI 代理取代人類成為網絡主要使用者,廣告曝光同點擊就未必再足以支撐出版商。 Parallel Web Systems 於 2026 年 4 月完成 1 億美元 B 輪融資,公司估值據報達 20 億美元;此前 2025 年 11 月完成 1 億美元 A 輪,估值 7.4 億美元。
接下來在實務上我該做什麼?
Parallel 的 Index 讓內容擁有人了解 AI 代理點樣使用其內容,並以 Shapley value 估算每個來源對 AI 輸出的增量貢獻,再作為補償參考。