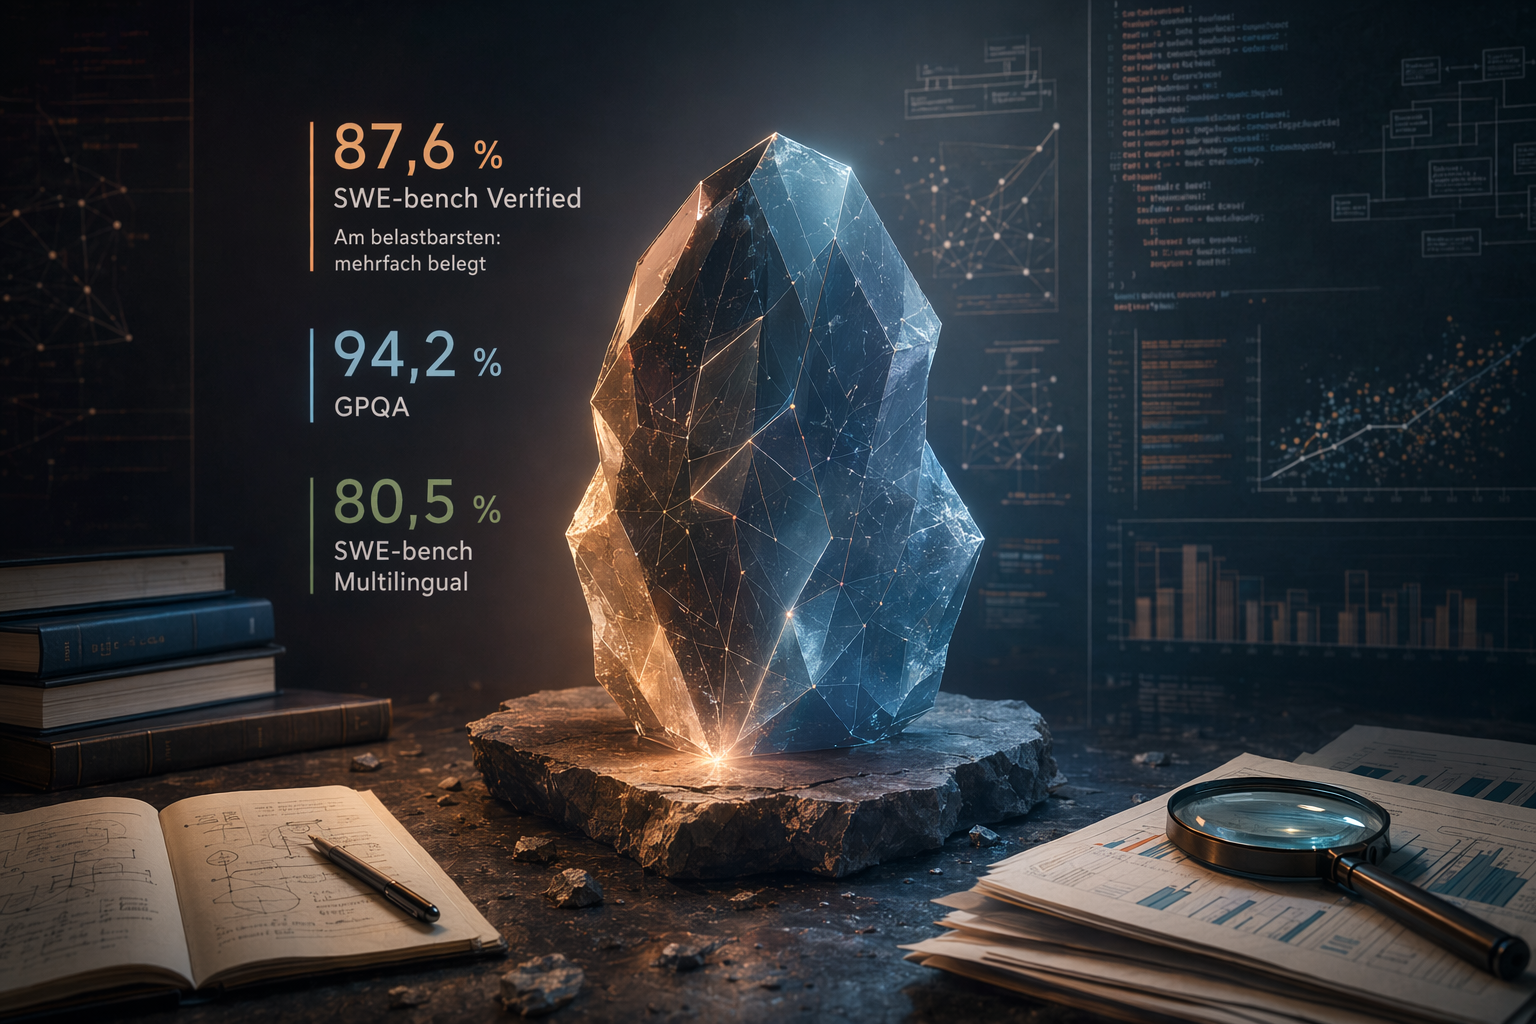
Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre BelastbarkeitAI-generierte Illustration zu den öffentlichen Benchmark-Werten von Claude Opus 4.7.
AI 提示
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre Belastbarkeit. Article summary: Claude Opus 4.7 wird öffentlich mit 87,6 % auf SWE bench Verified, 94,2 % auf GPQA und 80,5 % auf SWE bench Multilingual genannt; am belastbarsten ist der SWE bench Verified Wert, weil er mehrfach belegt ist.. Topic tags: ai, anthropic, claude, llm, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In short: Anthropic has released Claude Opus 4.7, its most capable generally available" source context "Claude Opus 4.7 leads on SWE-bench and agentic reasoning ..." Reference image 2: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In sh
openai.com
先講結論:三個數字,但可信度唔同
如果只想快速掌握 Claude Opus 4.7 的公開 benchmark,現時最清晰可以歸納為三個數字:SWE-bench Verified 87.6%、GPQA 94.2%、SWE-bench Multilingual 80.5%。當中,SWE-bench Verified 87.6% 是最穩陣的參考點,因為有多個公開來源提到同一個數字。
不過,benchmark 唔等於實際生產表現。尤其係團隊要揀模型、做 API 遷移、或者將 AI agent 放入真實軟件工程流程時,分數只係第一層篩選,最後仍然要靠自己 repo、自己工具鏈、自己驗收標準去試。
「Claude Opus 4.7 benchmark 點睇:SWE-bench、GPQA 同來源可信度」的簡短答案是什麼?
Claude Opus 4.7 目前公開可見的核心 benchmark 包括 SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%;其中 SWE bench Verified 來源支撐最強。[4][5][9]
首先要驗證的關鍵點是什麼?
Claude Opus 4.7 目前公開可見的核心 benchmark 包括 SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%;其中 SWE bench Verified 來源支撐最強。[4][5][9] GPQA 同 SWE bench Multilingual 都有參考價值,但在現有資料中確認來源較少,做採購、遷移或生產模型選型時要保守解讀。
Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre BelastbarkeitAI-generierte Illustration zu den öffentlichen Benchmark-Werten von Claude Opus 4.7.
AI 提示
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre Belastbarkeit. Article summary: Claude Opus 4.7 wird öffentlich mit 87,6 % auf SWE bench Verified, 94,2 % auf GPQA und 80,5 % auf SWE bench Multilingual genannt; am belastbarsten ist der SWE bench Verified Wert, weil er mehrfach belegt ist.. Topic tags: ai, anthropic, claude, llm, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In short: Anthropic has released Claude Opus 4.7, its most capable generally available" source context "Claude Opus 4.7 leads on SWE-bench and agentic reasoning ..." Reference image 2: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In sh
openai.com
先講結論:三個數字,但可信度唔同
如果只想快速掌握 Claude Opus 4.7 的公開 benchmark,現時最清晰可以歸納為三個數字:SWE-bench Verified 87.6%、GPQA 94.2%、SWE-bench Multilingual 80.5%。當中,SWE-bench Verified 87.6% 是最穩陣的參考點,因為有多個公開來源提到同一個數字。
不過,benchmark 唔等於實際生產表現。尤其係團隊要揀模型、做 API 遷移、或者將 AI agent 放入真實軟件工程流程時,分數只係第一層篩選,最後仍然要靠自己 repo、自己工具鏈、自己驗收標準去試。
「Claude Opus 4.7 benchmark 點睇:SWE-bench、GPQA 同來源可信度」的簡短答案是什麼?
Claude Opus 4.7 目前公開可見的核心 benchmark 包括 SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%;其中 SWE bench Verified 來源支撐最強。[4][5][9]
首先要驗證的關鍵點是什麼?
Claude Opus 4.7 目前公開可見的核心 benchmark 包括 SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%;其中 SWE bench Verified 來源支撐最強。[4][5][9] GPQA 同 SWE bench Multilingual 都有參考價值,但在現有資料中確認來源較少,做採購、遷移或生產模型選型時要保守解讀。
rabinarayanpatra.comClaude Opus 4.7: Benchmarks, Breaking Changes, Migration Guide | Rabinarayan Patra
llm-stats.comClaude Opus 4.7: Benchmarks, Pricing, Context & What's New
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
binance.comAnthropic Launches Claude Opus 4.7 With Higher ...
almcorp.comClaude Opus 4.7: Pricing, Benchmarks & Context Window - ALM Corp