答案已發布10 來源
GPT-5.5 benchmark:GDPval 84.9% 其實代表乜?
最穩陣嘅短答係 GDPval 84.9%:OpenAI 自己公布呢個數字,並指 GDPval 測試橫跨 44 個職業嘅清楚界定知識工作。[1] Expert SWE 73.1% 同 BixBench 80.5% 量度嘅任務範圍唔同,唔應該直接同 GDPval 鬥高低。[8][10] Artificial Analysis 將 GPT 5.5 排喺 Intelligence Index 第一、領先 3 分;但第一名唔代表每個單項測試都贏。[3]
發布者使用 GPT-5.5 編輯圖片由 GPT Image 2 生成
研究答案
重點
- 最穩陣嘅短答係 GDPval 84.9%:OpenAI 自己公布呢個數字,並指 GDPval 測試橫跨 44 個職業嘅清楚界定知識工作。[1]
- Expert SWE 73.1% 同 BixBench 80.5% 量度嘅任務範圍唔同,唔應該直接同 GDPval 鬥高低。[8][10]
- Artificial Analysis 將 GPT 5.5 排喺 Intelligence Index 第一、領先 3 分;但第一名唔代表每個單項測試都贏。[3]
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "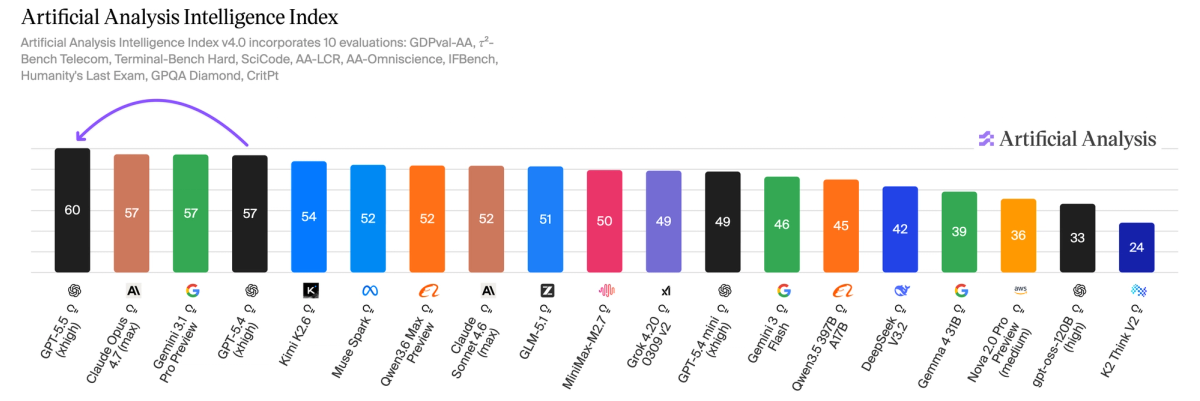 GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
先講結論:如果你問「GPT-5.5 嘅 benchmark 係幾多?」最穩陣嘅短答案係 GDPval 84.9%。OpenAI 自己公布 GPT-5.5 喺 GDPval 取得 84.9%,並形容 GDPval 係測試 AI agent 能否產出橫跨 44 個職業、清楚界定嘅知識工作成果。
但呢個數字唔應該被讀成「GPT-5.5 嘅總分」或者「所有任務都 84.9%」。Benchmark 好似科技圈常講嘅跑分:要睇佢跑緊邊條賽道。GDPval 主要講知識工作、任務理解同交付具體成果;唔係 coding、法律、生物資訊學或者第三方綜合排行榜嘅同一回事。
一句話點答:GDPval 84.9%
如果只可以引用一個數,建議咁寫:
根據 OpenAI,GPT-5.5 喺 GDPval 取得 84.9%;GDPval 用嚟測試 AI agent 能否完成橫跨 44 個職業、清楚規格化嘅知識工作。
Studio Global AI
繼續你的研究
此頁麵包含一個有來源支援的答案,您可以在 Studio Global 內繼續。
人們還問
「GPT-5.5 benchmark:GDPval 84.9% 其實代表乜?」的簡短答案是什麼?
最穩陣嘅短答係 GDPval 84.9%:OpenAI 自己公布呢個數字,並指 GDPval 測試橫跨 44 個職業嘅清楚界定知識工作。[1]
首先要驗證的關鍵點是什麼?
最穩陣嘅短答係 GDPval 84.9%:OpenAI 自己公布呢個數字,並指 GDPval 測試橫跨 44 個職業嘅清楚界定知識工作。[1] Expert SWE 73.1% 同 BixBench 80.5% 量度嘅任務範圍唔同,唔應該直接同 GDPval 鬥高低。[8][10]
接下來在實務上我該做什麼?
Artificial Analysis 將 GPT 5.5 排喺 Intelligence Index 第一、領先 3 分;但第一名唔代表每個單項測試都贏。[3]
來源
openai.comIntroducing GPT-5.5 - OpenAI
ca.finance.yahoo.comOpenAI releases GPT-5.5 with improved coding and research capabilities
linkedin.comOpenAI Releases GPT-5.5 With State-of-the-Art Scores on Coding, Science, and Computer Use
artificialanalysis.aiOpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis