答案已发布16 来源
Puffin-World:用重力、几何与 RGB 统一建模 3D 世界的开源模型
Puffin World 将重力感知的物理状态、稠密深度几何和 RGB 外观联合建模,目标不只是生成视频像素,而是维持可用的三维相机与场景关系。 项目公开了代码、3 个模型检查点及 Puffin 16M 数据:约 1,500 万组视觉—语言—相机三元组,以及 100 万条高难度相机轨迹。
发布者使用 GPT-5.6 Terra 编辑图片由 GPT Image 2 生成
研究答案
要点
- Puffin World 将重力感知的物理状态、稠密深度几何和 RGB 外观联合建模,目标不只是生成视频像素,而是维持可用的三维相机与场景关系。
- 项目公开了代码、3 个模型检查点及 Puffin 16M 数据:约 1,500 万组视觉—语言—相机三元组,以及 100 万条高难度相机轨迹。
- 作者报告,在 Stanford2D3D 上的中位误差为横滚角 0.29°、俯仰角 0.53°、垂直视场角 1.62°;这些结果尚未在所给资料中得到独立复现。
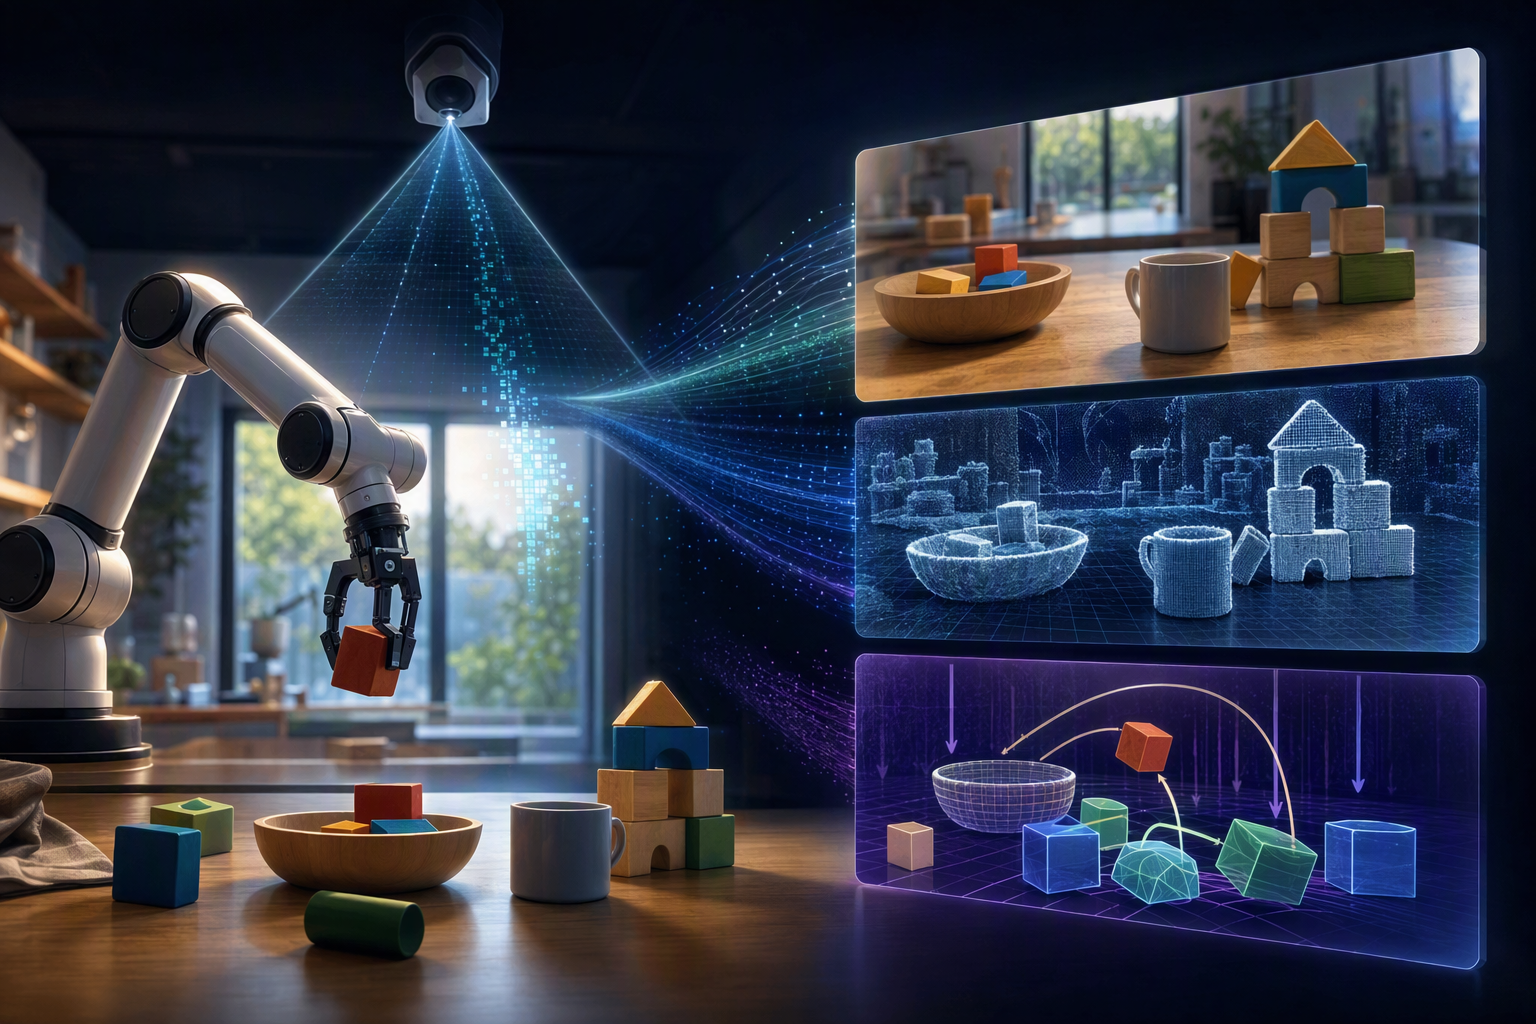
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Puffin-World, the open-source multimodal world model developed by ACE Robotics, NTU S-Lab, Beijing Jiaotong University, and the Univ. Article summary: Puffin-World is an open-source, camera-centric multimodal world model that treats a world not merely as RGB video, but as three jointly modeled native states: gravity-aware physics, dense 3D geometry, and visual appearan. Topic tags: general, academic, general web. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake num
生成一段逼真的视频,并不意味着模型真正理解了三维空间:镜头一转,地平线可能漂移;画面看似连贯,深度和相机姿态却未必自洽。Puffin-World 的切入点是把这些通常隐含在像素里的信息,直接作为模型要处理的“世界状态”。
Puffin-World 由 ACE Robotics、南洋理工大学 S-Lab、北京交通大学和密歇根大学相关研究人员推出,是一个开源的统一多模态世界模型。它将 物理、几何、外观 分别表示为重力方向与纬度、稠密深度及 RGB 图像,并在同一框架中覆盖相机理解、受控视点生成、RGB-D 重建与探索任务。1
5
核心思路:画面之外,还要有稳定的“上下左右”
Puffin-World 所说的“物理”并非完整的物理仿真器,而是主要指相机相对于重力的方向和纬度;“几何”指深度;“外观”则是 RGB 视觉内容。1
5
这让它成为一个以相机为中心的世界模型:模型不仅要回答“场景看上去是什么样”,还要描述“相机如何相对重力摆放”,并据此推演相机移动后应看到的画面。对于需要在环境中移动的机器人或智能体,这种区分尤其关键——仅靠连续图像的视觉合理性,未必能保证空间关系稳定。
Omni-Camera:用 9 个通道同时表达绝对方向与相对运动
Puffin-World 的关键条件表示名为 Omni-Camera。它是一个 9 通道的稠密相机条件,结合两部分信息:5
- 重力感知的绝对透视场:把相机锚定在物理参考系中,表达其与重力方向的关系;
- 基于射线的相对几何:描述视角之间的旋转、平移、相机内参及复合运动。
直观来说,前者回答“相机有没有歪、天和地在哪里”,后者回答“镜头接下来怎样转、怎样移”。模型会把参考视图推断到的重力方向沿目标相机轨迹传播,以尽量让连续生成的观察结果处在同一物理参考框架中,并减少逐帧生成常见的地平线或重力方向漂移。5
6
一个框架能做什么?
从单张图像估计相机姿态
模型的理解分支可由单张图像预测绝对横滚角(roll)、俯仰角(pitch)和垂直视场角(vertical FoV)。这些预测随后可转换成 Omni-Camera 所需的重力与透视场信息。5
按指定轨迹生成自由视点画面
Puffin-World 可根据文本提示加相机控制生成新视图,也可接收一张输入图像和指定相机轨迹。可控变量包括旋转、平移、相机内参及复合运动,覆盖横滚、俯仰和偏航等变化。5
同时生成 RGB 与深度,并重建场景
它生成的并非只有彩色画面,还会沿轨迹联合输出 RGB 和深度。随后,这些 RGB-D 结果可以汇总为带颜色的三维点云,而不需要再交给单独的离线几何重建流程。5
支持闭环探索,但公开细节仍有限
项目公开材料展示了模仿探索与自校准演示。其文档将重力感知参考系描述为重新锚定生成轨迹、抑制姿态不一致累积的手段。不过,现有公开资料并未完整说明漂移校正的具体控制算法,因此更准确的说法是:它展示了闭环探索能力,而非已公开全部闭环机制。5
6
架构与开源内容
Puffin-World 将几何对齐的 C-RADIO 视觉编码器、Qwen 语言模型、SD3.5 扩散生成器和轻量连接器组合在一起。设计上,相机与物理状态理解采用自回归式处理,多视角 RGB-D 生成则由扩散模型承担,但两者仍被置于一个统一系统中。5
公开发布包含代码、训练与评测指引、数据集构建文档、模型和数据集,并列出 3 个检查点:5
- Puffin-World-Base:Qwen2.5-7B、C-RADIOv3-H、SD3.5-medium;
- Puffin-World-Pro:Qwen2.5-1.5B、C-RADIOv4-H、SD3.5-large;
- Puffin-World-Caption:Qwen3.5-0.8B 与 C-RADIOv3-H,聚焦物理描述与相机理解。
Puffin-16M:让模型学习“画面是怎样拍出来的”
Puffin-16M 数据集约含 1,650 万个样本,由两个互补部分组成。14
其中,Puffin-Cam-15M 包含约 1,500 万组视觉—语言—相机三元组,来自约 90 万张全景图的渲染。其相机横滚角和俯仰角覆盖 −45° 至 +45°,垂直视场角覆盖 20° 至 105°。5
Puffin-Traj-1M 则提供 100 万条高难度相机轨迹,覆盖长轨迹、极端旋转以及俯仰、偏航、横滚组合动作。公开资料确认了这些运动类型,但没有给出各类运动样本的可靠数量拆分。5
11
现有材料也支持数据覆盖室内、室外、真实与合成图像,但不足以据此得出精确的场景类别比例。7
为 28 个公开数据集补上绝对相机信息
团队还使用 Puffin-World 为 28 个公开数据集补充绝对横滚角、俯仰角和垂直视场角估计,其中包括 22 个单图数据集与 6 个序列或三维数据集,合计约 4,450 万条相机标注。1
论文称,这批标注揭示出多个数据集存在近水平拍摄偏好、整体更倾向向下俯拍,以及视场角差异显著等现象。1 这项工作的重要性在于:相对运动只能说明相机“移动了多少”,却不能完全说明它相对于重力或共享世界坐标系“朝向哪里”。
作者报告的基准成绩
项目方报告称,在 Stanford2D3D、MegaDepth、TartanAir 和 LaMAR 四个相机到世界坐标理解基准中,其在全部 12 项中位误差对比中取得最佳表现;若将并列第一计入,则在 36 项 AUC 指标中有 33 项最佳。5 这些均为作者报告结果,所给资料中没有独立复现。
部分具体数字如下:
- Stanford2D3D:横滚角中位误差 0.29°、俯仰角 0.53°、垂直视场角 1.62°。
1
5
- 横滚角误差:MegaDepth 为 0.28°,TartanAir 为 0.31°,LaMAR 为 0.26°。
- RealEstate10K 世界建模:PSNR 为 17.22,LPIPS 为 0.318。
- 重力传播消融实验:PSNR 从 19.87 升至 20.54,LPIPS 从 0.23 降至 0.21,横滚角和俯仰角误差也有所改善。
- 高难度轨迹基准:横滚角中位误差 0.80°,俯仰角中位误差 1.10°。
在自建的 Puffin-Cam-Bench 上,项目还报告了较低的上方向、纬度和重力相关误差。另有项目摘要给出 1.32° 的重力误差,而 README 报告的是另一种重力指标;由于公开材料没有清楚说明两者的评测定义,不能直接将这些数值横向比较。4
5
它还不是通用物理模拟器
Puffin-World 的“物理”表示主要是重力与纬度,而不是对碰撞、物体交互或力学过程的完整模拟。发布资料主要聚焦静态场景,也没有宣称已解决动态环境或长时程世界演化问题。5
因此,更合适的定位是:Puffin-World 向“空间与物理约束更明确”的视觉世界模型迈出了一步。它试图解决的不是单纯把下一帧画得更像,而是让相机、重力、深度与图像在三维世界中说同一种语言;距离覆盖一切动态物理过程的通用模拟器,仍有明显距离。
Studio Global AI
继续你的研究
此页面包含一个有来源支持的答案,您可以在 Studio Global 内继续。
人们还问
“Puffin-World:用重力、几何与 RGB 统一建模 3D 世界的开源模型”的简短答案是什么?
Puffin World 将重力感知的物理状态、稠密深度几何和 RGB 外观联合建模,目标不只是生成视频像素,而是维持可用的三维相机与场景关系。
首先要验证的关键点是什么?
Puffin World 将重力感知的物理状态、稠密深度几何和 RGB 外观联合建模,目标不只是生成视频像素,而是维持可用的三维相机与场景关系。 项目公开了代码、3 个模型检查点及 Puffin 16M 数据:约 1,500 万组视觉—语言—相机三元组,以及 100 万条高难度相机轨迹。
接下来在实践中我应该做什么?
作者报告,在 Stanford2D3D 上的中位误差为横滚角 0.29°、俯仰角 0.53°、垂直视场角 1.62°;这些结果尚未在所给资料中得到独立复现。
来源
kangliao929.github.ioPuffin-World · Scaling with Native 3D World States