答案已发布10 来源
GPT-5.5 基准测试:84.9% 的 GDPval 分数该怎么理解
最稳妥的短答案是:GPT 5.5 在 OpenAI 公布的 GDPval 上得分 84.9%,GDPval 用于测试智能体完成跨 44 个职业的明确知识工作。[1] 73.1% 的 Expert SWE 与编程任务有关,80.5% 的 BixBench 与真实世界生物信息学有关,不能和 GDPval 简单横向比大小。[8][10] Artificial Analysis 将 GPT 5.5 列为 Intelligence Index 第一并领先 3 分,但这并不代表它赢下每一个单项评测。[3]
发布者使用 GPT-5.5 编辑图片由 GPT Image 2 生成
研究答案
要点
- 最稳妥的短答案是:GPT 5.5 在 OpenAI 公布的 GDPval 上得分 84.9%,GDPval 用于测试智能体完成跨 44 个职业的明确知识工作。[1]
- 73.1% 的 Expert SWE 与编程任务有关,80.5% 的 BixBench 与真实世界生物信息学有关,不能和 GDPval 简单横向比大小。[8][10]
- Artificial Analysis 将 GPT 5.5 列为 Intelligence Index 第一并领先 3 分,但这并不代表它赢下每一个单项评测。[3]
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "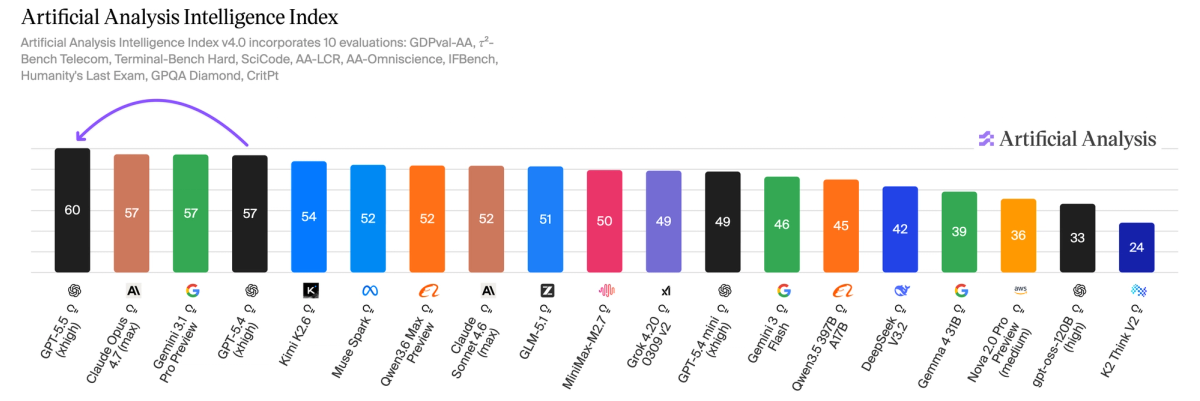 GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
问 GPT-5.5 的 benchmark 是多少,最容易踩坑的是把所有百分比都看成同一张成绩单。更清晰的说法是:如果只需要一个通用、来源最直接的短 benchmark,应该引用 OpenAI 公布的 GDPval 84.9%。
但要注意,GDPval 不是“模型智商分”,也不是覆盖所有能力的总评分。它衡量的是智能体能否完成定义清楚的知识工作,范围覆盖 44 个职业。
一句话答案
据 OpenAI,GPT-5.5 在 GDPval 上得分 84.9%;GDPval 测试智能体生成明确规定的知识工作成果,覆盖 44 个职业。
Studio Global AI
继续你的研究
此页面包含一个有来源支持的答案,您可以在 Studio Global 内继续。
人们还问
“GPT-5.5 基准测试:84.9% 的 GDPval 分数该怎么理解”的简短答案是什么?
最稳妥的短答案是:GPT 5.5 在 OpenAI 公布的 GDPval 上得分 84.9%,GDPval 用于测试智能体完成跨 44 个职业的明确知识工作。[1]
首先要验证的关键点是什么?
最稳妥的短答案是:GPT 5.5 在 OpenAI 公布的 GDPval 上得分 84.9%,GDPval 用于测试智能体完成跨 44 个职业的明确知识工作。[1] 73.1% 的 Expert SWE 与编程任务有关,80.5% 的 BixBench 与真实世界生物信息学有关,不能和 GDPval 简单横向比大小。[8][10]
接下来在实践中我应该做什么?
Artificial Analysis 将 GPT 5.5 列为 Intelligence Index 第一并领先 3 分,但这并不代表它赢下每一个单项评测。[3]
来源
openai.comIntroducing GPT-5.5 - OpenAI
ca.finance.yahoo.comOpenAI releases GPT-5.5 with improved coding and research capabilities
linkedin.comOpenAI Releases GPT-5.5 With State-of-the-Art Scores on Coding, Science, and Computer Use
artificialanalysis.aiOpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis