答案已发布16 来源
OpenAI × 1Password:如何让 Codex 在不接触密钥的情况下完成真实开发任务
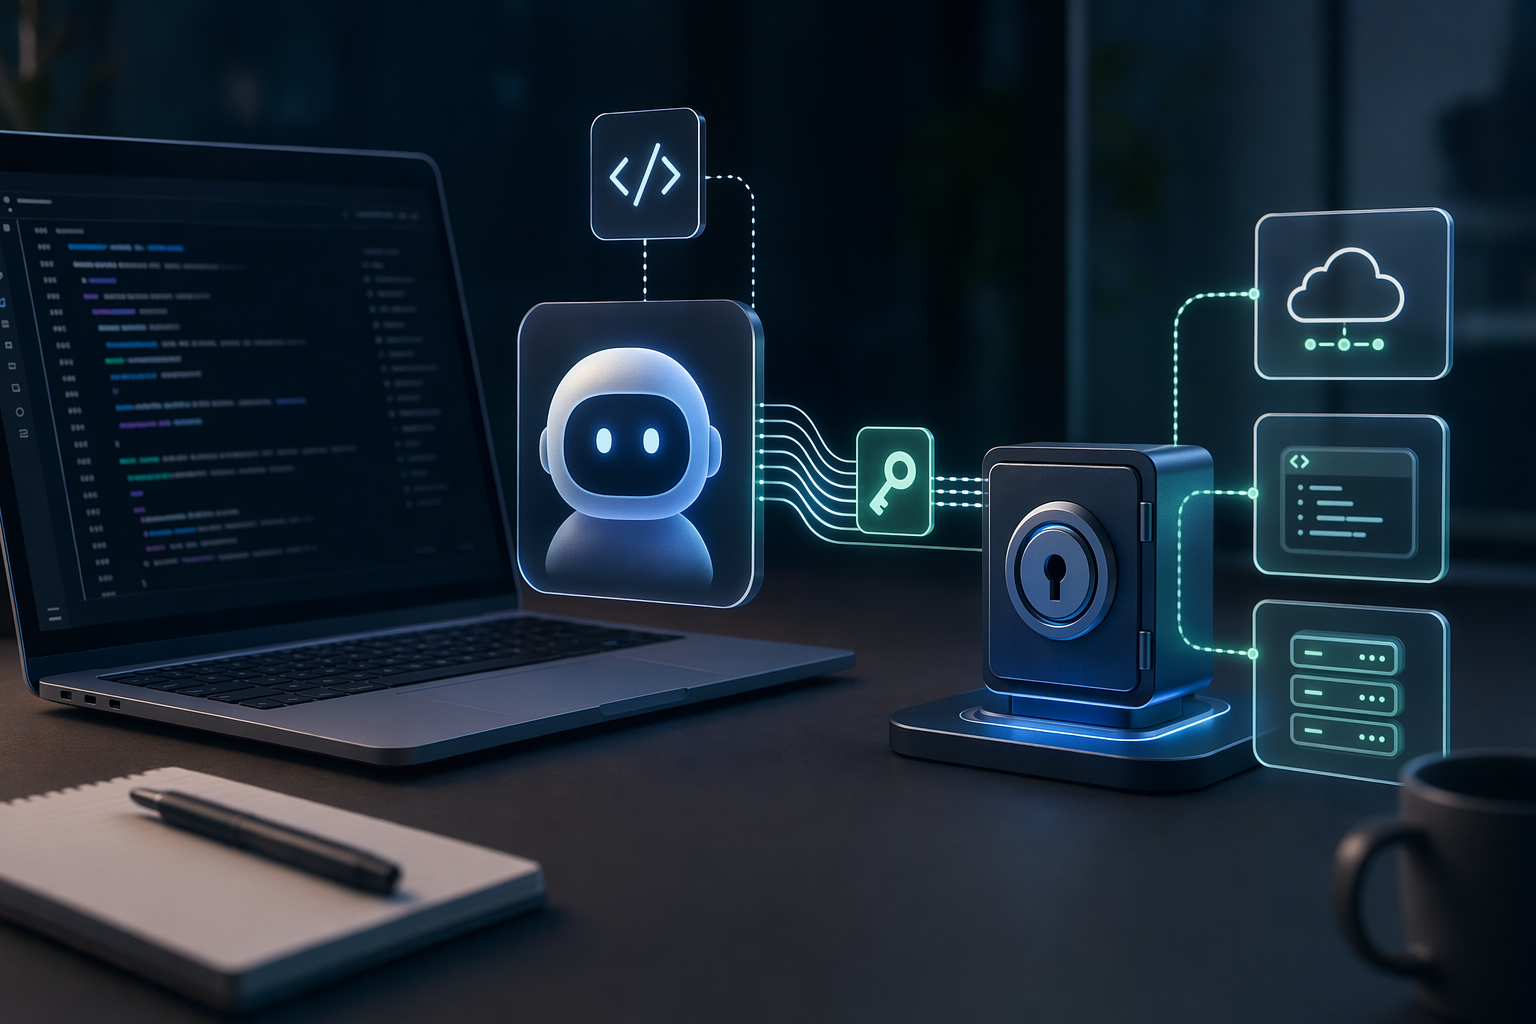
OpenAI 的 Codex 可以与 1Password 集成,通过 MCP 工具获取凭证能力,而不是把 API Key 或密码直接放入提示词或模型上下文。 这种架构用“受控能力请求”取代硬编码密钥,实现即时(just‑in‑time)和最小权限访问,并支持审计与集中管理。
发布者使用 GPT-5.5 编辑图片由 GPT Image 2 生成
研究答案
要点
- OpenAI 的 Codex 可以与 1Password 集成,通过 MCP 工具获取凭证能力,而不是把 API Key 或密码直接放入提示词或模型上下文。
- 这种架构用“受控能力请求”取代硬编码密钥,实现即时(just‑in‑time)和最小权限访问,并支持审计与集中管理。
- 即便如此,企业仍需配置 MCP 服务器白名单、密钥权限策略和代码审查等安全措施,以降低 AI 生成代码和工具集成带来的风险。
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: How does the new partnership between OpenAI and 1Password improve security for the Codex AI coding agent, and how does the integration work. Article summary: The OpenAI–1Password pattern can improve Codex security by moving secrets out of prompts and model inputs, and instead letting Codex request narrowly scoped credentials through a mediated tool path; 1Password warns that . Topic tags: general, documentation, general web, user generated. Reference image context from search candidates: Reference image 1: visual subject "Coding agents are now writing production features on real development teams, and a new report from DryRun Security shows that those agents introduce security vulnerabilities at a h" source context "AI coding agents keep repeating decade-old security mistakes - Help Net Security" Reference image 2: v
AI 编程代理(如 Codex)已经可以写代码、运行命令、调用 API,甚至自动部署应用。但要让这些代理真正“干活”,它们必须访问凭证——例如 API key、数据库密码或云平台令牌。
过去很多开发者的做法很简单:直接把密钥贴进提示词或配置文件里。问题在于,一旦密钥进入模型上下文(context window),开发者就几乎无法控制它会出现在哪里——日志、生成代码、调试输出甚至共享文件中都可能泄露。
OpenAI 与 1Password 的新型集成模式试图解决这个问题:让 AI 不再直接接触密钥,而是通过受控工具请求能力。
核心问题:密钥进入模型上下文
在很多 AI 开发流程中,凭证泄露往往是无意发生的。例如:
- 把 API key 粘贴进 prompt
- 把 token 写进
.env或配置文件 - 在代码仓库中保存明文凭证
这样做的问题是,一旦密钥进入模型输入,就会被发送到模型 API,并可能被写入会话日志或生成文件。之后开发者很难再控制它的传播路径。
1Password 的开发者文档明确指出:不要把原始凭证直接传给 AI 模型,因为这会带来明显的安全风险。更安全的做法是使用短生命周期、权限范围严格限制的凭证,并尽量减少模型对敏感数据的直接访问。
Studio Global AI
继续你的研究
此页面包含一个有来源支持的答案,您可以在 Studio Global 内继续。
人们还问
“OpenAI × 1Password:如何让 Codex 在不接触密钥的情况下完成真实开发任务”的简短答案是什么?
OpenAI 的 Codex 可以与 1Password 集成,通过 MCP 工具获取凭证能力,而不是把 API Key 或密码直接放入提示词或模型上下文。
首先要验证的关键点是什么?
OpenAI 的 Codex 可以与 1Password 集成,通过 MCP 工具获取凭证能力,而不是把 API Key 或密码直接放入提示词或模型上下文。 这种架构用“受控能力请求”取代硬编码密钥,实现即时(just‑in‑time)和最小权限访问,并支持审计与集中管理。
接下来在实践中我应该做什么?
即便如此,企业仍需配置 MCP 服务器白名单、密钥权限策略和代码审查等安全措施,以降低 AI 生成代码和工具集成带来的风险。
来源
agentpatterns.aiSecrets Management for AI Agents: Credential Injection
developer.1password.comhttps://developer.1password.com/llms-sdks.txt
1password.devSecure AI access - 1Password Developer Tools
developers.openai.comModel Context Protocol – Codex | OpenAI Developers