答案已发布15 来源
AI模型崩塌:为什么用AI生成的数据训练AI会让模型逐渐偏离现实
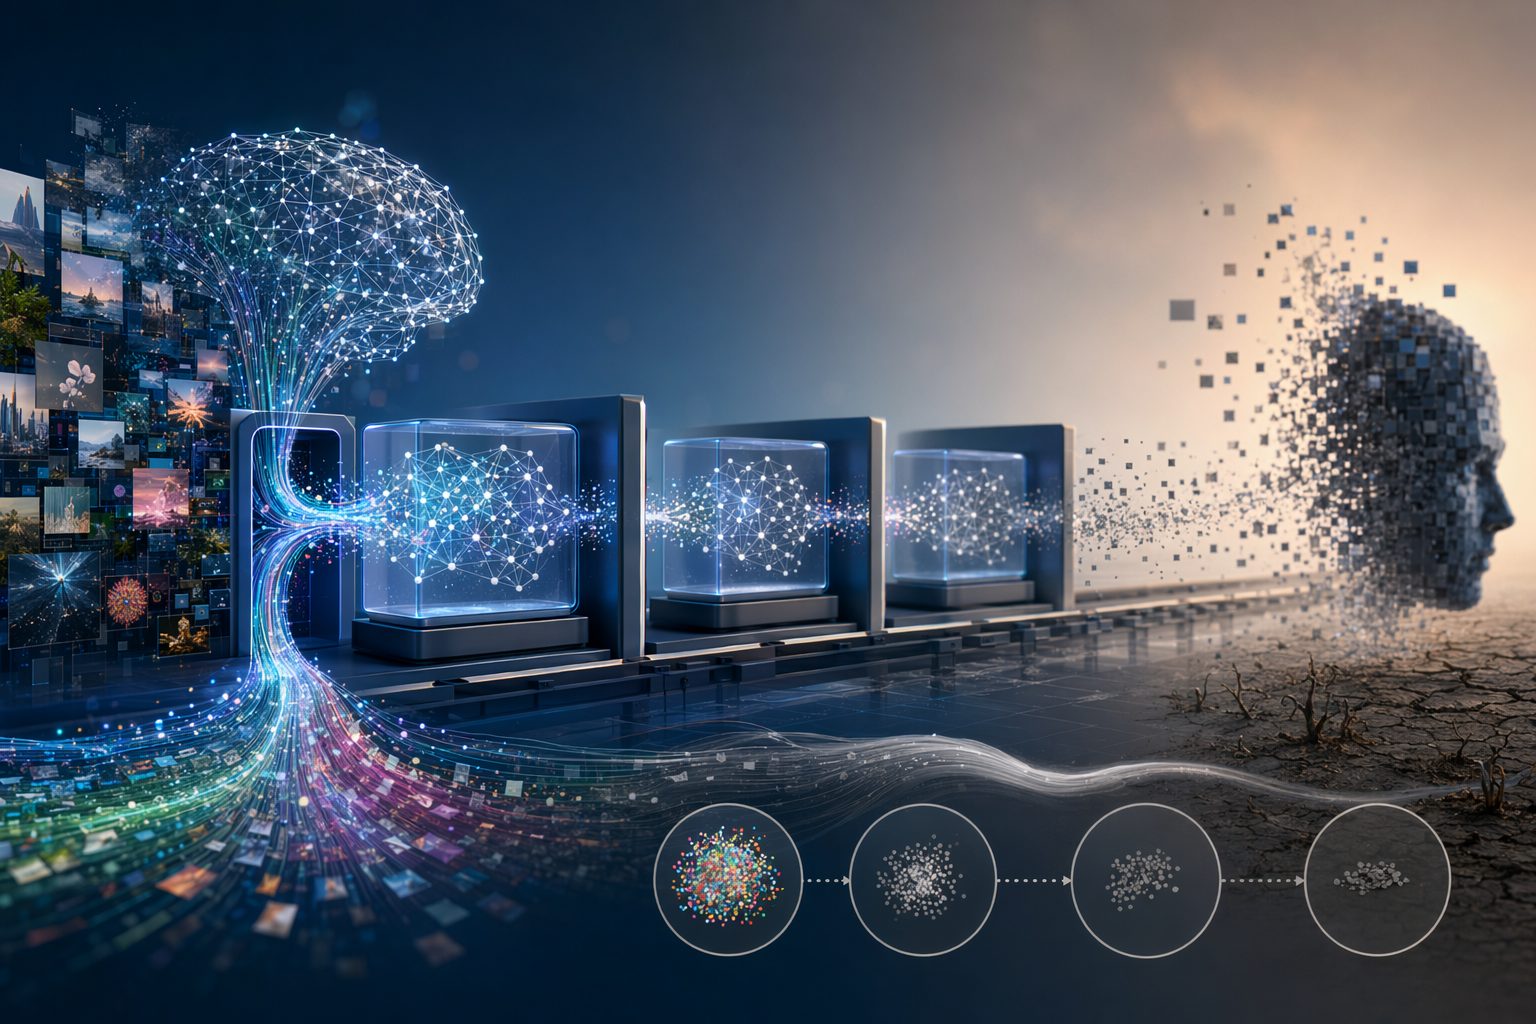
研究表明,如果AI模型反复使用AI生成的数据进行训练,会出现“模型崩塌”,导致数据分布中的稀有模式逐渐消失,模型对现实的表达能力下降。[1][4] 递归训练会放大采样偏差:高概率模式被不断强化,而位于分布“尾部”的罕见情况越来越少见,最终被模型完全遗忘。[1][9] 分析显示,即使只加入极少量真实世界数据或引入先验知识,也可能作为锚点防止模型崩塌,保持对真实分布的正确学习。[7][33]
发布者使用 GPT-5.5 编辑图片由 GPT Image 2 生成
研究答案
要点
- 研究表明,如果AI模型反复使用AI生成的数据进行训练,会出现“模型崩塌”,导致数据分布中的稀有模式逐渐消失,模型对现实的表达能力下降。[1][4]
- 递归训练会放大采样偏差:高概率模式被不断强化,而位于分布“尾部”的罕见情况越来越少见,最终被模型完全遗忘。[1][9]
- 分析显示,即使只加入极少量真实世界数据或引入先验知识,也可能作为锚点防止模型崩塌,保持对真实分布的正确学习。[7][33]
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
生成式人工智能越来越多地使用**合成数据(synthetic data)**进行训练——也就是由早期AI模型生成的文本、图像或其他内容。但研究人员发现,这种做法隐藏着一个重要风险:模型崩塌(model collapse)。在这种情况下,模型会逐渐失去对真实数据多样性的表达能力。
一项关于递归训练(recursive training)的研究指出:当新模型不断从旧模型生成的内容中学习,而不是从真实世界数据中学习时,它们会逐渐“遗忘”原始数据分布中的稀有模式。随着训练代数增加,这些缺失会累积,最终让模型对现实的表示出现系统性偏差。
Studio Global AI
继续你的研究
此页面包含一个有来源支持的答案,您可以在 Studio Global 内继续。
人们还问
“AI模型崩塌:为什么用AI生成的数据训练AI会让模型逐渐偏离现实”的简短答案是什么?
研究表明,如果AI模型反复使用AI生成的数据进行训练,会出现“模型崩塌”,导致数据分布中的稀有模式逐渐消失,模型对现实的表达能力下降。[1][4]
首先要验证的关键点是什么?
研究表明,如果AI模型反复使用AI生成的数据进行训练,会出现“模型崩塌”,导致数据分布中的稀有模式逐渐消失,模型对现实的表达能力下降。[1][4] 递归训练会放大采样偏差:高概率模式被不断强化,而位于分布“尾部”的罕见情况越来越少见,最终被模型完全遗忘。[1][9]
接下来在实践中我应该做什么?
分析显示,即使只加入极少量真实世界数据或引入先验知识,也可能作为锚点防止模型崩塌,保持对真实分布的正确学习。[7][33]
来源
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests