So sánh benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla... Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là m...
Đăng bởiBiên tập bằng GPT-5.5Hình ảnh được tạo bằng GPT Image 2
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla...
Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là mô hình open source, native multimodal agentic; một bài viết bên thứ ba ghi 58,6% trên SWE Bench Pro và 80,2% trên SWE Ben...
GPT 5.5 có điểm Expert SWE 73,1%, nhưng đây là internal eval và OpenAI ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên bài đánh giá này, nên không phù hợp làm trụ cột cho bảng xếp hạng tổng.[21]
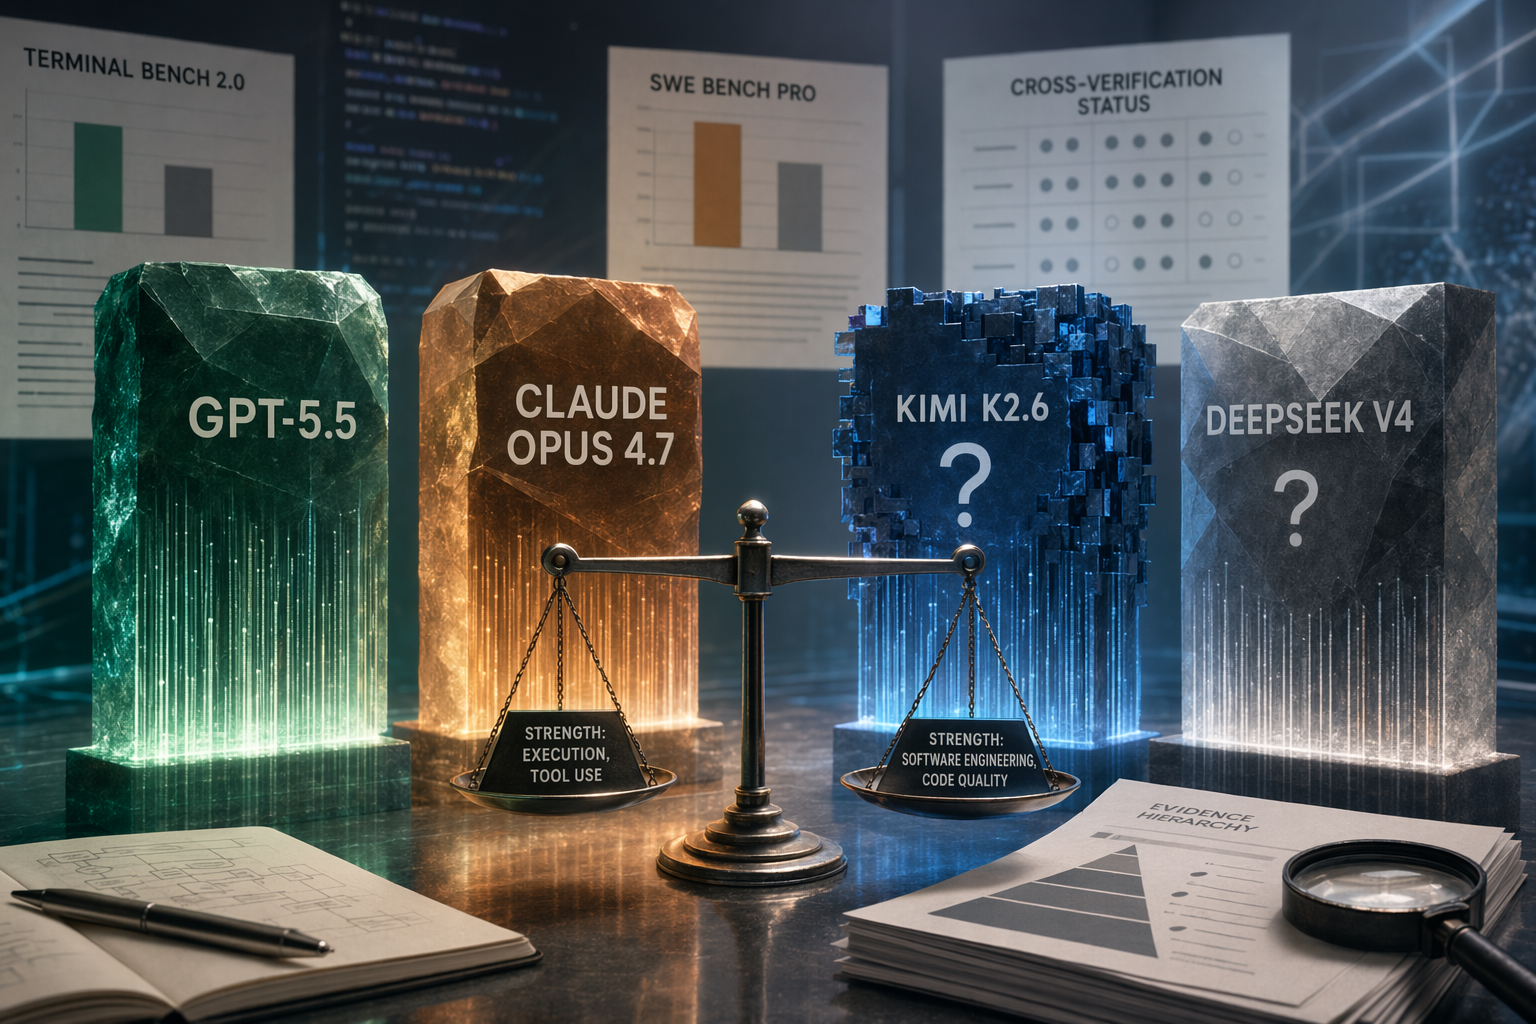
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級AI 生成示意圖;本文聚焦可核驗 benchmark 分數與來源等級。
Prompt AI
Create a landscape editorial hero image for this Studio Global article: GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級. Article summary: 目前不能公平排出四模型總冠軍:同表可比數據顯示 Claude Opus 4.7 在 SWE Bench Pro 64.3% vs GPT 5.5 58.6% 領先,但 GPT 5.5 在 Terminal Bench 2.0 82.7% vs 69.4% 領先;Kimi K2.6 與 DeepSeek V4 缺少同等級交叉驗證。[21]. Topic tags: ai, llm benchmarks, openai, anthropic, claude. Reference image context from search candidates: Reference image 1: visual subject "OpenAI’s GPT-5.5, Anthropic’s Claude Opus 4.7, and DeepSeek V4 arrived close enough together to look like a clean three-way race. **GPT-5.5 is OpenAI’s bet on execution-heavy profe" source context "GPT-5.5, Claude Opus 4.7, and DeepSeek V4 reveal three different ..." Reference image 2: visual subject "# DeepSeek V4 Pro vs Claude Opus 4.7 vs GPT-5.5: The Frontier in April 2026. DeepSeek V4 Pro undercuts GPT-5.5 by ~9x on outpu
openai.com
Nếu chỉ nhìn vào vài con số benchmark rồi xếp bốn mô hình thành một bảng “ai mạnh nhất”, rất dễ đi sai hướng. Với GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4, câu hỏi quan trọng hơn là: những điểm số nào được đo trong cùng điều kiện, và nguồn nào đủ tin để đối chiếu?
Trong các nguồn hiện có, cặp dễ so nhất là GPT-5.5 và Claude Opus 4.7, vì bảng đánh giá của OpenAI liệt kê cả hai trên SWE-Bench Pro và Terminal-Bench 2.0. Kimi K2.6 có thông tin từ trang Hugging Face và một bài viết bên thứ ba nêu điểm SWE-Bench; DeepSeek V4 thì chưa có đủ benchmark có thể kiểm chứng trong bộ nguồn của bài này, nên không nên ép vào một bảng xếp hạng có điểm số.
Bảng so sánh benchmark
Dấu “—” trong bảng nghĩa là bài này không có số liệu có thể trích dẫn từ nguồn đã cung cấp, có nghĩa mô hình không làm được nhóm tác vụ đó. Ngoài ra, điểm từ các nguồn khác nhau, bộ chạy đánh giá khác nhau hoặc cấu hình test khác nhau không nên cộng gộp thành một “điểm tổng” duy nhất.
Studio Global AI
Tiếp tục nghiên cứu của bạn
Trang này bao gồm câu trả lời dựa trên nguồn mà bạn có thể tiếp tục bên trong Studio Global.
Câu trả lời ngắn gọn cho "So sánh benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4" là gì?
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla...
Những điểm chính cần xác nhận đầu tiên là gì?
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla... Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là mô hình open source, native multimodal agentic; một bài viết bên thứ ba ghi 58,6% trên SWE Bench Pro và 80,2% trên SWE Ben...
Tôi nên làm gì tiếp theo trong thực tế?
GPT 5.5 có điểm Expert SWE 73,1%, nhưng đây là internal eval và OpenAI ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên bài đánh giá này, nên không phù hợp làm trụ cột cho bảng xếp hạng tổng.[21]
So sánh benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla... Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là m...
Đăng bởiBiên tập bằng GPT-5.5Hình ảnh được tạo bằng GPT Image 2
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla...
Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là mô hình open source, native multimodal agentic; một bài viết bên thứ ba ghi 58,6% trên SWE Bench Pro và 80,2% trên SWE Ben...
GPT 5.5 có điểm Expert SWE 73,1%, nhưng đây là internal eval và OpenAI ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên bài đánh giá này, nên không phù hợp làm trụ cột cho bảng xếp hạng tổng.[21]
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級AI 生成示意圖;本文聚焦可核驗 benchmark 分數與來源等級。
Prompt AI
Create a landscape editorial hero image for this Studio Global article: GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級. Article summary: 目前不能公平排出四模型總冠軍:同表可比數據顯示 Claude Opus 4.7 在 SWE Bench Pro 64.3% vs GPT 5.5 58.6% 領先,但 GPT 5.5 在 Terminal Bench 2.0 82.7% vs 69.4% 領先;Kimi K2.6 與 DeepSeek V4 缺少同等級交叉驗證。[21]. Topic tags: ai, llm benchmarks, openai, anthropic, claude. Reference image context from search candidates: Reference image 1: visual subject "OpenAI’s GPT-5.5, Anthropic’s Claude Opus 4.7, and DeepSeek V4 arrived close enough together to look like a clean three-way race. **GPT-5.5 is OpenAI’s bet on execution-heavy profe" source context "GPT-5.5, Claude Opus 4.7, and DeepSeek V4 reveal three different ..." Reference image 2: visual subject "# DeepSeek V4 Pro vs Claude Opus 4.7 vs GPT-5.5: The Frontier in April 2026. DeepSeek V4 Pro undercuts GPT-5.5 by ~9x on outpu
openai.com
Nếu chỉ nhìn vào vài con số benchmark rồi xếp bốn mô hình thành một bảng “ai mạnh nhất”, rất dễ đi sai hướng. Với GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4, câu hỏi quan trọng hơn là: những điểm số nào được đo trong cùng điều kiện, và nguồn nào đủ tin để đối chiếu?
Trong các nguồn hiện có, cặp dễ so nhất là GPT-5.5 và Claude Opus 4.7, vì bảng đánh giá của OpenAI liệt kê cả hai trên SWE-Bench Pro và Terminal-Bench 2.0. Kimi K2.6 có thông tin từ trang Hugging Face và một bài viết bên thứ ba nêu điểm SWE-Bench; DeepSeek V4 thì chưa có đủ benchmark có thể kiểm chứng trong bộ nguồn của bài này, nên không nên ép vào một bảng xếp hạng có điểm số.
Bảng so sánh benchmark
Dấu “—” trong bảng nghĩa là bài này không có số liệu có thể trích dẫn từ nguồn đã cung cấp, có nghĩa mô hình không làm được nhóm tác vụ đó. Ngoài ra, điểm từ các nguồn khác nhau, bộ chạy đánh giá khác nhau hoặc cấu hình test khác nhau không nên cộng gộp thành một “điểm tổng” duy nhất.
Studio Global AI
Tiếp tục nghiên cứu của bạn
Trang này bao gồm câu trả lời dựa trên nguồn mà bạn có thể tiếp tục bên trong Studio Global.
Câu trả lời ngắn gọn cho "So sánh benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6 và DeepSeek V4" là gì?
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla...
Những điểm chính cần xác nhận đầu tiên là gì?
Chưa nên gọi một “quán quân” chung: trong bảng OpenAI có thể đối chiếu trực tiếp, Claude Opus 4.7 đạt 64,3% trên SWE Bench Pro, cao hơn GPT 5.5 ở mức 58,6%; nhưng GPT 5.5 đạt 82,7% trên Terminal Bench 2.0, cao hơn Cla... Kimi K2.6 đáng được đưa vào danh sách thử nghiệm nếu cần mô hình mở: Hugging Face mô tả đây là mô hình open source, native multimodal agentic; một bài viết bên thứ ba ghi 58,6% trên SWE Bench Pro và 80,2% trên SWE Ben...
Tôi nên làm gì tiếp theo trong thực tế?
GPT 5.5 có điểm Expert SWE 73,1%, nhưng đây là internal eval và OpenAI ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên bài đánh giá này, nên không phù hợp làm trụ cột cho bảng xếp hạng tổng.[21]
Expert-SWE, internal eval: 73,1%; OpenAI ghi chú các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên eval này.
A-: SWE-Bench Pro và Terminal-Bench 2.0 nằm trong cùng bảng của OpenAI, có thể đối chiếu trực tiếp với Claude Opus 4.7; Expert-SWE là đánh giá nội bộ nên cần đọc thận trọng.
Claude Opus 4.7
64,3%
87,6%
Kimi K2.6
58,6%
80,2%
—
Trang Hugging Face mô tả Kimi K2.6 là mô hình open-source, native multimodal agentic.
B, còn hạn chế: điểm SWE-Bench đến từ bài viết bên thứ ba; trong nguồn của bài này chưa có bảng benchmark chính thức đầy đủ để kiểm chứng chéo cùng GPT-5.5 và Claude Opus 4.7.
DeepSeek V4
—
—
—
—
C, thiếu dữ liệu: không có benchmark DeepSeek V4 có thể trích dẫn trong bộ nguồn của bài này, nên không xếp hạng bằng số.
Nên nhìn benchmark nào trước?
SWE-Bench Pro: Claude Opus 4.7 vượt GPT-5.5 trong bảng có thể đối chiếu
SWE-Bench thường được dùng để nhìn năng lực xử lý tác vụ kỹ thuật phần mềm, đặc biệt các bài toán gần với sửa lỗi hoặc giải quyết issue trong kho mã. Trong bảng đánh giá GPT-5.5 của OpenAI, Claude Opus 4.7 đạt 64,3% trên SWE-Bench Pro, cao hơn GPT-5.5 ở mức 58,6%. Đây là một trong những so sánh sạch nhất của bài này, vì cả hai mô hình xuất hiện trong cùng một bảng nguồn.
Kimi K2.6 cũng được bài viết của Kilo AI ghi nhận ở mức 58,6% trên SWE-Bench Pro, nhìn bề ngoài ngang GPT-5.5. Tuy nhiên, con số này không nằm trong cùng bảng đối chiếu với GPT-5.5 và Claude Opus 4.7, nên nên xem là tín hiệu tham khảo, không phải kết luận thắng thua cùng chuẩn đo.
Terminal-Bench 2.0: GPT-5.5 dẫn trước Claude Opus 4.7
Ở Terminal-Bench 2.0, bảng OpenAI ghi GPT-5.5 đạt 82,7%, còn Claude Opus 4.7 đạt 69,4%. Nếu sản phẩm của bạn giống một coding agent làm việc trong môi trường dòng lệnh, gọi công cụ, chạy lệnh và xử lý quy trình trong terminal, GPT-5.5 đáng được đưa lên đầu danh sách thử nghiệm.
Điểm cần nhớ: bài này không có số Terminal-Bench 2.0 có thể trích dẫn cho Kimi K2.6 hoặc DeepSeek V4. Vì vậy, không thể lập bảng xếp hạng đủ bốn mô hình ở tiêu chí này.
SWE-Bench Verified: Claude cao hơn Kimi, nhưng nguồn không cùng chuẩn
Claude Opus 4.7 được các bài tổng hợp bên thứ ba ghi 87,6% trên SWE-Bench Verified; Verdent mô tả con số này là Anthropic-conducted và có áp dụng memorization screens. Kimi K2.6 được bài viết của Kilo AI ghi 80,2% trên SWE-Bench Verified.
Hai con số đều có giá trị tham khảo, nhưng không nên đọc như một phép so “cân bằng tuyệt đối” như cặp SWE-Bench Pro và Terminal-Bench 2.0 trong cùng bảng OpenAI.
Expert-SWE: có tín hiệu, nhưng không nên dùng để trao cúp
GPT-5.5 đạt 73,1% trên Expert-SWE, nhưng OpenAI tự gắn nhãn đây là internal eval và ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên eval này. Vì vậy, Expert-SWE có thể là tín hiệu về năng lực trong bộ đánh giá nội bộ của OpenAI, nhưng không nên dùng làm nền tảng chính để xếp hạng cả bốn mô hình.
Chọn mô hình theo việc cần làm, đừng chỉ nhìn “tổng điểm”
Nếu bài toán của bạn gần với sửa issue GitHub hoặc tác vụ kỹ thuật phần mềm phức tạp, Claude Opus 4.7 nên được thử sớm. Trên SWE-Bench Pro, bộ dữ liệu có thể đối chiếu trực tiếp nhất trong bài này, Claude Opus 4.7 đạt 64,3%, cao hơn GPT-5.5 ở mức 58,6%. Vellum cũng đặt cặp số này trong bối cảnh giải quyết issue GitHub thực tế.
Nếu quy trình của bạn thiên về coding agent vận hành trong terminal, GPT-5.5 là ứng viên mạnh. Điểm Terminal-Bench 2.0 có thể trích dẫn của GPT-5.5 là 82,7%, cao hơn Claude Opus 4.7 ở mức 69,4%. Điều này không có nghĩa GPT-5.5 tốt hơn trong mọi tác vụ lập trình, nhưng cho thấy lợi thế rõ ở benchmark cụ thể này.
Nếu cần một ứng viên mô hình mở, Kimi K2.6 có thể vào shortlist. Hugging Face mô tả Kimi K2.6 là open-source, native multimodal agentic model; Kilo AI ghi mô hình này đạt 58,6% trên SWE-Bench Pro và 80,2% trên SWE-Bench Verified. Tuy nhiên, vì các điểm này chưa xuất hiện trong cùng một bảng chính thức có GPT-5.5 và Claude Opus 4.7, cách an toàn nhất là chạy lại trên bộ tác vụ của chính bạn.
Nếu đang cân nhắc DeepSeek V4, nên chờ benchmark có thể trích dẫn hoặc tự đánh giá lại. Trong bộ nguồn của bài này chưa có điểm số DeepSeek V4 đủ kiểm chứng. Gán điểm hoặc xếp hạng cưỡng ép trong trường hợp này dễ gây hiểu nhầm hơn là để trống.
Vì sao bài này không chọn “người thắng chung cuộc”?
Sai lầm phổ biến khi đọc benchmark LLM là trộn điểm từ nhiều nguồn, nhiều cách chạy, nhiều loại tác vụ rồi xem như cùng một thước đo. Bài này chia dữ liệu thành ba tầng:
Benchmark chung trong cùng bảng: ví dụ GPT-5.5 và Claude Opus 4.7 trong bảng OpenAI ở SWE-Bench Pro và Terminal-Bench 2.0. Đây là nhóm phù hợp nhất để so trực tiếp.
Vendor eval hoặc partner eval được tổng hợp bởi bên thứ ba: ví dụ SWE-Bench Verified và CursorBench của Claude Opus 4.7. Nhóm này vẫn hữu ích, nhưng cần để ý nguồn và cách chạy đánh giá.
Dữ liệu thiếu kiểm chứng chéo hoặc thiếu số có thể trích dẫn: ví dụ Kimi K2.6 hiện chủ yếu dựa vào bài viết bên thứ ba cho điểm SWE-Bench, còn DeepSeek V4 thiếu benchmark đủ dùng trong bộ nguồn của bài này.
Theo cách đọc đó, kết luận gọn lại là: Claude Opus 4.7 dẫn GPT-5.5 trên SWE-Bench Pro; GPT-5.5 dẫn Claude Opus 4.7 trên Terminal-Bench 2.0; Kimi K2.6 có điểm SWE-Bench đáng chú ý nhưng mức bằng chứng thấp hơn; DeepSeek V4 hiện nên được xếp vào nhóm thiếu dữ liệu.
Với đội phát triển sản phẩm, bảng trên chỉ nên là điểm khởi đầu. Sau khi chọn shortlist, bước quan trọng hơn là chạy thử trên chính tác vụ của bạn: loại repository, ngôn ngữ lập trình, bộ test, cách gọi công cụ, độ trễ, chi phí và khả năng phục hồi khi mô hình làm sai. Kết quả đó thường đáng tin hơn nhiều so với một bảng “xếp hạng bốn mô hình” nhìn có vẻ gọn nhưng thiếu cùng chuẩn đo.
Expert-SWE, internal eval: 73,1%; OpenAI ghi chú các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên eval này.
A-: SWE-Bench Pro và Terminal-Bench 2.0 nằm trong cùng bảng của OpenAI, có thể đối chiếu trực tiếp với Claude Opus 4.7; Expert-SWE là đánh giá nội bộ nên cần đọc thận trọng.
Claude Opus 4.7
64,3%
87,6%
Kimi K2.6
58,6%
80,2%
—
Trang Hugging Face mô tả Kimi K2.6 là mô hình open-source, native multimodal agentic.
B, còn hạn chế: điểm SWE-Bench đến từ bài viết bên thứ ba; trong nguồn của bài này chưa có bảng benchmark chính thức đầy đủ để kiểm chứng chéo cùng GPT-5.5 và Claude Opus 4.7.
DeepSeek V4
—
—
—
—
C, thiếu dữ liệu: không có benchmark DeepSeek V4 có thể trích dẫn trong bộ nguồn của bài này, nên không xếp hạng bằng số.
Nên nhìn benchmark nào trước?
SWE-Bench Pro: Claude Opus 4.7 vượt GPT-5.5 trong bảng có thể đối chiếu
SWE-Bench thường được dùng để nhìn năng lực xử lý tác vụ kỹ thuật phần mềm, đặc biệt các bài toán gần với sửa lỗi hoặc giải quyết issue trong kho mã. Trong bảng đánh giá GPT-5.5 của OpenAI, Claude Opus 4.7 đạt 64,3% trên SWE-Bench Pro, cao hơn GPT-5.5 ở mức 58,6%. Đây là một trong những so sánh sạch nhất của bài này, vì cả hai mô hình xuất hiện trong cùng một bảng nguồn.
Kimi K2.6 cũng được bài viết của Kilo AI ghi nhận ở mức 58,6% trên SWE-Bench Pro, nhìn bề ngoài ngang GPT-5.5. Tuy nhiên, con số này không nằm trong cùng bảng đối chiếu với GPT-5.5 và Claude Opus 4.7, nên nên xem là tín hiệu tham khảo, không phải kết luận thắng thua cùng chuẩn đo.
Terminal-Bench 2.0: GPT-5.5 dẫn trước Claude Opus 4.7
Ở Terminal-Bench 2.0, bảng OpenAI ghi GPT-5.5 đạt 82,7%, còn Claude Opus 4.7 đạt 69,4%. Nếu sản phẩm của bạn giống một coding agent làm việc trong môi trường dòng lệnh, gọi công cụ, chạy lệnh và xử lý quy trình trong terminal, GPT-5.5 đáng được đưa lên đầu danh sách thử nghiệm.
Điểm cần nhớ: bài này không có số Terminal-Bench 2.0 có thể trích dẫn cho Kimi K2.6 hoặc DeepSeek V4. Vì vậy, không thể lập bảng xếp hạng đủ bốn mô hình ở tiêu chí này.
SWE-Bench Verified: Claude cao hơn Kimi, nhưng nguồn không cùng chuẩn
Claude Opus 4.7 được các bài tổng hợp bên thứ ba ghi 87,6% trên SWE-Bench Verified; Verdent mô tả con số này là Anthropic-conducted và có áp dụng memorization screens. Kimi K2.6 được bài viết của Kilo AI ghi 80,2% trên SWE-Bench Verified.
Hai con số đều có giá trị tham khảo, nhưng không nên đọc như một phép so “cân bằng tuyệt đối” như cặp SWE-Bench Pro và Terminal-Bench 2.0 trong cùng bảng OpenAI.
Expert-SWE: có tín hiệu, nhưng không nên dùng để trao cúp
GPT-5.5 đạt 73,1% trên Expert-SWE, nhưng OpenAI tự gắn nhãn đây là internal eval và ghi chú rằng các phòng thí nghiệm khác đã thấy dấu hiệu memorization trên eval này. Vì vậy, Expert-SWE có thể là tín hiệu về năng lực trong bộ đánh giá nội bộ của OpenAI, nhưng không nên dùng làm nền tảng chính để xếp hạng cả bốn mô hình.
Chọn mô hình theo việc cần làm, đừng chỉ nhìn “tổng điểm”
Nếu bài toán của bạn gần với sửa issue GitHub hoặc tác vụ kỹ thuật phần mềm phức tạp, Claude Opus 4.7 nên được thử sớm. Trên SWE-Bench Pro, bộ dữ liệu có thể đối chiếu trực tiếp nhất trong bài này, Claude Opus 4.7 đạt 64,3%, cao hơn GPT-5.5 ở mức 58,6%. Vellum cũng đặt cặp số này trong bối cảnh giải quyết issue GitHub thực tế.
Nếu quy trình của bạn thiên về coding agent vận hành trong terminal, GPT-5.5 là ứng viên mạnh. Điểm Terminal-Bench 2.0 có thể trích dẫn của GPT-5.5 là 82,7%, cao hơn Claude Opus 4.7 ở mức 69,4%. Điều này không có nghĩa GPT-5.5 tốt hơn trong mọi tác vụ lập trình, nhưng cho thấy lợi thế rõ ở benchmark cụ thể này.
Nếu cần một ứng viên mô hình mở, Kimi K2.6 có thể vào shortlist. Hugging Face mô tả Kimi K2.6 là open-source, native multimodal agentic model; Kilo AI ghi mô hình này đạt 58,6% trên SWE-Bench Pro và 80,2% trên SWE-Bench Verified. Tuy nhiên, vì các điểm này chưa xuất hiện trong cùng một bảng chính thức có GPT-5.5 và Claude Opus 4.7, cách an toàn nhất là chạy lại trên bộ tác vụ của chính bạn.
Nếu đang cân nhắc DeepSeek V4, nên chờ benchmark có thể trích dẫn hoặc tự đánh giá lại. Trong bộ nguồn của bài này chưa có điểm số DeepSeek V4 đủ kiểm chứng. Gán điểm hoặc xếp hạng cưỡng ép trong trường hợp này dễ gây hiểu nhầm hơn là để trống.
Vì sao bài này không chọn “người thắng chung cuộc”?
Sai lầm phổ biến khi đọc benchmark LLM là trộn điểm từ nhiều nguồn, nhiều cách chạy, nhiều loại tác vụ rồi xem như cùng một thước đo. Bài này chia dữ liệu thành ba tầng:
Benchmark chung trong cùng bảng: ví dụ GPT-5.5 và Claude Opus 4.7 trong bảng OpenAI ở SWE-Bench Pro và Terminal-Bench 2.0. Đây là nhóm phù hợp nhất để so trực tiếp.
Vendor eval hoặc partner eval được tổng hợp bởi bên thứ ba: ví dụ SWE-Bench Verified và CursorBench của Claude Opus 4.7. Nhóm này vẫn hữu ích, nhưng cần để ý nguồn và cách chạy đánh giá.
Dữ liệu thiếu kiểm chứng chéo hoặc thiếu số có thể trích dẫn: ví dụ Kimi K2.6 hiện chủ yếu dựa vào bài viết bên thứ ba cho điểm SWE-Bench, còn DeepSeek V4 thiếu benchmark đủ dùng trong bộ nguồn của bài này.
Theo cách đọc đó, kết luận gọn lại là: Claude Opus 4.7 dẫn GPT-5.5 trên SWE-Bench Pro; GPT-5.5 dẫn Claude Opus 4.7 trên Terminal-Bench 2.0; Kimi K2.6 có điểm SWE-Bench đáng chú ý nhưng mức bằng chứng thấp hơn; DeepSeek V4 hiện nên được xếp vào nhóm thiếu dữ liệu.
Với đội phát triển sản phẩm, bảng trên chỉ nên là điểm khởi đầu. Sau khi chọn shortlist, bước quan trọng hơn là chạy thử trên chính tác vụ của bạn: loại repository, ngôn ngữ lập trình, bộ test, cách gọi công cụ, độ trễ, chi phí và khả năng phục hồi khi mô hình làm sai. Kết quả đó thường đáng tin hơn nhiều so với một bảng “xếp hạng bốn mô hình” nhìn có vẻ gọn nhưng thiếu cùng chuẩn đo.
A-/B: SWE-Bench Pro và Terminal-Bench 2.0 có thể so trực tiếp với GPT-5.5 trong cùng bảng; SWE-Bench Verified và CursorBench trong nguồn bài này chủ yếu đến từ tổng hợp bên thứ ba, trong đó Verdent ghi SWE-Bench Verified là Anthropic-conducted và CursorBench là partner eval.
69,4%
CursorBench 70%.
A-/B: SWE-Bench Pro và Terminal-Bench 2.0 có thể so trực tiếp với GPT-5.5 trong cùng bảng; SWE-Bench Verified và CursorBench trong nguồn bài này chủ yếu đến từ tổng hợp bên thứ ba, trong đó Verdent ghi SWE-Bench Verified là Anthropic-conducted và CursorBench là partner eval.
openai.comIntroducing GPT-5.5
huggingface.comoonshotai/Kimi-K2.6 - Hugging Face
blog.kilo.aiKimi K2.6 Has Arrived: An Open-Weight Powerhouse for Agentic Work
buildfastwithai.comClaude Opus 4.7: Full Review, Benchmarks & Features (2026)
verdent.aiClaude Opus 4.7: What Changed for Coding Agents (April 2026)