Câu trả lờiĐã xuất bản27 nguồn
Skild AI S1: Robot xem một video và thực hiện nhiệm vụ chưa từng biết
Skild AI cho biết S1 có thể xem một video về nhiệm vụ chưa từng gặp, kéo dài tới 10 phút, rồi thực hiện mà không thay đổi trọng số mô hình hay thu thập dữ liệu riêng cho nhiệm vụ đó. Các màn trình diễn gồm pha cà phê pour over, thay chậu cây, lắp ráp bộ linh kiện và lật bánh pancake; mô hình được cho là có thể thích...
Đăng bởiBiên tập bằng GPT-5.6 LunaHình ảnh được tạo bằng GPT Image 1.5
Câu trả lời nghiên cứu
Bài học chính
- Skild AI cho biết S1 có thể xem một video về nhiệm vụ chưa từng gặp, kéo dài tới 10 phút, rồi thực hiện mà không thay đổi trọng số mô hình hay thu thập dữ liệu riêng cho nhiệm vụ đó.
- Các màn trình diễn gồm pha cà phê pour over, thay chậu cây, lắp ráp bộ linh kiện và lật bánh pancake; mô hình được cho là có thể thích nghi khi đồ vật hoặc bối cảnh thay đổi.
- Trong đánh giá nội bộ của Skild AI, chính sách được nhắc bằng video đạt tỷ lệ thành công trung bình 66% mỗi bước, so với 9% ở mô hình VLA được nhắc bằng ngôn ngữ.
- Công nghệ đang hướng tới robot công nghiệp, nhưng dữ liệu công khai chưa đủ để xác nhận các chỉ số vận hành thực tế như thời gian hoạt động, năng suất, tỷ lệ lỗi hay hiệu quả đầu tư.
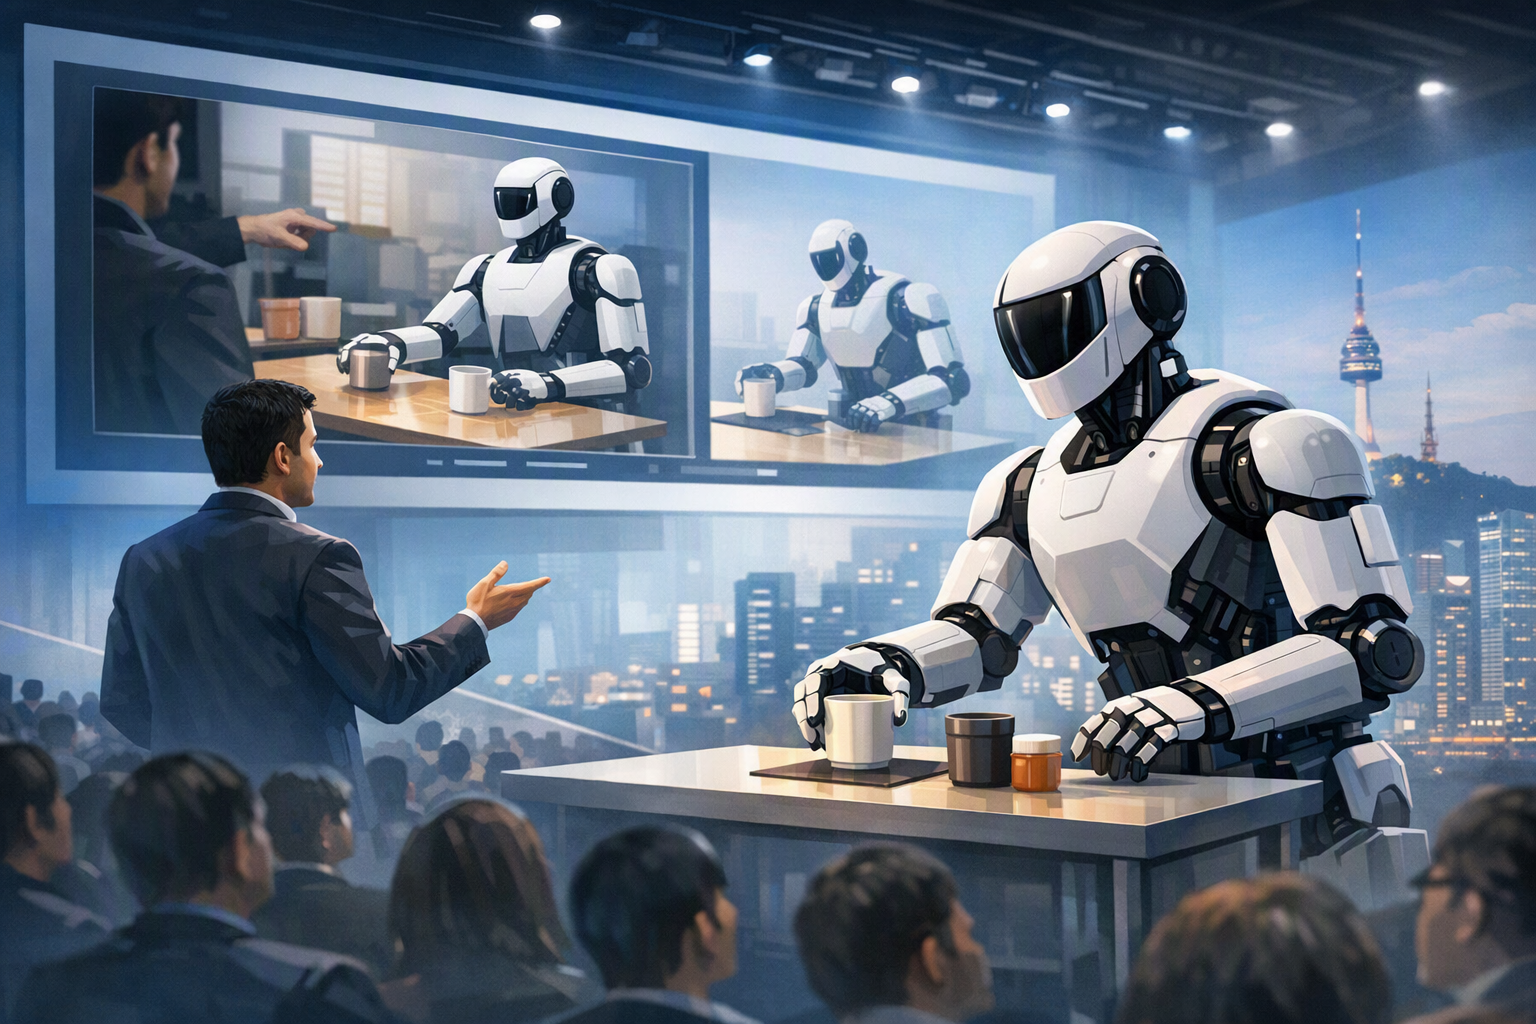
Prompt AI
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Skild AI’s S1 robotics foundation model, unveiled by co-founder Abhinav Gupta at SMARTCLOUD SHOW 2026 in Seoul on August 25, 2026, a. Article summary: S1 is Skild AI’s flagship robotics foundation model for in-context learning: a robot watches one video demonstration—including an unseen task lasting up to 10 minutes—and then executes it without collecting task-specific. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Skild AI S1 là mô hình nền tảng dành cho robot, được xây dựng quanh học trong ngữ cảnh (in-context learning). Thay vì phải huấn luyện lại robot cho từng công việc, S1 xem một video minh họa và dùng video đó như bản hướng dẫn thực thi. Skild AI cho biết S1 có thể xử lý những nhiệm vụ chưa từng xuất hiện trong quá trình tiền huấn luyện, kéo dài tới 10 phút, mà không cần tinh chỉnh riêng cho nhiệm vụ hay thay đổi trọng số mô hình. 1
5
Đây là một hướng đi đáng chú ý đối với AI vật lý — các hệ thống AI có khả năng cảm nhận và tác động lên thế giới thực. Tuy nhiên, S1 chưa phải bằng chứng cho thấy robot đa năng đã sẵn sàng làm mọi việc trong gia đình hoặc nhà máy. Những kết quả nổi bật hiện vẫn chủ yếu đến từ màn trình diễn, dữ liệu và đánh giá do Skild AI công bố; các thử nghiệm độc lập sẽ rất quan trọng.
S1 khác gì so với cách dạy robot truyền thống?
Nhiều hệ thống học robot được xây dựng cho một nhiệm vụ cụ thể, một loại thân robot cụ thể hoặc một nhóm điều kiện vận hành nhất định. S1 đi theo hướng khác: coi video minh họa như một lời nhắc có thể thực thi. Mô hình phải suy ra mục tiêu, thứ tự thao tác, mối quan hệ giữa các đồ vật và những điều chỉnh vật lý cần thiết để robot tái hiện nhiệm vụ. 1
3
Nói robot “pha cà phê” có thể giúp xác định mục tiêu, nhưng một video còn cho thấy trình tự công việc, cách cầm nắm, cách sử dụng dụng cụ và cách xử lý nhiệm vụ qua nhiều bước. Theo lập luận của Skild AI, dạng lời nhắc giàu thông tin hơn này giúp S1 khái quát hóa sang các nhiệm vụ dài và chưa xuất hiện trong dữ liệu tiền huấn luyện. 1
5
Công ty mô tả phương pháp này như phiên bản tương đương với việc nhắc một mô hình ngôn ngữ: năng lực cốt lõi của mô hình giữ nguyên, còn video cung cấp bối cảnh cụ thể cho nhiệm vụ mới.
Pha cà phê, thay chậu cây và lật bánh pancake
Skild AI đã công bố các màn trình diễn S1 thực hiện những quy trình thao tác như:
- Pha cà phê pour-over
- Thay chậu cây
- Lắp ráp một bộ linh kiện
- Lật bánh pancake
Một số màn trình diễn kéo dài tới 10 phút và gồm hàng chục thao tác liên tiếp. 1
3
5
Trong các thử nghiệm định tính, Skild AI cho biết S1 không chỉ phát lại một chuỗi chuyển động đã ghi nhớ. Mô hình được cho là có thể phản ứng khi bối cảnh thay đổi, thử lại sau một số lỗi, dùng chiếc cốc thay cho bình tưới không có sẵn, đồng thời sửa cách người hướng dẫn xử lý quả trứng vụng về thay vì sao chép nguyên xi. Đây là những dấu hiệu cho thấy hành vi linh hoạt hơn, nhưng chỉ riêng các video trình diễn chưa thể chứng minh độ tin cậy trong nhiều môi trường khác nhau. 5
So sánh với mô hình VLA được nhắc bằng ngôn ngữ
VLA là viết tắt của vision-language-action, tức mô hình kết hợp khả năng nhìn, hiểu ngôn ngữ và tạo hành động cho robot. So sánh cụ thể nhất do Skild AI cung cấp đến từ một đánh giá nội bộ về các nhiệm vụ chưa từng thấy.
Với 100.000 giờ dữ liệu huấn luyện, công ty báo cáo chính sách được nhắc bằng video của S1 đạt tỷ lệ thành công trung bình 66% ở mỗi bước, trong khi mô hình VLA đối chứng được nhắc bằng ngôn ngữ đạt 9%. 1
4
Skild AI cũng cho biết khi điều kiện triển khai thay đổi mạnh — chẳng hạn đồ vật khác với trong video minh họa hoặc kế hoạch thực hiện yêu cầu dùng tay đối diện — mô hình VLA suy giảm nhiều hơn S1 tới khoảng ba lần. 1
Một phép so sánh khác do công ty đưa ra ước tính rằng một video prompt có thể tạo ra hiệu suất tương đương khoảng 380 lượt hậu huấn luyện dành riêng cho từng nhiệm vụ trên một chính sách đã được tiền huấn luyện. 1
Các con số này cho thấy lý do video có thể trở thành cách hướng dẫn robot hiệu quả hơn: video truyền tải không chỉ kết quả mong muốn mà còn cả trình tự, thời điểm, cách bố trí đồ vật, cách dùng công cụ và chiến lược thao tác. Dù vậy, cần đọc chúng đúng bối cảnh: đây là bằng chứng nội bộ của Skild AI, chưa phải kết quả đối đầu được bên thứ ba tái lập. Các nguồn được cung cấp chưa bao gồm bài báo khoa học công khai, trọng số mô hình hay một đánh giá tiêu chuẩn độc lập. 4
15
S1 bắt đầu làm việc nhanh đến đâu?
Skild AI mô tả S1 là hệ thống hoạt động theo thời gian thực sau khi xem video. Các thông tin quanh thời điểm ra mắt cho biết robot có thể thực hiện nhiệm vụ ngay sau khi quan sát phần minh họa. 2
5
Tuy nhiên, hiện chưa đủ bằng chứng để khẳng định một mốc cụ thể như “trong vài giây” hay “sau 11 phút” cho toàn bộ hệ thống. Thời gian được kiểm chứng từ lúc video kết thúc đến khi robot bắt đầu hành động chưa được các nguồn cung cấp xác lập rõ ràng.
Đây là điểm không nhỏ trong môi trường công nghiệp. Thời gian chuẩn bị, độ trễ suy luận, các bước kiểm tra an toàn và khả năng phục hồi sau lỗi đôi khi quan trọng không kém tỷ lệ hoàn thành nhiệm vụ trên bản trình diễn.
Chiến lược dữ liệu của Skild AI
Skild AI cho rằng một hệ thống dữ liệu quy mô lớn giúp họ xây dựng mô hình robot đa năng. Công ty mô tả việc kết hợp mô phỏng quy mô lớn, video trên internet về hành động của con người, dữ liệu robot, điều khiển từ xa và dữ liệu từ các hệ thống triển khai thực tế. Tài liệu về vòng gọi vốn Series C cũng nói đến “vòng lặp dữ liệu”: robot càng được triển khai ở nhiều nơi thì càng tạo thêm kinh nghiệm để cải thiện mô hình trên các robot và môi trường khác nhau. 37
Tại SMARTCLOUD SHOW, đồng sáng lập Abhinav Gupta được đưa tin là nói Skild AI sử dụng “mọi loại” phương pháp thu thập dữ liệu robot và sở hữu lượng dữ liệu nhiều hơn đối thủ 100 đến 1.000 lần. Đây là tuyên bố của công ty, không phải phép so sánh ngành đã được kiểm toán công khai. 6
Về thực tế, mỗi nguồn dữ liệu đảm nhiệm một vai trò khác nhau: video con người cung cấp ví dụ về đồ vật và hành động; mô phỏng mở rộng số lượng thân robot và môi trường có thể thử nghiệm; còn dữ liệu robot thật giúp nối những khái niệm đó với điều khiển vật lý ngoài đời.
“Bộ não omni-bodied” nghĩa là gì?
S1 nằm trong chiến lược rộng hơn của Skild AI về một bộ não robot “omni-bodied”. Thuật ngữ này không có nghĩa robot hai chân, bốn chân, robot bánh xe và cánh tay robot sẽ chuyển động giống hệt nhau. Chúng có khớp, cảm biến, chi, bánh xe và giới hạn hành động khác nhau. 45
Ý tưởng là mô hình học những quy luật vật lý có thể dùng chung trên nhiều nền tảng, sau đó chuyển hóa dự đoán thành hành động phù hợp với từng robot. Nhờ vậy, một mô hình có thể chia sẻ kiến thức giữa nhiều hình thái cơ thể, đồng thời điều chỉnh đầu ra theo các cơ cấu chấp hành và cảm biến mà robot đó thực sự có. 45
Cách tiếp cận này nhằm giảm nhu cầu xây dựng và duy trì một mô hình hoàn toàn riêng cho từng cấu hình phần cứng. Skild AI cũng cho biết họ huấn luyện trên một số lượng lớn thân robot mô phỏng để mô hình học được hành vi vật lý tổng quát hơn. 42
45
S1 đang được triển khai ở đâu?
Skild AI đã công bố hợp tác với ABB Robotics và Universal Robots để tích hợp phần mềm vào các hệ thống robot công nghiệp. Reuters cũng đưa tin Skild AI và Nvidia đang triển khai “bộ não robot” trên các dây chuyền lắp ráp liên quan đến hệ thống Nvidia Blackwell. 34
44
Những thông báo này cho thấy công nghệ đã có con đường để thử nghiệm và tích hợp thương mại, nhưng chưa tạo thành hồ sơ hiệu suất công khai đầy đủ. Các nguồn hiện có chưa xác lập những số liệu được kiểm toán độc lập về năng suất nhà máy, thời gian hoạt động, tỷ lệ lỗi, sự cố an toàn hay lợi tức đầu tư.
Nói cách khác, việc triển khai chứng minh công nghệ đang được thử nghiệm hoặc tích hợp — không đồng nghĩa robot đã thay thế tự động hóa truyền thống trên quy mô lớn.
Định giá hơn 14 tỷ USD nói lên điều gì?
Sự quan tâm của nhà đầu tư dành cho Skild AI rất lớn. Bloomberg đưa tin công ty huy động 1,4 tỷ USD trong vòng Series C do SoftBank dẫn dắt, qua đó được định giá hơn 14 tỷ USD — tăng hơn ba lần chỉ trong khoảng bảy tháng. 17
Mức định giá này phản ánh niềm tin rằng phần mềm robot có thể trở thành một lớp nền tảng có khả năng mở rộng trên nhiều loại phần cứng. Một số báo cáo đưa tổng vốn Skild AI huy động được lên hơn 1,8 tỷ USD, nhưng các con số thay đổi tùy nguồn và không nên được xem là tổng số đã kiểm toán chính thức. 18
21
22
Cụm từ “khoảnh khắc ChatGPT của robot” nên được hiểu là một phép ví von đầy kỳ vọng, chưa phải kết luận đã được chứng minh. S1 gợi mở khả năng robot sẽ tiếp nhận kỹ năng mới bằng cách xem minh họa, thay vì phải được huấn luyện lại cho từng công việc. Nhà đầu tư Ravi Mhatre gọi đây là “khoảnh khắc GPT-3” đối với các nhiệm vụ lao động kéo dài nhiều bước, nhưng đó là đánh giá của nhà đầu tư chứ không phải xác nhận khoa học độc lập. 10
Kết luận
Điểm quan trọng nhất của S1 không đơn giản là robot có thể bắt chước một video. Điều đáng chú ý là một mô hình nền tảng có thể dùng một lần minh họa để kết hợp các kỹ năng, thích nghi với bối cảnh thay đổi và thực hiện một chuỗi thao tác dài mà không cập nhật trọng số cho riêng nhiệm vụ đó.
Kết quả được Skild AI báo cáo — 66% so với 9% — cùng các màn trình diễn kéo dài nhiều phút khiến tuyên bố về S1 có ý nghĩa kỹ thuật đáng kể. 1
4 Nhưng vế còn lại cũng quan trọng không kém: bằng chứng công khai hiện vẫn chủ yếu đến từ tài liệu của công ty, các màn trình diễn được lựa chọn và thông báo triển khai ban đầu.
Cho đến khi các nhóm nghiên cứu bên ngoài tái lập kết quả trong điều kiện tiêu chuẩn, còn khách hàng công nghiệp công bố dữ liệu về độ tin cậy và an toàn, S1 nên được xem là một hướng đi đầy hứa hẹn của AI vật lý — chứ chưa phải bằng chứng dứt khoát rằng “bộ não robot đa năng” đã xuất hiện.
Studio Global AI
Tiếp tục nghiên cứu của bạn
Trang này bao gồm câu trả lời dựa trên nguồn mà bạn có thể tiếp tục bên trong Studio Global.
Người ta cũng hỏi
Câu trả lời ngắn gọn cho "Skild AI S1: Robot xem một video và thực hiện nhiệm vụ chưa từng biết" là gì?
Skild AI cho biết S1 có thể xem một video về nhiệm vụ chưa từng gặp, kéo dài tới 10 phút, rồi thực hiện mà không thay đổi trọng số mô hình hay thu thập dữ liệu riêng cho nhiệm vụ đó.
Những điểm chính cần xác nhận đầu tiên là gì?
Skild AI cho biết S1 có thể xem một video về nhiệm vụ chưa từng gặp, kéo dài tới 10 phút, rồi thực hiện mà không thay đổi trọng số mô hình hay thu thập dữ liệu riêng cho nhiệm vụ đó. Các màn trình diễn gồm pha cà phê pour over, thay chậu cây, lắp ráp bộ linh kiện và lật bánh pancake; mô hình được cho là có thể thích nghi khi đồ vật hoặc bối cảnh thay đổi.
Tôi nên làm gì tiếp theo trong thực tế?
Trong đánh giá nội bộ của Skild AI, chính sách được nhắc bằng video đạt tỷ lệ thành công trung bình 66% mỗi bước, so với 9% ở mô hình VLA được nhắc bằng ngôn ngữ.
Nguồn
skild.aiIntroducing S1: In-Context Learning for Robotics - Skild AI
runtimewire.comSkild AI ships S1, a robot model prompted by one video
zerogantry.comSkild AI S1 Achieves 10-Minute Tasks from One Video Prompt
datanorth.aiSkild AI S1: Robot Model Learns Tasks From One Video - DataNorth AI
x.com"Scaling laws for in-context learning for robotics, perhaps ...