Câu trả lờiĐã xuất bản13 nguồn
LightNav-0: Một mô hình AI dùng ảnh RGB và câu lệnh để điều hướng robot
LightNav 0 là chính sách điều hướng mã nguồn mở dựa trên Qwen3 VL, nhận ảnh RGB hướng trước cùng câu lệnh ngôn ngữ để dẫn đường, tìm vật thể được gọi tên và bám mục tiêu bằng một mô hình chung. Dự án được Light Origins công bố ngày 1/9/2026; mốc 17/9 trên GitHub là thời điểm của một commit cập nhật sau đó, không phả...
Đăng bởiBiên tập bằng GPT-5.6 TerraHình ảnh được tạo bằng GPT Image 2
Câu trả lời nghiên cứu
Bài học chính
- LightNav 0 là chính sách điều hướng mã nguồn mở dựa trên Qwen3 VL, nhận ảnh RGB hướng trước cùng câu lệnh ngôn ngữ để dẫn đường, tìm vật thể được gọi tên và bám mục tiêu bằng một mô hình chung.
- Dự án được Light Origins công bố ngày 1/9/2026; mốc 17/9 trên GitHub là thời điểm của một commit cập nhật sau đó, không phải ngày phát hành ban đầu.
- Ý tưởng cốt lõi là một giao diện token thống nhất: mô hình chỉ vào vùng có thể đi, chỉ vào mục tiêu, rồi sinh ra quỹ đạo điểm mốc ngắn thay vì dùng các đầu dự đoán riêng cho từng nhiệm vụ.
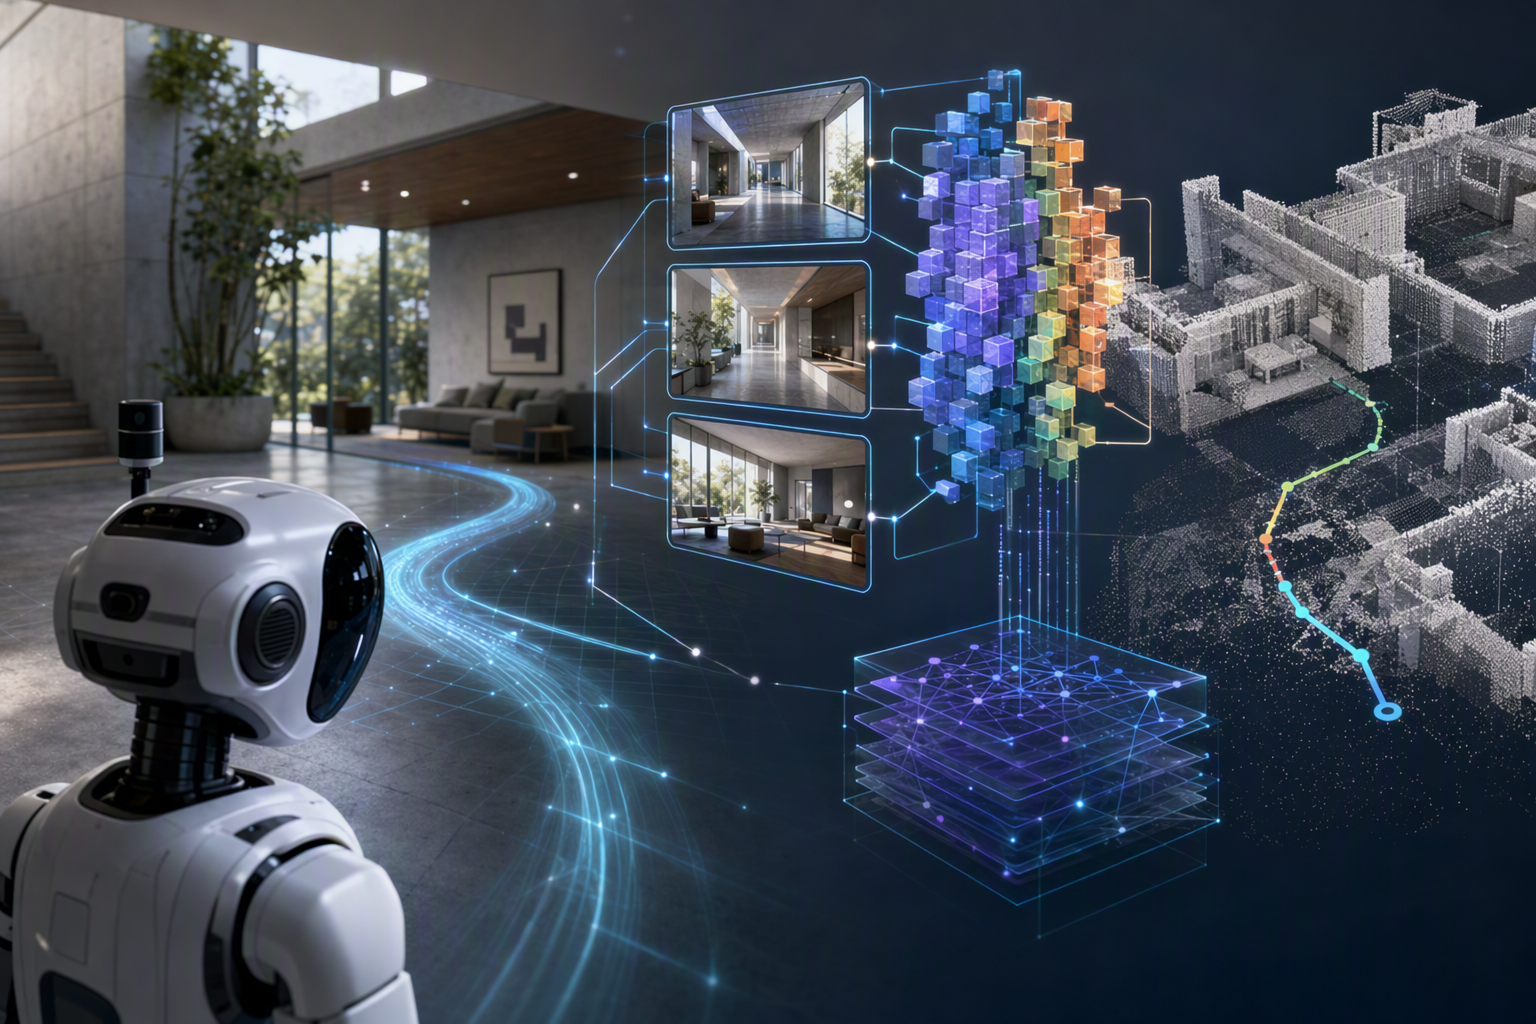
Prompt AI
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Light Origins’ open-sourced LightNav-0 navigation model, published on September 17, 2026, and how do its Qwen3-VL-4B backbone, unifi. Article summary: LightNav-0 is a compact, general-purpose embodied-navigation policy built from Qwen3-VL-4B-Instruct. It uses a single stream of egocentric RGB observations plus a language instruction to handle route following, open-voca. Topic tags: general, academic, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, char
LightNav-0 là nỗ lực mã nguồn mở của Light Origins nhằm xây dựng một chính sách điều hướng đa dụng cho robot: cùng một mô hình thị giác–ngôn ngữ có thể đọc ảnh RGB từ camera hướng trước, hiểu câu lệnh tự nhiên, rồi tạo ra các điểm mốc chuyển động (waypoint). Mô hình được xây dựng trên Qwen3-VL và hướng tới ba dạng bài toán trong một hệ thống: đi theo chỉ dẫn, điều hướng đến vật thể được mô tả bằng ngôn ngữ mở và bám theo mục tiêu thị giác. Thay vì tách đầu dự đoán riêng cho từng nhiệm vụ, LightNav-0 dùng một cách biểu diễn đầu ra chung. 1
5
Light Origins cho biết họ đã phát hành mô hình, mã nguồn và báo cáo kỹ thuật vào ngày 1/9/2026. Mốc 17/9 xuất hiện trên GitHub phản ánh một commit cập nhật kho mã về sau, không phải ngày công bố ban đầu. 5
10
Một “ngôn ngữ” điều hướng chung cho nhiều nhiệm vụ
Thông thường, robot đi theo hướng dẫn như “đi qua cửa rồi rẽ trái”, robot đi tìm một đồ vật, và robot bám theo một mục tiêu có thể cần các mô-đun dự đoán khác nhau. LightNav-0 giữ nguyên định dạng đầu ra cho các tình huống đó.
Trước hết, mô hình dự đoán hai token trỏ vị trí trên lưới ảnh:
- Điểm khả dụng (affordance point): vùng hoặc hướng cục bộ mà robot có thể di chuyển qua.
- Điểm vật thể (object point): mục tiêu cần đi tới hoặc đối tượng cần bám theo.
Sau đó, mô hình tạo ba token hành động lượng tử hóa vector dư (residual vector-quantized action tokens). Các token này được giải mã thành một quỹ đạo gồm 10 waypoint trong không gian SE(2), tức vị trí trên mặt phẳng kèm hướng quay. Theo cách biểu diễn trong bài báo, các bảng mã phân cấp lần lượt đưa ra quyết định ở khoảng cách khoảng 0,9 m, rồi tinh chỉnh ở mức 7 cm và 4 cm. 1
Nhờ vậy, câu lệnh hay tên vật thể sẽ thay đổi mục tiêu của hành vi, còn mô hình luôn biểu đạt quyết định theo cùng một quy trình: xác định không gian có thể đi, xác định đích, sau đó vẽ ra đường đi. Nhóm tác giả gọi đây là giao diện token thống nhất, không phụ thuộc vào nhiệm vụ, bối cảnh hay hình thái robot. 1
Vai trò của nền tảng Qwen3-VL
LightNav-0 khởi đầu từ Qwen3-VL-4B-Instruct, một mô hình thị giác–ngôn ngữ, rồi tinh chỉnh để liên kết năng lực hiểu không gian với hành động điều hướng. Mục tiêu được nêu là khai thác hiểu biết không gian của mô hình thị giác–ngôn ngữ cho robot, thay vì phát triển một chính sách riêng cho từng nhiệm vụ hoặc từng nền tảng robot. 1
Trong các đánh giá đơn thị giác được báo cáo, mô hình sử dụng đầu vào thị giác theo góc nhìn của robot và không dựa vào cảm biến chiều sâu, đo quãng đường (odometry) hay camera toàn cảnh. Giao diện vì thế khá trực tiếp: ảnh camera và ngôn ngữ đi vào; ý định không gian dạng token và waypoint đi ra. 1
Tuy nhiên, một mô hình đơn giản ở tầng chính sách không đồng nghĩa toàn bộ hệ thống robot cũng đơn giản. Khi triển khai thực tế, robot vẫn cần hiệu chuẩn camera, bộ điều khiển cấp thấp để thực thi waypoint an toàn, cùng quá trình kiểm thử phù hợp với phần cứng và môi trường cụ thể.
Real2Sim2Real: tạo dữ liệu điều hướng quy mô lớn từ cảnh mô phỏng
Thu thập các bản trình diễn chất lượng cao trên robot thật thường tốn kém và phụ thuộc nhiều vào điều khiển từ xa (teleoperation). Đường ống Real2Sim2Real của Light Origins nhằm chuyển phần lớn công việc này sang các môi trường mô phỏng có thể tái sử dụng.
Theo công ty, quy trình này chuyển đổi hơn 2.000 cảnh trong nhà và ngoài trời lấy từ internet thành tài sản mô phỏng, từ đó tổng hợp hơn 4.000 giờ dữ liệu kinh nghiệm thị giác–ngôn ngữ–hành động được căn chỉnh. 10 Chuỗi huấn luyện được báo cáo gồm ba giai đoạn:
- huấn luyện giữa kỳ về suy luận có thân thể (embodied-reasoning mid-training);
- tinh chỉnh có giám sát cho điều hướng;
- học tăng cường trực tuyến.
10
Trong lúc tạo dữ liệu, dự án ngẫu nhiên hóa trường nhìn, chiều cao và góc ngẩng/cúi của camera. Mục đích là giảm việc mô hình phụ thuộc vào một vị trí gắn camera cố định và cải thiện khả năng chuyển sang các hình thái robot khác nhau. 1
Cách làm này có thể giảm lượng dữ liệu phải thu qua điều khiển robot lặp đi lặp lại. Nhưng nó chưa chứng minh dữ liệu thế giới thực là không cần thiết: độ trung thực của mô phỏng, khác biệt cảm biến, độ trễ điều khiển, an toàn khi tránh chướng ngại vật và các điều kiện ngoài trời bất thường vẫn là những rủi ro đáng kể khi triển khai.
Kết quả được báo cáo cho thấy gì — và chưa cho thấy gì?
Bài báo báo cáo kết quả dẫn đầu trong 10 bài đánh giá điều hướng mô phỏng đơn thị giác, sử dụng một checkpoint dùng chung. Dự án cũng báo cáo khả năng chuyển đổi không cần tinh chỉnh thêm (zero-shot) sang robot hình người, robot bốn chân, robot bánh xe và robot bay trong các cảnh chưa từng thấy. 1
10
Đây là các tuyên bố đáng chú ý vì chúng kiểm tra liệu một chính sách duy nhất có thể trải rộng qua nhiều nhiệm vụ và nhiều thân robot, thay vì chỉ được tối ưu cho một benchmark. Dù vậy, đây chủ yếu vẫn là kết quả do nhóm tác giả công bố. Việc tái lập độc lập — đặc biệt trên robot thật hoạt động trong môi trường trong nhà và ngoài trời ít bị kiểm soát — mới là phép thử quan trọng hơn đối với tính tổng quát của mô hình.
Nhà phát triển có thể tiếp cận gì?
Kho GitHub công khai mô tả LightNav-0 là mô hình điều hướng hiện thân tổng quát dựa trên Qwen3-VL, sử dụng giao diện token dùng chung. 5 Light Origins cũng cho biết bản phát hành bao gồm mô hình, mã nguồn và báo cáo kỹ thuật.
10
Với các nhóm muốn đánh giá công nghệ này, câu hỏi không chỉ là mô hình có chạy được hay không. Điều quan trọng là đầu vào RGB cộng ngôn ngữ, đầu ra waypoint, cấu hình camera và bộ điều khiển cấp thấp có phù hợp với robot mục tiêu hay không. Một quy trình đánh giá đáng tin cậy nên đối chiếu hiệu năng mô phỏng với thử nghiệm thực địa, kiểm tra các cơ chế dự phòng an toàn, đồng thời xác nhận đúng các tài sản phát hành và điều khoản cấp phép hiện hành trước khi dùng trong sản phẩm hoặc hoạt động thương mại.
Kết luận
LightNav-0 đề xuất một công thức có thể tái sử dụng cho điều hướng robot: dùng mô hình thị giác–ngôn ngữ gọn nhẹ, biểu diễn nhiều nhiệm vụ qua cùng hệ token trỏ điểm và waypoint, rồi tạo phần lớn dữ liệu căn chỉnh bằng đường ống Real2Sim2Real. 1
10
Nếu khả năng chuyển đổi giữa các robot như báo cáo được xác nhận qua thử nghiệm độc lập ngoài đời thực, cách tiếp cận này có thể giúp phát triển điều hướng robot bớt phụ thuộc vào việc thu một bộ dữ liệu điều khiển từ xa mới cho từng nhiệm vụ và từng loại robot. Hiện tại, nên xem đây là một điểm khởi đầu mở, cụ thể về kỹ thuật cho nghiên cứu và triển khai — chưa phải bằng chứng kết luận rằng một camera RGB cùng mô hình ngôn ngữ có thể giải quyết điều hướng tổng quát ở mọi nơi.
Studio Global AI
Tiếp tục nghiên cứu của bạn
Trang này bao gồm câu trả lời dựa trên nguồn mà bạn có thể tiếp tục bên trong Studio Global.
Người ta cũng hỏi
Câu trả lời ngắn gọn cho "LightNav-0: Một mô hình AI dùng ảnh RGB và câu lệnh để điều hướng robot" là gì?
LightNav 0 là chính sách điều hướng mã nguồn mở dựa trên Qwen3 VL, nhận ảnh RGB hướng trước cùng câu lệnh ngôn ngữ để dẫn đường, tìm vật thể được gọi tên và bám mục tiêu bằng một mô hình chung.
Những điểm chính cần xác nhận đầu tiên là gì?
LightNav 0 là chính sách điều hướng mã nguồn mở dựa trên Qwen3 VL, nhận ảnh RGB hướng trước cùng câu lệnh ngôn ngữ để dẫn đường, tìm vật thể được gọi tên và bám mục tiêu bằng một mô hình chung. Dự án được Light Origins công bố ngày 1/9/2026; mốc 17/9 trên GitHub là thời điểm của một commit cập nhật sau đó, không phải ngày phát hành ban đầu.
Tôi nên làm gì tiếp theo trong thực tế?
Ý tưởng cốt lõi là một giao diện token thống nhất: mô hình chỉ vào vùng có thể đi, chỉ vào mục tiêu, rồi sinh ra quỹ đạo điểm mốc ngắn thay vì dùng các đầu dự đoán riêng cho từng nhiệm vụ.