Câu trả lờiĐã xuất bản13 nguồn
Cấy ghép não 253 điện cực giúp người liệt vừa nói vừa ra hiệu qua avatar
Mảng ECoG mật độ cao gồm 253 điện cực được đặt trên vỏ não cảm giác vận động để ghi lại tín hiệu khi người tham gia cố gắng nói và cử động phần thân trên. Các bộ giải mã học máy riêng cho lời nói và cử chỉ biến tín hiệu não thành đầu ra đồng thời cho một avatar cá nhân hóa chỉ trong vài giây.[2][3] Hoạt động thần ki...
Đăng bởiHình ảnh được tạo bằng GPT Image 2
Câu trả lời nghiên cứu
Bài học chính
- Mảng ECoG mật độ cao gồm 253 điện cực được đặt trên vỏ não cảm giác vận động để ghi lại tín hiệu khi người tham gia cố gắng nói và cử động phần thân trên.
- Các bộ giải mã học máy riêng cho lời nói và cử chỉ biến tín hiệu não thành đầu ra đồng thời cho một avatar cá nhân hóa chỉ trong vài giây.[2][3]
- Hoạt động thần kinh khi vừa nói vừa ra hiệu không đơn thuần là phép cộng của hai hoạt động riêng lẻ; vì vậy hệ thống cần được huấn luyện bằng các nhiệm vụ giao tiếp kết hợp.[2][3]
- Nghiên cứu có ba người tham gia bị liệt cả cơ quan phát âm lẫn chi, nhưng đây vẫn là minh chứng nghiên cứu dùng kết nối có dây, chưa phải thiết bị giao tiếp sẵn có trong lâm sàng.[2][3]
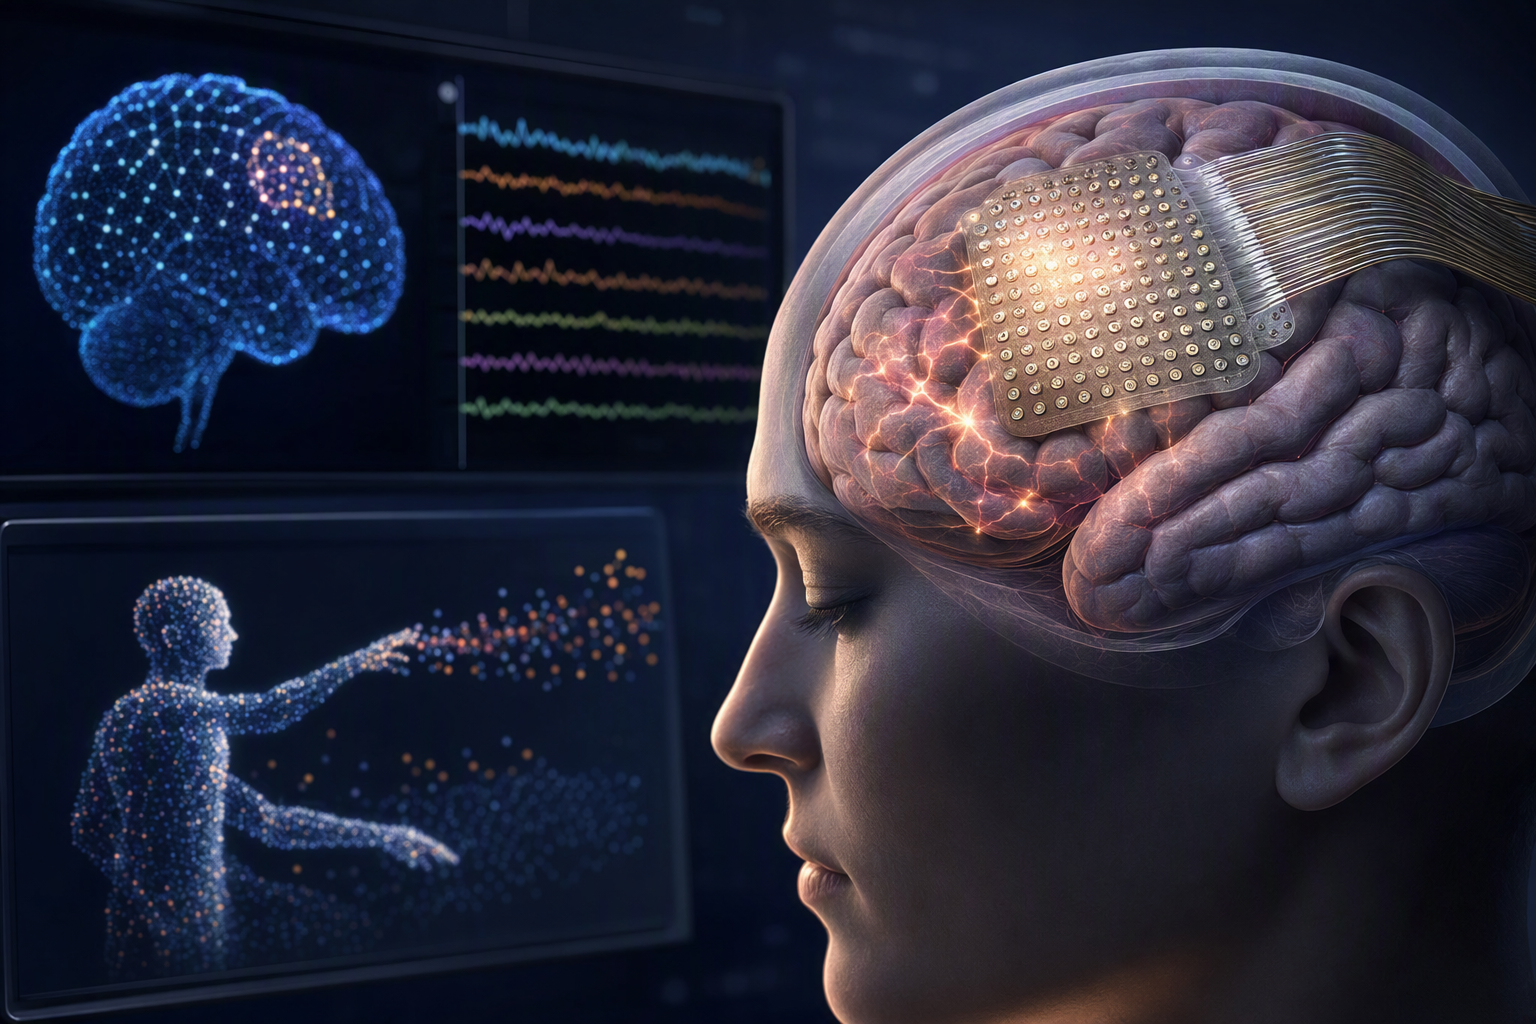
Prompt AI
openai.comCreate a landscape editorial hero image for this Studio Global article: How did University of California, San Francisco researchers use a 253 electrode sensorimotor cortex brain computer interface to simultaneous. Article summary: UCSF researchers placed a 253 electrode, high density electrocorticography array over sensorimotor cortex—the region involved in planning speech and movement—and used it to record neural activity while participants attem. Topic tags: general web, ai, privacy, regulation, video. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts
Một nhóm nghiên cứu tại Đại học California, San Francisco (UCSF) đã đặt một mảng điện não đồ vỏ não (ECoG) mật độ cao gồm 253 điện cực lên vùng vỏ não cảm giác-vận động — vùng liên quan đến việc lập kế hoạch cho lời nói và vận động. Khi người tham gia bị liệt nặng cố gắng nói và thực hiện cử chỉ phần thân trên, mảng này ghi nhận hoạt động thần kinh; hệ thống học máy sau đó chuyển tín hiệu thành lời nói và chuyển động đồng thời cho một avatar cá nhân hóa, trong vòng vài giây. 2
3
Hệ thống giải mã lời nói và cử chỉ như thế nào?
Dù không thể nói hoặc cử động theo cách thông thường, người tham gia vẫn tạo ra các mẫu tín hiệu ở vỏ não liên quan đến ý định điều khiển cơ quan phát âm và phần thân trên. Thiết bị không “đọc suy nghĩ” theo nghĩa chung chung; nó nhận các tín hiệu thần kinh gắn với ý định thực hiện những hành động đã được huấn luyện. 2
3
Điểm quan trọng là nhóm nghiên cứu không dùng một bộ giải mã duy nhất cho mọi loại đầu ra. Họ huấn luyện các bộ giải mã chuyên biệt:
- Một bộ giải mã liên hệ hoạt động não với lời nói người dùng định phát ra.
- Bộ còn lại liên hệ tín hiệu với lệnh hoặc động học cử chỉ để avatar thực hiện chuyển động phần thân trên.
2
3
Nhờ vậy, avatar có thể vừa tạo lời nói vừa biểu đạt bằng hành động — chẳng hạn vẫy tay khi chào hoặc gật đầu để thể hiện đồng ý — thay vì chỉ hiển thị chữ hay phát giọng nói một cách tách rời. 3
Vì sao cần huấn luyện trên giao tiếp kết hợp?
Một phát hiện về thần kinh học của nghiên cứu là hoạt động não khi người dùng đồng thời cố gắng nói và ra hiệu không chỉ là tổng đơn giản của hoạt động ghi nhận khi chỉ nói cộng với khi chỉ ra hiệu. Điều đó ủng hộ việc huấn luyện hệ thống bằng các nhiệm vụ giao tiếp tự nhiên, kết hợp cả hai kênh, để giọng nói và chuyển động của avatar được phối hợp với nhau. 2
3
Các trích đoạn nguồn hiện có xác nhận kết quả giải mã đa phương thức đồng thời, nhưng chưa cung cấp số liệu đủ chi tiết để định lượng mức độ khác biệt này hoặc đánh giá đầy đủ hiệu năng từng bộ giải mã. 2
3
Ý nghĩa đối với giao tiếp của người bị liệt
Các hệ thống giao tiếp dựa trên theo dõi mắt và chọn ký tự/biểu tượng có thể chậm, vì người dùng phải chọn tuần tự. Chúng cũng chủ yếu truyền tải từ ngữ, trong khi tư thế, cử động tay và sự nhấn mạnh thường góp phần quan trọng vào ý nghĩa của một cuộc trò chuyện. 2
Cách tiếp cận của UCSF hướng đến việc khôi phục song song kênh lời nói và phi ngôn ngữ. Tuy nhiên, đây là một minh chứng nghiên cứu, chưa phải thiết bị giao tiếp được cung cấp rộng rãi trong lâm sàng. 2
3
Người tham gia và giới hạn hiện tại
Nghiên cứu có ba người bị liệt cả cơ quan phát âm lẫn các chi. Nguồn được cung cấp không nêu chẩn đoán hay nguyên nhân liệt của từng người, cũng không trình bày đầy đủ danh sách nhiệm vụ thí nghiệm; chỉ xác nhận rằng họ cố gắng nói và thực hiện cử chỉ phần thân trên trong khi hệ thống giải mã cả hai. 2
3
Thiết bị hiện vẫn cần kết nối vật lý từ lưới điện cực tới phần cứng ghi nhận và tính toán bên ngoài, nên hạn chế việc sử dụng độc lập hằng ngày. Hướng phát triển được nêu ra là hệ thống không dây cấy ghép hoàn toàn, nhằm loại bỏ dây xuyên qua da. Các nguồn hiện có chưa cho phép xác định mốc thời gian, nhà sản xuất hay tình trạng cấp phép quản lý.
Mở rộng từ công trình UCSF năm 2023
Công trình mới phát triển từ hệ thống phục hồi lời nói của nhóm Edward Chang công bố năm 2023. Nghiên cứu trước đó dùng mảng ECoG mật độ cao 253 kênh ở một người bị liệt nặng và mất khả năng nói rõ, giải mã các câu người đó định nói và điều khiển avatar. 1
Khác biệt của nghiên cứu mới là mở rộng cùng hướng tiếp cận ghi nhận vỏ não mật độ cao kết hợp AI: từ đầu ra lời nói và biểu cảm khuôn mặt sang giải mã đồng thời cả giao tiếp bằng lời lẫn cử chỉ phần thân trên. 1
2
Studio Global AI
Tiếp tục nghiên cứu của bạn
Trang này bao gồm câu trả lời dựa trên nguồn mà bạn có thể tiếp tục bên trong Studio Global.
Người ta cũng hỏi
Câu trả lời ngắn gọn cho "Cấy ghép não 253 điện cực giúp người liệt vừa nói vừa ra hiệu qua avatar" là gì?
Mảng ECoG mật độ cao gồm 253 điện cực được đặt trên vỏ não cảm giác vận động để ghi lại tín hiệu khi người tham gia cố gắng nói và cử động phần thân trên.
Những điểm chính cần xác nhận đầu tiên là gì?
Mảng ECoG mật độ cao gồm 253 điện cực được đặt trên vỏ não cảm giác vận động để ghi lại tín hiệu khi người tham gia cố gắng nói và cử động phần thân trên. Các bộ giải mã học máy riêng cho lời nói và cử chỉ biến tín hiệu não thành đầu ra đồng thời cho một avatar cá nhân hóa chỉ trong vài giây.[2][3]
Tôi nên làm gì tiếp theo trong thực tế?
Hoạt động thần kinh khi vừa nói vừa ra hiệu không đơn thuần là phép cộng của hai hoạt động riêng lẻ; vì vậy hệ thống cần được huấn luyện bằng các nhiệm vụ giao tiếp kết hợp.[2][3]
Nguồn
pmc.ncbi.nlm.nih.govA high-performance neuroprosthesis for speech decoding and ...
magazine.ucsf.eduWinter 2022
changlab.ucsf.edu