AnswersPublished26 sources
Samsung zHBM: навіщо розміщувати HBM-пам’ять безпосередньо над AI-прискорювачем
Samsung заявляє, що zHBM здатна прискорити реакцію AI систем більш ніж у 10 разів, бо HBM розташовується прямо над AI прискорювачем, а не поруч із ним. Для інтерфейсу із zHBM компанія прогнозує приблизно 8× продуктивність HBM5, понад 10× щільність пам’яті, утричі кращу енергоефективність і більш ніж удвічі нижчий те...
ОпублікувавВідредаговано за допомогою GPT-5.6 TerraЗображення створено за допомогою GPT Image 2
Research answer
Key takeaways
- Samsung заявляє, що zHBM здатна прискорити реакцію AI систем більш ніж у 10 разів, бо HBM розташовується прямо над AI прискорювачем, а не поруч із ним.
- Для інтерфейсу із zHBM компанія прогнозує приблизно 8× продуктивність HBM5, понад 10× щільність пам’яті, утричі кращу енергоефективність і більш ніж удвічі нижчий тепловий опір.
- Інженери OpenAI та Intel на тому самому заході зазначили, що CXL радше доповнюватиме HBM як шар для додаткової місткості та рідко використовуваних даних, а не замінить її під час активного виконання AI моделей.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
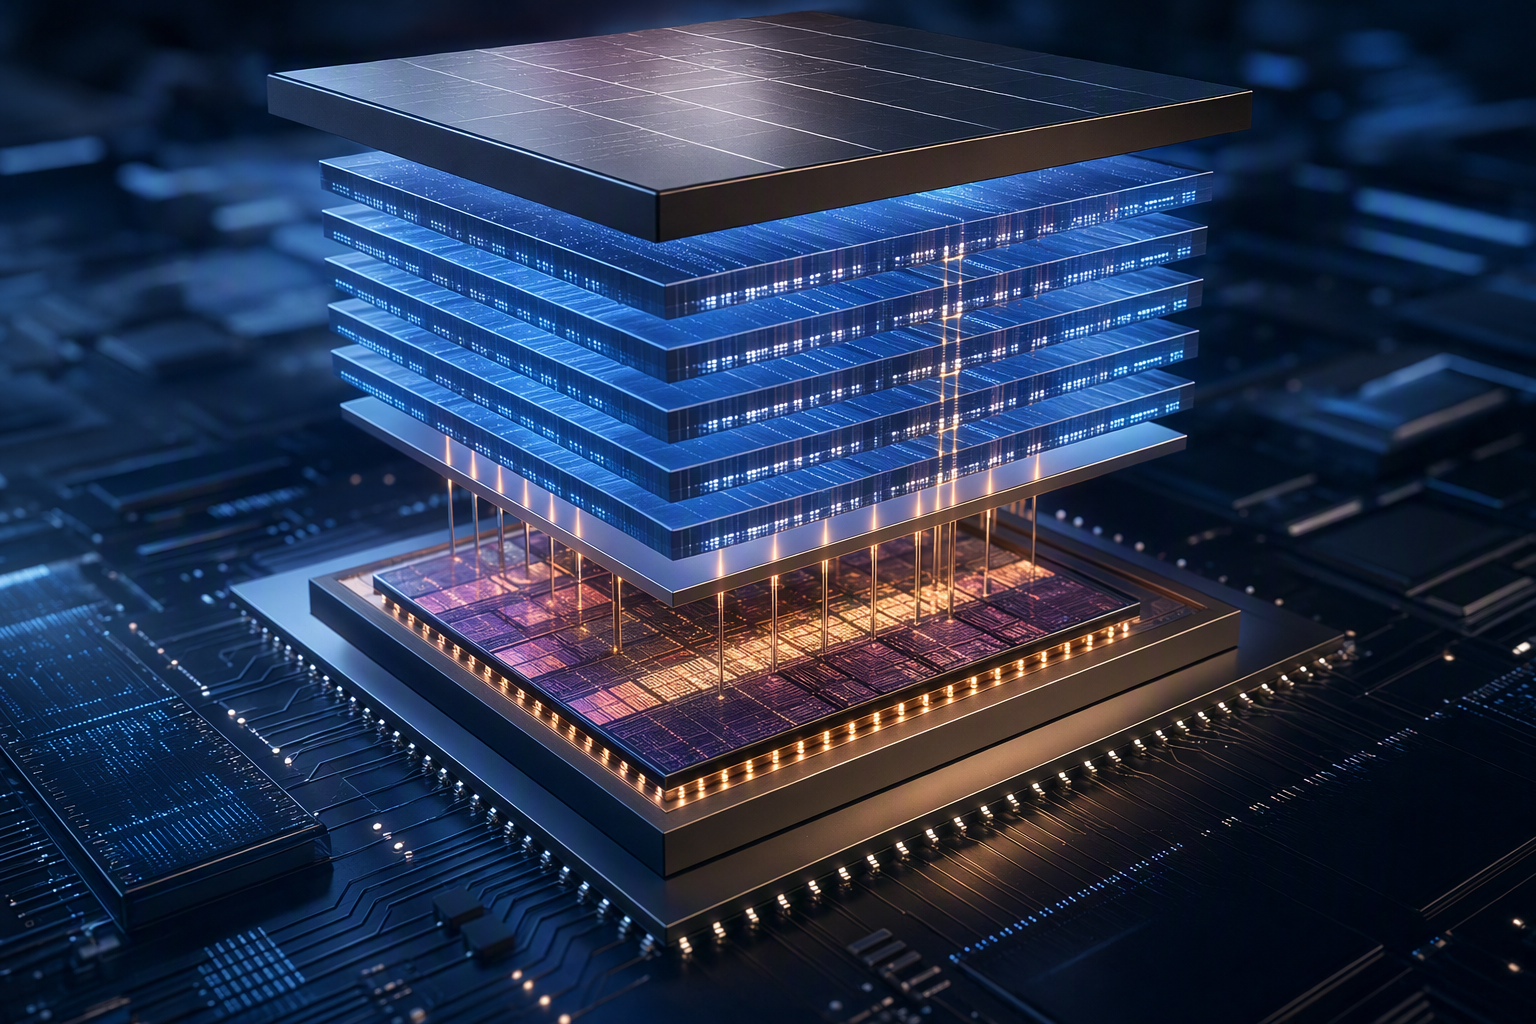
Samsung запропонувала архітектуру zHBM, яка має скоротити фізичну відстань між AI-обчисленнями та найшвидшою пам’яттю. Замість того щоб розміщувати high-bandwidth memory (HBM, пам’ять із високою пропускною здатністю) поруч із GPU або іншим прискорювачем, компанія планує встановлювати її безпосередньо над процесором у вертикальному 3D-пакуванні.
На AI Infrastructure Summit 16 вересня в Санта-Кларі Samsung подала цей підхід як один зі шляхів до швидшої реакції агентних AI-систем — моделей, здатних багаторазово звертатися до контексту, виконувати кроки міркування, користуватися інструментами й формувати відповідь. 1
9
Чим zHBM відрізняється від нинішнього пакування HBM
У типовому сучасному 2.5D-пакуванні HBM-стеки розташовані поруч із GPU чи іншим AI-прискорювачем в одній площині та з’єднані засобами передового пакування. У концепції zHBM пам’ять переноситься над AI-прискорювачем. Тобто логіка й пам’ять інтегруються вертикально, у 3D. 12
13
Ідея проста: коротший шлях для даних потенційно означає вищу пропускну здатність, менші витрати енергії на передавання даних і більшу місткість у тому самому фізичному просторі. Для такої вертикальної інтеграції Samsung розраховує на технології з’єднання пластин нового покоління, зокрема гібридне мідне з’єднання. 7
48
Водночас zHBM не є готовою заміною всіх чинних HBM-пакетів. Samsung показала її як концептуальну модель і поки не назвала строків комерційного запуску. 13
14
Які показники обіцяє Samsung
Для інтерфейсу наступного покоління із zHBM Samsung озвучила амбітні цілі:
- приблизно у 8 разів вища продуктивність, ніж у HBM5;
- більш ніж у 10 разів вища щільність пам’яті, ніж у звичайної HBM5;
- близько утричі краща енергоефективність;
- більш ніж на 50% нижчий тепловий опір.
13
48
На AI Infrastructure Summit компанія також заявила, що zHBM може підвищити швидкість реакції AI-систем більш ніж удесятеро; орієнтиром названо 1 000 токенів за секунду. 1
9
Ці цифри варто сприймати як цільові показники Samsung для майбутньої архітектури, а не як незалежно підтверджені бенчмарки серійного прискорювача. Практична реалізація вимагатиме прийнятного виробничого виходу придатних кристалів, ефективного відведення тепла та кваліфікації рішення партнерами, що випускають прискорювачі.
Чому це важливо для агентного ШІ
Агентний ШІ не просто генерує текст: він постійно читає контекст, запускає інференс, звертається до інструментів і повертає результат. Навіть потужний обчислювальний блок може простоювати, якщо дані надходять до нього недостатньо швидко.
zHBM має зменшити саме це вузьке місце — рух даних між пам’яттю та прискорювачем. Задум полягає в тому, що близьке розташування HBM допоможе системі швидше реагувати й водночас знизить енергетичну ціну передачі даних. 1
7 Але фактичний приріст швидкості відповіді залежатиме не лише від компонування пам’яті, а й від усього комплексу: прискорювача, моделі, програмного забезпечення та пакування.
zNAND-O — окремий шар місткої пам’яті
Разом із zHBM Samsung представила zNAND-O — високопродуктивну NAND-архітектуру для середовищ із великими обсягами даних та периферійного ШІ. Її позиціонують як проміжний рівень між DRAM і традиційним NAND-сховищем: вона має забезпечити вищу щільність, ніж DRAM, і кращі I/O-характеристики, затримки та енергоефективність порівняно зі звичайною NAND-пам’яттю. 49
51
Ролі цих технологій різні:
- zHBM призначена для найшвидшого рівня пам’яті безпосередньо біля AI-прискорювача;
- zNAND-O має дати щільніший рівень для даних і моделей, які було б надто дорого цілком тримати в DRAM.
49
53
Samsung навела результати власного тесту з GPT-моделлю на 120 млрд параметрів: за її даними, zNAND-O досягла такого самого темпу токенів за секунду, як сервер зі звичайною DRAM, за одну шосту експлуатаційних витрат. Це результат тестування, заявлений самою Samsung, а не універсальна гарантія вартості для всіх великих моделей. 54
55
Компанія також пов’язує zNAND-O з довгостроковим завданням запуску дуже великих моделей безпосередньо на пристроях: за її оцінкою, до 2030 року актуальними можуть стати on-device AI-моделі масштабу трильйона параметрів. 53
Чому CXL не замінює HBM для активної роботи моделі
На саміті пролунало важливе уточнення щодо ринку AI-пам’яті: більша місткість не робить усі типи пам’яті взаємозамінними.
Дослідник AI-прискорювачів OpenAI Деніел Морріс сказав, що не знайшов для CXL практичного сценарію саме для запуску AI-моделей, хоча CXL може бути корисною для даних, до яких великі моделі звертаються рідко. Керівниця архітектури AI system-on-chip в Intel Відія Тіагараджан так само назвала пулінг пам’яті через CXL доповненням до вторинного зберігання, а не заміною HBM, вказавши на розрив у пропускній здатності між CXL-пам’яттю та HBM. 18
22
Це не означає, що CXL не матиме застосування. Радше AI-інфраструктура формуватиметься як багаторівнева система: HBM поруч із прискорювачем — для активних обчислень, чутливих до пропускної здатності; CXL та інші рівні пам’яті або сховища — для задач, де пріоритетом є місткість.
Що це означає для Samsung і SK hynix
У найближчій перспективі конкуренцію на ринку HBM визначатиме не лише сміливість архітектури, а й спроможність виробника налагодити випуск, пройти кваліфікацію та поставляти пам’ять під конкретні платформи прискорювачів. zHBM дає Samsung довгостроковий спосіб відрізнитися, але не скасовує потреби довести виробничий вихід, теплові характеристики, надійність і сумісність із продуктами замовників.
Скепсис щодо здатності CXL замінити локальну HBM під час активного виконання моделі підсилює стратегічну роль HBM. Тож головне конкурентне питання для Samsung, SK hynix та інших постачальників — не лише хто представить найагресивнішу 3D-концепцію, а хто першим перетворить нові технології пам’яті й передового пакування на кваліфікований серійний продукт. 18
33
36
Висновок
Головний меседж Samsung полягає в тому, що швидкодію ШІ дедалі частіше обмежують не тільки обчислення, а й передавання даних, місткість пам’яті, енергоспоживання та тепло. zHBM пропонує відповідь у вигляді 3D-стекингу пам’яті прямо над прискорювачем, а zNAND-O — більш місткий суміжний рівень для великих AI-навантажень.
Заявлений потенціал значний, однак це все ще цілі концептуальної технології. Для покупців та проєктувальників AI-інфраструктури ключовий висновок такий: майбутні системи, ймовірно, дедалі більше покладатимуться на спеціалізовану багаторівневу пам’ять із вертикальною інтеграцією, а HBM залишатиметься центральним компонентом найпродуктивнішого обчислювального шляху. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: навіщо розміщувати HBM-пам’ять безпосередньо над AI-прискорювачем"?
Samsung заявляє, що zHBM здатна прискорити реакцію AI систем більш ніж у 10 разів, бо HBM розташовується прямо над AI прискорювачем, а не поруч із ним.
What are the key points to validate first?
Samsung заявляє, що zHBM здатна прискорити реакцію AI систем більш ніж у 10 разів, бо HBM розташовується прямо над AI прискорювачем, а не поруч із ним. Для інтерфейсу із zHBM компанія прогнозує приблизно 8× продуктивність HBM5, понад 10× щільність пам’яті, утричі кращу енергоефективність і більш ніж удвічі нижчий тепловий опір.
What should I do next in practice?
Інженери OpenAI та Intel на тому самому заході зазначили, що CXL радше доповнюватиме HBM як шар для додаткової місткості та рідко використовуваних даних, а не замінить її під час активного виконання AI моделей.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push