Yapay zekâ görsellerinin kaynağı neden izlenemiyor? MIT çalışması “atıf çürümesi”ni ortaya koydu
Araştırma, difüzyon tabanlı görsel üreticileri daha fazla görselle eğitildikçe tek bir eğitim görselinin belirli bir çıktı üzerindeki etkisinin saptanamaz hâle gelebildiğini gösterdi. “Atıf çürümesi” adı verilen bu durum, üretilen bir görseli belirli bir sanatçıya, fotoğrafa veya kaynak görsele bağlamayı zorlaştırıyor.
Araştırma, difüzyon tabanlı görsel üreticileri daha fazla görselle eğitildikçe tek bir eğitim görselinin belirli bir çıktı üzerindeki etkisinin saptanamaz hâle gelebildiğini gösterdi.
“Atıf çürümesi” adı verilen bu durum, üretilen bir görseli belirli bir sanatçıya, fotoğrafa veya kaynak görsele bağlamayı zorlaştırıyor.
Araştırmacılar, bir kaynağın etkisini ölçmek için farklı veri dilimleriyle eğitilmiş küçük difüzyon bileşenlerinden oluşan bir “difüzyon ansambli” kurdu.
Tek bir görselin, bir sanatçının tüm çalışmalarının veya belirli bir kişinin fotoğraflarının eğitim verisinden çıkarılması test edildi; veri seti büyüdükçe çıktıdaki fark çoğu zaman ölçülemedi.
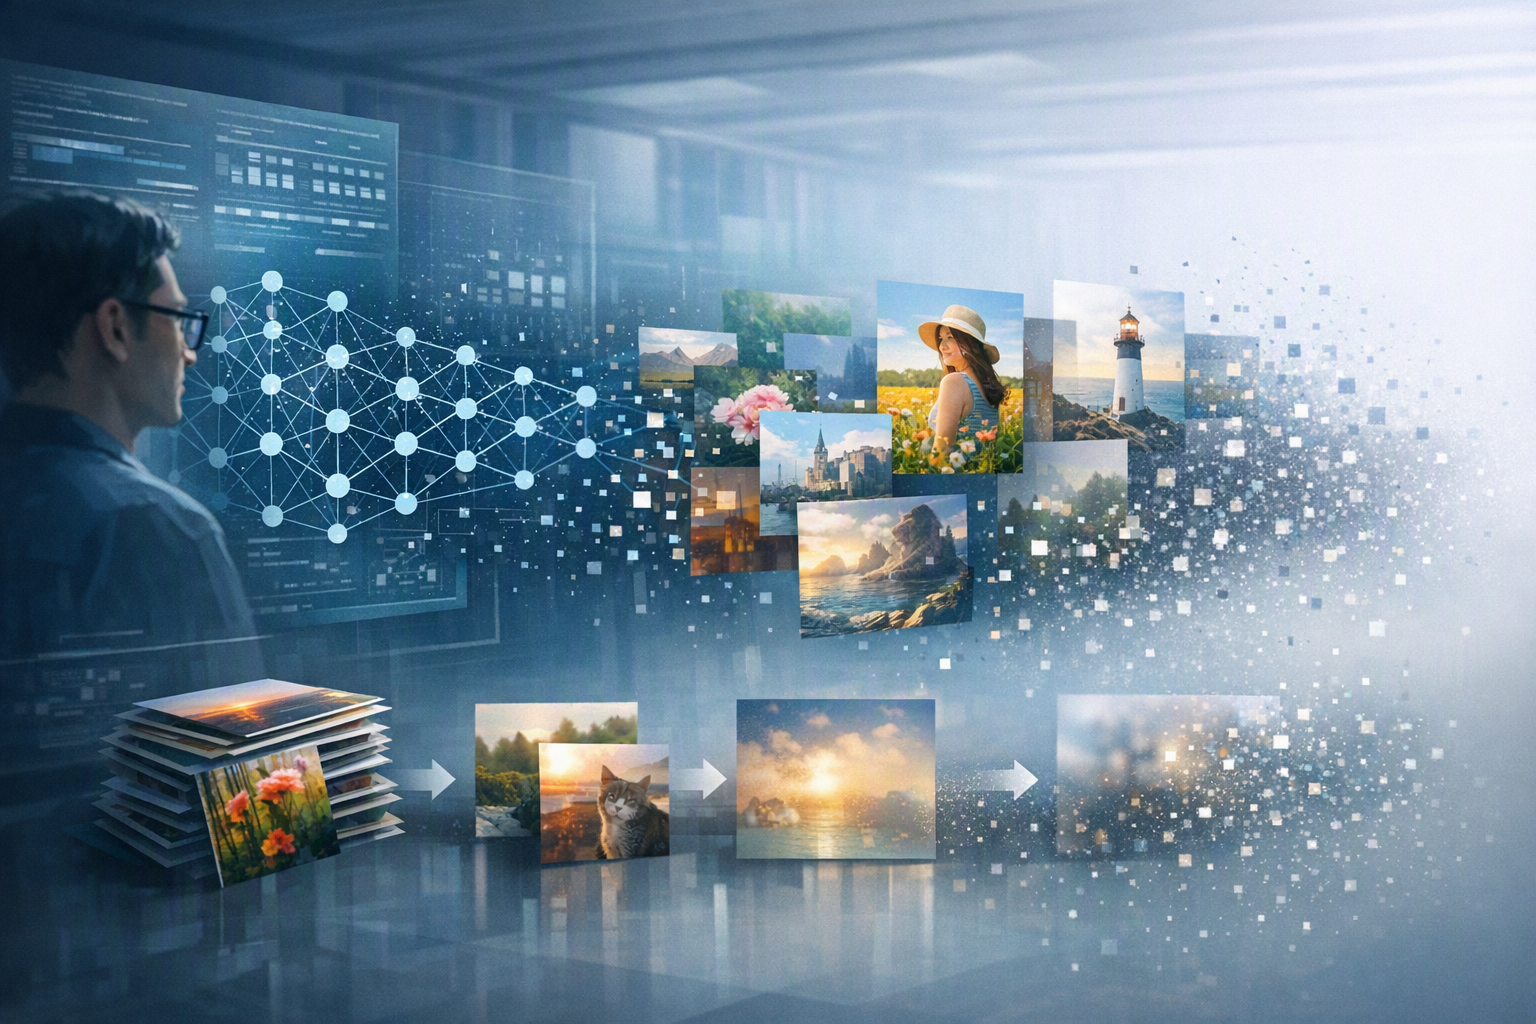
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications on August 20, 2026, reveal about “attribution decAI-generated editorial hero image for What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications on August 20, 2026, reveal about “attribution dec.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications on August 20, 2026, reveal about “attribution dec. Article summary: The study found “attribution decay”: as a diffusion image generator is trained on more images, the causal influence of any one training image on a particular output can become too small to detect—and may disappear under . Topic tags: general web, openai, llm, ai, workflow. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with
openai.com
MIT Bilgisayar Bilimi ve Yapay Zekâ Laboratuvarı’ndan (CSAIL) Zheng Dai ve David Gifford’un çalışması, difüzyon tabanlı yapay zekâ görsel üreticilerinde “atıf çürümesi” olarak adlandırılan bir olguyu ortaya koydu. Buna göre model daha büyük veri setleriyle eğitildikçe, tek bir eğitim görselinin belirli bir çıktı üzerindeki nedensel etkisi o kadar küçülebiliyor ki kesin bir çıkarma testiyle bile saptanamayabiliyor.
Bu sonuç, üretilen bir görseli belirli bir sanatçıya, fotoğrafa veya kaynak görsele bağlamayı zorlaştırıyor. Ancak çalışma, telif hakkıyla korunan materyallerin yapay zekâ eğitimi için kullanılmasının hukuka uygun olduğunu ya da modellerin hiçbir zaman kopyalama yapmadığını göstermiyor.
Dai ve Gifford neyi test etti?
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "Yapay zekâ görsellerinin kaynağı neden izlenemiyor? MIT çalışması “atıf çürümesi”ni ortaya koydu"?
Araştırma, difüzyon tabanlı görsel üreticileri daha fazla görselle eğitildikçe tek bir eğitim görselinin belirli bir çıktı üzerindeki etkisinin saptanamaz hâle gelebildiğini gösterdi.
What are the key points to validate first?
Araştırma, difüzyon tabanlı görsel üreticileri daha fazla görselle eğitildikçe tek bir eğitim görselinin belirli bir çıktı üzerindeki etkisinin saptanamaz hâle gelebildiğini gösterdi. “Atıf çürümesi” adı verilen bu durum, üretilen bir görseli belirli bir sanatçıya, fotoğrafa veya kaynak görsele bağlamayı zorlaştırıyor.
What should I do next in practice?
Araştırmacılar, bir kaynağın etkisini ölçmek için farklı veri dilimleriyle eğitilmiş küçük difüzyon bileşenlerinden oluşan bir “difüzyon ansambli” kurdu.
Araştırmacılar, tek tek görsellerin model çıktıları üzerindeki etkisini yalnızca matematiksel olarak tahmin etmek yerine “difüzyon ansambli” adı verilen bir mimari oluşturdu. Bu yaklaşım, farklı veri dilimleriyle eğitilmiş çok sayıda daha küçük difüzyon bileşeninden oluşuyor.
Belirli bir kaynak görselin etkisini test etmek için, o görseli görmüş olan tüm bileşenler devre dışı bırakıldı. Böylece araştırmacılar modeli baştan eğitmeden ve yaklaşık bir hesaplamaya başvurmadan, söz konusu kaynak hiç eğitim verisinde yer almamış olsaydı ortaya çıkacak karşı olgusal modeli elde edebildi.
Ekip ayrıca aynı verilerle eğitilmiş 24 geleneksel difüzyon modeliyle karşılaştırma yaptı. Modellerin standart ölçümlerde genel olarak benzer çıktı kalitesine sahip olduğu belirtildi.
Testler, 256 görselden 160 binden fazla görsele uzanan veri setlerinde gerçekleştirildi. Araştırmacılar şu kaynakları sırayla çıkardı:
tek bir görseli,
tek bir sanatçının tüm çalışmalarını,
belirli bir kişiye ait tüm fotoğrafları.
Veri seti büyüdükçe bu kaynaklardan birinin çıkarılması, oluşturulan sonuçta çoğu zaman kayda değer bir değişiklik yaratmadı. Çalışmanın “atıf çürümesi” dediği olgu, tek tek kaynakların ölçülebilir etkisinin veri ölçeği büyüdükçe azalmasını ifade ediyor.
Telif davaları açısından ne anlama geliyor?
Bulgular, belirli bir yapay zekâ sisteminin ürettiği bir çıktının davacının tek bir görselinden veya sanatçıya ait eksiksiz bir çalışmadan kaynaklandığını öne süren iddiaları karmaşıklaştırabilir. Çünkü ilgili materyal eğitim verisinden tamamen çıkarıldığında çıktı değişmiyorsa, bu karşılaştırma o çıktıyı söz konusu kaynağa bağlamak için sınırlı kanıt sağlar.
Bu durum, Midjourney, OpenAI veya Microsoft’la ilişkilendirilen sistemlerin ürettiği belirli görsellerin hangi kaynaklardan etkilendiğine dair soruşturmalarda önem taşıyabilir. Ancak çalışma bir hukuk kararı değil; belirli bir çıktının nedensel olarak tek bir eğitim kaynağına bağlanmasının büyük ölçeklerde ne kadar zorlaştığına ilişkin deneysel bir bulgu sunuyor.
Araştırma şu ayrı hukuki soruları yanıtlamıyor:
Şirketler eğitim verilerini toplarken eserleri kopyaladı mı?
Eğitim süreci telif hakkı ihlali oluşturuyor mu veya adil kullanım kapsamında mı?
Üretilen sonuç, korunan bir eserle esaslı ölçüde benzer mi?
Model, bir sanatçının üslubunu taklit etmesi için bilerek yönlendirildi mi?
Bu nedenle mahkemelerin yalnızca “tek görselden tek çıktıya” uzanan nedensel bağlantıya değil; veri edinme kayıtlarına, doğrudan benzerlik kanıtlarına, hedefli istemler karşısındaki model davranışına, içerik kökeni bilgilerine ve bilirkişi değerlendirmelerine de bakması gerekebilir. Bu, çalışmanın büyük veri setlerinde tekil çıktıların kaynağını belirlemenin zorlaştığını göstermesinden çıkarılan bir değerlendirmedir.
Bu bulgu neden yapay zekâ için bir “serbest geçiş” değil?
“Atıf çürümesi”, difüzyon modellerinin hiçbir şeyi ezberleyemediği anlamına gelmiyor. Modeller bazı koşullarda eğitim örneklerini ezberleyebilir veya yeniden üretebilir. Bulguların söylediği, veri seti ölçeklendikçe tek bir kaynağın etkisinin çoğu zaman ölçülemez hâle gelmesidir; kopyalamanın hiç gerçekleşmediği değil.
Ayrıca çalışma difüzyon tabanlı görsel üreticilere odaklanıyor. Sonuçlar, dil modelleri veya diğer üretken yapay zekâ mimarileri için otomatik olarak genellenemez.
Dolayısıyla araştırma, yapay zekâ telif tartışmalarını sona erdirmekten çok kanıt standardı hakkında yeni bir soru ortaya koyuyor: Bir çıktının tek bir görsele ne ölçüde borçlu olduğunu göstermek mümkün değilse, sorumluluk değerlendirmesi daha geniş bir veri ve model davranışı incelemesine dayanmak zorunda kalabilir.
A diffusion model conditioned on compound bioactivity profiles for generating high-content images
news.mit.eduWhen AI art has no author: Study finds generated images ...
nature.comA generative diffusion model for amorphous materials