คำตอบเผยแพร่แล้ว24 แหล่งที่มา
เบื้องหลัง “การสแกนแบบทำลาย” ของ AI: หนังสือหลายล้านเล่มถูกซื้อ หั่นสัน และส่งเข้าเครื่องทำลาย
Anthropic เริ่ม Project Panama ในช่วงต้นปี 2024 ใช้เงินหลายสิบล้านดอลลาร์ซื้อหนังสือจริงหลายล้านเล่ม ตัดสัน สแกน และทำลายต้นฉบับเพื่อสร้างคลังข้อมูลฝึก Claude โดยมีเป้าหมายสแกนได้สูงสุด 2 ล้านเล่มภายใน 6 เดือน [2][3][... ร้านหนังสือเก่าแก่ในยุโรปพบคำสั่งซื้อหนังสือวิชาการเฉพาะทางจำนวนมากผ่านคนกลางนิรนาม เช่น กรณี Pi...
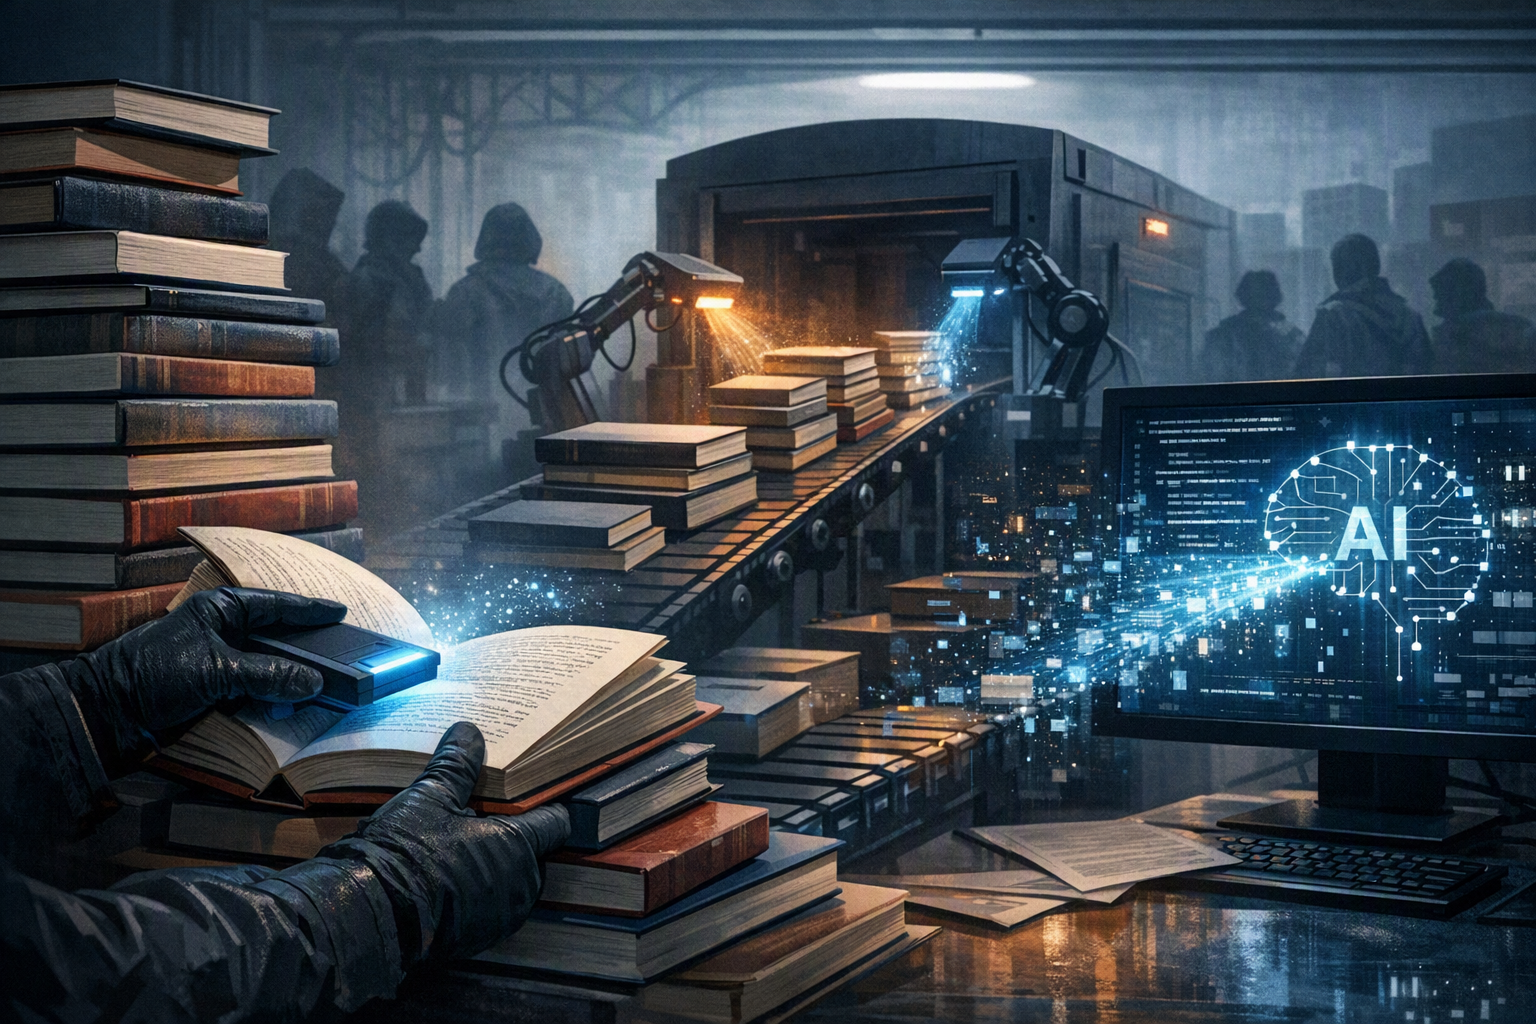
เผยแพร่โดยแก้ไขด้วย DeepSeek-V4-Flashรูปภาพสร้างด้วย GPT Image 1.5
คำตอบการวิจัย
ประเด็นสำคัญ
- Anthropic เริ่ม Project Panama ในช่วงต้นปี 2024 ใช้เงินหลายสิบล้านดอลลาร์ซื้อหนังสือจริงหลายล้านเล่ม ตัดสัน สแกน และทำลายต้นฉบับเพื่อสร้างคลังข้อมูลฝึก Claude โดยมีเป้าหมายสแกนได้สูงสุด 2 ล้านเล่มภายใน 6 เดือน [2][3][...
- ร้านหนังสือเก่าแก่ในยุโรปพบคำสั่งซื้อหนังสือวิชาการเฉพาะทางจำนวนมากผ่านคนกลางนิรนาม เช่น กรณี Pieter de Vries ที่ได้รับรายชื่อ ISBN มากกว่า 3,000 รายการ พร้อมคำขอประเมินราคาและค่าขนส่งไปจีน [5][6][7][8]
- ศาลสหรัฐฯ ตัดสินว่าการนำหนังสือที่ได้มาอย่างถูกกฎหมายไปฝึก AI เป็น fair use แต่การใช้สำเนาที่ได้จากแหล่งละเมิดลิขสิทธิ์ไม่เข้าข่ายดังกล่าว ก่อนมีการอนุมัติข้อตกลงยุติคดีมูลค่า 1.5 พันล้านดอลลาร์ในเดือนกรกฎาคม 2026 [1]...
AI พรอมต์
openai.comCreate a landscape editorial hero image for this Studio Global article: What are the key details about AI companies' practice of "destructive scanning"—secretly purchasing millions of physical books through anony. Article summary: I'll research each of these claims. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, icons, and tiny thumbnail layouts. Make it useful as an illustrative visual, not as factual evidence.
การแข่งขันพัฒนา AI กำลังเปิดให้เห็นวิธีหา “ข้อมูลคุณภาพสูง” ที่สร้างข้อถกเถียงครั้งใหม่ บริษัทเทคโนโลยีบางแห่งไม่ได้พึ่งพาเพียงการเก็บข้อมูลจากอินเทอร์เน็ต แต่หันไปซื้อหนังสือกระดาษจำนวนมหาศาล จากนั้นตัดสันหนังสือด้วยเครื่องจักรไฮดรอลิก ป้อนกระดาษเข้าเครื่องสแกนความเร็วสูง และนำเศษที่เหลือไปทำลายหรือรีไซเคิล
กระบวนการนี้เรียกว่า destructive scanning หรือ “การสแกนแบบทำลาย” เพราะเมื่อสแกนเสร็จ หนังสือเล่มจริงอาจไม่เหลืออยู่เลย ประเด็นดังกล่าวถูกเปิดเผยจากเอกสารคดีที่ถูกเปิดผนึกและรายงานเชิงสืบสวนในปี 2026 โดยมีปฏิบัติการลับของ Anthropic ที่ชื่อ Project Panama เป็นกรณีสำคัญ
Destructive scanning คืออะไร
บริษัท AI ซื้อหนังสือมือสอง หนังสือหายาก และหนังสือที่เลิกพิมพ์แล้วเป็นล็อตใหญ่ โดยบางครั้งใช้บริการคนกลางเพื่อไม่ให้เห็นตัวผู้ซื้อปลายทางอย่างชัดเจน หนังสือจะถูกส่งเข้าสู่กระบวนการเชิงอุตสาหกรรม ดังนี้
- ตัดสันหรือส่วนเข้าเล่มออกด้วยเครื่องตัดไฮดรอลิก
- แยกกระดาษออกเป็นแผ่น ๆ
- ป้อนทุกหน้าเข้าเครื่องสแกนความเร็วสูง
- ทำลาย เยื่อกระดาษ หรือรีไซเคิลต้นฉบับหลังการสแกน
Studio Global AI
ทำการวิจัยต่อ
หน้านี้รวมคำตอบที่ได้รับการสนับสนุนจากแหล่งที่มาซึ่งคุณสามารถดำเนินการต่อภายใน Studio Global
คนยังถาม
คำตอบสั้น ๆ สำหรับ "เบื้องหลัง “การสแกนแบบทำลาย” ของ AI: หนังสือหลายล้านเล่มถูกซื้อ หั่นสัน และส่งเข้าเครื่องทำลาย" คืออะไร
Anthropic เริ่ม Project Panama ในช่วงต้นปี 2024 ใช้เงินหลายสิบล้านดอลลาร์ซื้อหนังสือจริงหลายล้านเล่ม ตัดสัน สแกน และทำลายต้นฉบับเพื่อสร้างคลังข้อมูลฝึก Claude โดยมีเป้าหมายสแกนได้สูงสุด 2 ล้านเล่มภายใน 6 เดือน [2][3][...
ประเด็นสำคัญที่ต้องตรวจสอบก่อนคืออะไร?
Anthropic เริ่ม Project Panama ในช่วงต้นปี 2024 ใช้เงินหลายสิบล้านดอลลาร์ซื้อหนังสือจริงหลายล้านเล่ม ตัดสัน สแกน และทำลายต้นฉบับเพื่อสร้างคลังข้อมูลฝึก Claude โดยมีเป้าหมายสแกนได้สูงสุด 2 ล้านเล่มภายใน 6 เดือน [2][3][... ร้านหนังสือเก่าแก่ในยุโรปพบคำสั่งซื้อหนังสือวิชาการเฉพาะทางจำนวนมากผ่านคนกลางนิรนาม เช่น กรณี Pieter de Vries ที่ได้รับรายชื่อ ISBN มากกว่า 3,000 รายการ พร้อมคำขอประเมินราคาและค่าขนส่งไปจีน [5][6][7][8]
ฉันควรทำอย่างไรต่อไปในทางปฏิบัติ?
ศาลสหรัฐฯ ตัดสินว่าการนำหนังสือที่ได้มาอย่างถูกกฎหมายไปฝึก AI เป็น fair use แต่การใช้สำเนาที่ได้จากแหล่งละเมิดลิขสิทธิ์ไม่เข้าข่ายดังกล่าว ก่อนมีการอนุมัติข้อตกลงยุติคดีมูลค่า 1.5 พันล้านดอลลาร์ในเดือนกรกฎาคม 2026 [1]...
แหล่งที่มา
dallasexpress.comAI Firms Scan Then Destroy Rare Book Editions
emeraldbook.orgWhy AI Companies Are Destroying Original Literature to Train ...
news.com.auAI labs buy, scan, shred millions of rare books
christianactivities.comThe Hidden Costs of Destroying Physical Books for AI Training Data | Christian Activities
