คำตอบการวิจัย
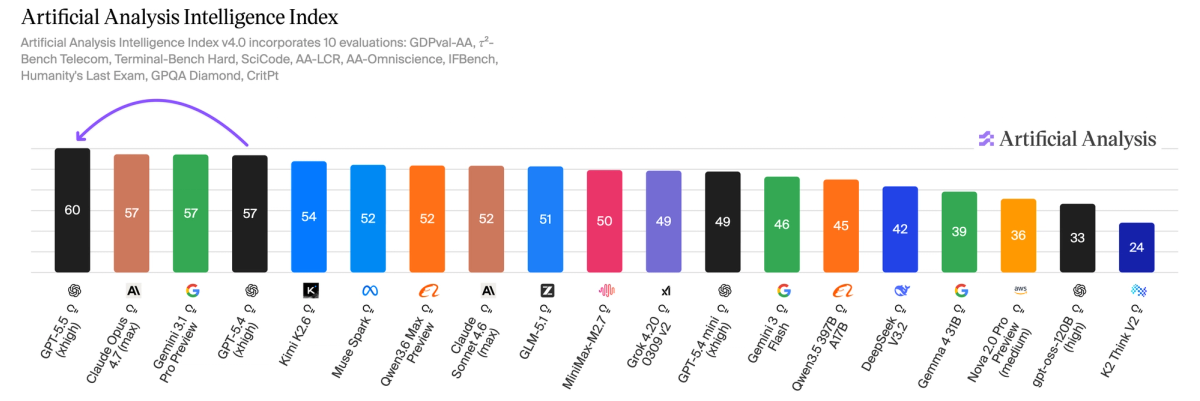
ประเด็นสำคัญ ตัวเลขที่อ้างได้ตรงที่สุดสำหรับคำตอบสั้น ๆ คือ GPT 5.5 ได้ 84.9% บน GDPval ซึ่ง OpenAI อธิบายว่าเป็นการทดสอบงานเชิงความรู้ที่กำหนดโจทย์ชัดเจน ครอบคลุม 44 อาชีพ[1] ค่า 73.1% บน Expert SWE และ 80.5% บน BixBench วัดคนละโจทย์ จึงไม่ควรนำมาเรียงเทียบเหมือนคะแนนสอบชุดเดียวกัน[8][10] Artificial Analysis จัดให้ GPT 5.5 นำ Intelligence Index อยู่ 3 คะแนน แต่รายละเอียดคือชนะบางหัวข้อ ไม่ใช่ชนะทุกการทดสอบ[3] GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten KI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks. AI พรอมต์ Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com เวลาถามว่า benchmark ของ GPT-5.5 คืออะไร คำตอบที่ดีไม่ควรหยิบเปอร์เซ็นต์ที่สูงที่สุดมาโชว์ทันที แต่ต้องดูด้วยว่าชุดทดสอบนั้นวัดอะไร
ถ้าต้องตอบแบบสั้นที่สุด ตัวเลขที่ควรเริ่มคือ 84.9% บน GDPval เพราะ OpenAI ระบุค่านี้เอง และอธิบายว่า GDPval เป็น benchmark สำหรับวัดความสามารถของเอเจนต์ AI ในการสร้างงานเชิงความรู้ที่กำหนดโจทย์ไว้ชัดเจน ครอบคลุม 44 อาชีพ
แต่ต้องอ่านให้ถูก: 84.9% ไม่ใช่คะแนนความฉลาดรวม ไม่ใช่เกรดคุณภาพทุกด้านของโมเดล และไม่ควรเอาไปเทียบตรง ๆ กับคะแนน coding หรือชีวสารสนเทศโดยไม่ดูบริบท
คำตอบสั้น: 84.9% บน GDPval
ถ้าต้องอ้าง benchmark ของ GPT-5.5 เพียงตัวเดียว สูตรที่แม่นที่สุดคือ:
GPT-5.5 ทำได้ 84.9% บน GDPval ตามข้อมูลจาก OpenAI โดย GDPval ทดสอบความสามารถในการสร้างงานเชิงความรู้ที่ระบุโจทย์ชัดเจนใน 44 อาชีพ
คนยังถาม คำตอบสั้น ๆ สำหรับ "Benchmark ของ GPT-5.5: 84.9% บน GDPval หมายความว่าอย่างไร" คืออะไร ตัวเลขที่อ้างได้ตรงที่สุดสำหรับคำตอบสั้น ๆ คือ GPT 5.5 ได้ 84.9% บน GDPval ซึ่ง OpenAI อธิบายว่าเป็นการทดสอบงานเชิงความรู้ที่กำหนดโจทย์ชัดเจน ครอบคลุม 44 อาชีพ[1]
ประเด็นสำคัญที่ต้องตรวจสอบก่อนคืออะไร? ตัวเลขที่อ้างได้ตรงที่สุดสำหรับคำตอบสั้น ๆ คือ GPT 5.5 ได้ 84.9% บน GDPval ซึ่ง OpenAI อธิบายว่าเป็นการทดสอบงานเชิงความรู้ที่กำหนดโจทย์ชัดเจน ครอบคลุม 44 อาชีพ[1] ค่า 73.1% บน Expert SWE และ 80.5% บน BixBench วัดคนละโจทย์ จึงไม่ควรนำมาเรียงเทียบเหมือนคะแนนสอบชุดเดียวกัน[8][10]
ฉันควรทำอย่างไรต่อไปในทางปฏิบัติ? Artificial Analysis จัดให้ GPT 5.5 นำ Intelligence Index อยู่ 3 คะแนน แต่รายละเอียดคือชนะบางหัวข้อ ไม่ใช่ชนะทุกการทดสอบ[3]
ตัวเลขนี้มีประโยชน์มากเมื่อต้องมอง GPT-5.5 ในฐานะโมเดลสำหรับงานทำงานจริง เช่น การอ่านโจทย์ การวางโครงงาน และการผลิตผลลัพธ์ตามเงื่อนไขที่กำหนดไว้ อย่างไรก็ตาม GDPval ไม่ได้แทนทุกมิติของการใช้ AI จึงไม่ควรถูกใช้เป็นคำตอบครอบจักรวาลสำหรับทุกกรณี
ตัวเลขสำคัญที่มีการอ้างถึง Benchmark หรือดัชนี ค่าที่รายงาน วัดเรื่องอะไร ควรอ่านอย่างไร GDPval 84.9% งานเชิงความรู้ที่กำหนดโจทย์ชัดเจน ครอบคลุม 44 อาชีพ เป็นค่าที่ OpenAI ระบุโดยตรง จึงเหมาะเป็น benchmark สั้น ๆ สำหรับภาพรวมงานความรู้ Expert-SWE 73.1% งานเขียนโค้ด โดยรายงานว่าเป็นการประเมินภายในสำหรับงานที่คาดว่าใช้เวลาทำ 20 ชั่วโมง เหมาะกว่า GDPval หากโจทย์คือ software development แต่ไม่ใช่ตัวเลขที่เทียบกับ GDPval ได้ตรง ๆ BixBench 80.5% benchmark ชีวสารสนเทศจากงานจริง เกี่ยวข้องกับ bioinformatics โดยเฉพาะ แต่ในชุดแหล่งข้อมูลนี้หลักฐานควรอ่านระวังกว่าค่า GDPval ที่มาจาก OpenAI โดยตรง Artificial Analysis Intelligence Index อันดับ 1 นำ 3 คะแนน ดัชนีเปรียบเทียบโมเดลจากผู้ประเมินภายนอก มีประโยชน์สำหรับดูภาพรวมการแข่งขันของโมเดล แต่ไม่ใช่ benchmark ทางการตัวเดียวจาก OpenAI
ทำไม 84.9%, 73.1% และ 80.5% ไม่ควรถูกเทียบกันตรง ๆ ตัวเลขเปอร์เซ็นต์หลายตัวอาจทำให้ดูเหมือนเป็นคะแนนจากข้อสอบชุดเดียวกัน แต่จริง ๆ แล้วแต่ละค่าอยู่คนละสนามทดสอบ
84.9% บน GDPval วัดงานเชิงความรู้ที่ระบุโจทย์ชัดเจนในหลายอาชีพ
73.1% บน Expert-SWE วัดงาน coding ในการประเมินภายในที่รายงานว่าออกแบบสำหรับงานซึ่งคาดว่าใช้เวลาทำ 20 ชั่วโมง
80.5% บน BixBench วัดงานด้าน bioinformatics หรือชีวสารสนเทศ
แล้ว Artificial Analysis บอกอะไร Artificial Analysis รายงานว่า GPT-5.5 ขึ้นนำ Artificial Analysis Intelligence Index อยู่ 3 คะแนน รายงานเดียวกันยังระบุว่า OpenAI นำใน headline evaluations 5 รายการ และตามหลัง Gemini 3.1 Pro Preview ในอีก 3 รายการ
จุดสำคัญคือ อันดับ 1 ในดัชนีภายนอกไม่ได้แปลว่าโมเดลชนะทุกการทดสอบย่อยเสมอไป แต่หมายความว่าเมื่อรวมตามวิธีคำนวณของดัชนีนั้น GPT-5.5 อยู่ในตำแหน่งนำโดยรวม
ระวังตัวเลขพาดหัวที่หลุดจากบริบท
ควรอ้างตัวเลขไหนในสถานการณ์ไหน ถ้าจะอ้างแบบกระชับและไม่ทำให้เข้าใจผิด ควรเลือกตามบริบทดังนี้
งานเชิงความรู้ทั่วไป: 84.9% บน GDPval
งาน software development: 73.1% บน Expert-SWE
งาน bioinformatics: 80.5% บน BixBench พร้อมระบุว่าหลักฐานในชุดแหล่งข้อมูลนี้จำกัดกว่า
การเทียบโมเดลในภาพกว้าง: อันดับ 1 ใน Artificial Analysis Intelligence Index โดยนำ 3 คะแนน
สรุป ถ้าต้องเลือก benchmark สั้น ๆ สำหรับ GPT-5.5 คำตอบที่สะอาดที่สุดคือ 84.9% บน GDPval จุดแข็งของตัวเลขนี้คือมาจาก OpenAI โดยตรง และมีขอบเขตชัดเจนว่าเป็นการวัดงานเชิงความรู้ที่กำหนดโจทย์ไว้ชัดเจนใน 44 อาชีพ
ส่วนตัวเลขอื่นไม่ได้ผิด เพียงแต่ตอบคนละคำถาม การอ่าน benchmark ให้แม่นจึงไม่ใช่การดูว่าเปอร์เซ็นต์ไหนสูงสุด แต่คือการดูว่า benchmark นั้นวัดงานแบบเดียวกับที่เราต้องการใช้ GPT-5.5 หรือไม่
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
ตัวเลขนี้มีประโยชน์มากเมื่อต้องมอง GPT-5.5 ในฐานะโมเดลสำหรับงานทำงานจริง เช่น การอ่านโจทย์ การวางโครงงาน และการผลิตผลลัพธ์ตามเงื่อนไขที่กำหนดไว้ อย่างไรก็ตาม GDPval ไม่ได้แทนทุกมิติของการใช้ AI จึงไม่ควรถูกใช้เป็นคำตอบครอบจักรวาลสำหรับทุกกรณี
ตัวเลขสำคัญที่มีการอ้างถึง Benchmark หรือดัชนี ค่าที่รายงาน วัดเรื่องอะไร ควรอ่านอย่างไร GDPval 84.9% งานเชิงความรู้ที่กำหนดโจทย์ชัดเจน ครอบคลุม 44 อาชีพ เป็นค่าที่ OpenAI ระบุโดยตรง จึงเหมาะเป็น benchmark สั้น ๆ สำหรับภาพรวมงานความรู้ Expert-SWE 73.1% งานเขียนโค้ด โดยรายงานว่าเป็นการประเมินภายในสำหรับงานที่คาดว่าใช้เวลาทำ 20 ชั่วโมง เหมาะกว่า GDPval หากโจทย์คือ software development แต่ไม่ใช่ตัวเลขที่เทียบกับ GDPval ได้ตรง ๆ BixBench 80.5% benchmark ชีวสารสนเทศจากงานจริง เกี่ยวข้องกับ bioinformatics โดยเฉพาะ แต่ในชุดแหล่งข้อมูลนี้หลักฐานควรอ่านระวังกว่าค่า GDPval ที่มาจาก OpenAI โดยตรง Artificial Analysis Intelligence Index อันดับ 1 นำ 3 คะแนน ดัชนีเปรียบเทียบโมเดลจากผู้ประเมินภายนอก มีประโยชน์สำหรับดูภาพรวมการแข่งขันของโมเดล แต่ไม่ใช่ benchmark ทางการตัวเดียวจาก OpenAI
ทำไม 84.9%, 73.1% และ 80.5% ไม่ควรถูกเทียบกันตรง ๆ ตัวเลขเปอร์เซ็นต์หลายตัวอาจทำให้ดูเหมือนเป็นคะแนนจากข้อสอบชุดเดียวกัน แต่จริง ๆ แล้วแต่ละค่าอยู่คนละสนามทดสอบ
84.9% บน GDPval วัดงานเชิงความรู้ที่ระบุโจทย์ชัดเจนในหลายอาชีพ
73.1% บน Expert-SWE วัดงาน coding ในการประเมินภายในที่รายงานว่าออกแบบสำหรับงานซึ่งคาดว่าใช้เวลาทำ 20 ชั่วโมง
80.5% บน BixBench วัดงานด้าน bioinformatics หรือชีวสารสนเทศ
แล้ว Artificial Analysis บอกอะไร Artificial Analysis รายงานว่า GPT-5.5 ขึ้นนำ Artificial Analysis Intelligence Index อยู่ 3 คะแนน รายงานเดียวกันยังระบุว่า OpenAI นำใน headline evaluations 5 รายการ และตามหลัง Gemini 3.1 Pro Preview ในอีก 3 รายการ
จุดสำคัญคือ อันดับ 1 ในดัชนีภายนอกไม่ได้แปลว่าโมเดลชนะทุกการทดสอบย่อยเสมอไป แต่หมายความว่าเมื่อรวมตามวิธีคำนวณของดัชนีนั้น GPT-5.5 อยู่ในตำแหน่งนำโดยรวม
ระวังตัวเลขพาดหัวที่หลุดจากบริบท
ควรอ้างตัวเลขไหนในสถานการณ์ไหน ถ้าจะอ้างแบบกระชับและไม่ทำให้เข้าใจผิด ควรเลือกตามบริบทดังนี้
งานเชิงความรู้ทั่วไป: 84.9% บน GDPval
งาน software development: 73.1% บน Expert-SWE
งาน bioinformatics: 80.5% บน BixBench พร้อมระบุว่าหลักฐานในชุดแหล่งข้อมูลนี้จำกัดกว่า
การเทียบโมเดลในภาพกว้าง: อันดับ 1 ใน Artificial Analysis Intelligence Index โดยนำ 3 คะแนน
สรุป ถ้าต้องเลือก benchmark สั้น ๆ สำหรับ GPT-5.5 คำตอบที่สะอาดที่สุดคือ 84.9% บน GDPval จุดแข็งของตัวเลขนี้คือมาจาก OpenAI โดยตรง และมีขอบเขตชัดเจนว่าเป็นการวัดงานเชิงความรู้ที่กำหนดโจทย์ไว้ชัดเจนใน 44 อาชีพ
ส่วนตัวเลขอื่นไม่ได้ผิด เพียงแต่ตอบคนละคำถาม การอ่าน benchmark ให้แม่นจึงไม่ใช่การดูว่าเปอร์เซ็นต์ไหนสูงสุด แต่คือการดูว่า benchmark นั้นวัดงานแบบเดียวกับที่เราต้องการใช้ GPT-5.5 หรือไม่
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News