Runwares Sonic Inference Pod: ett komplett AI-datacenter i en fraktcontainer
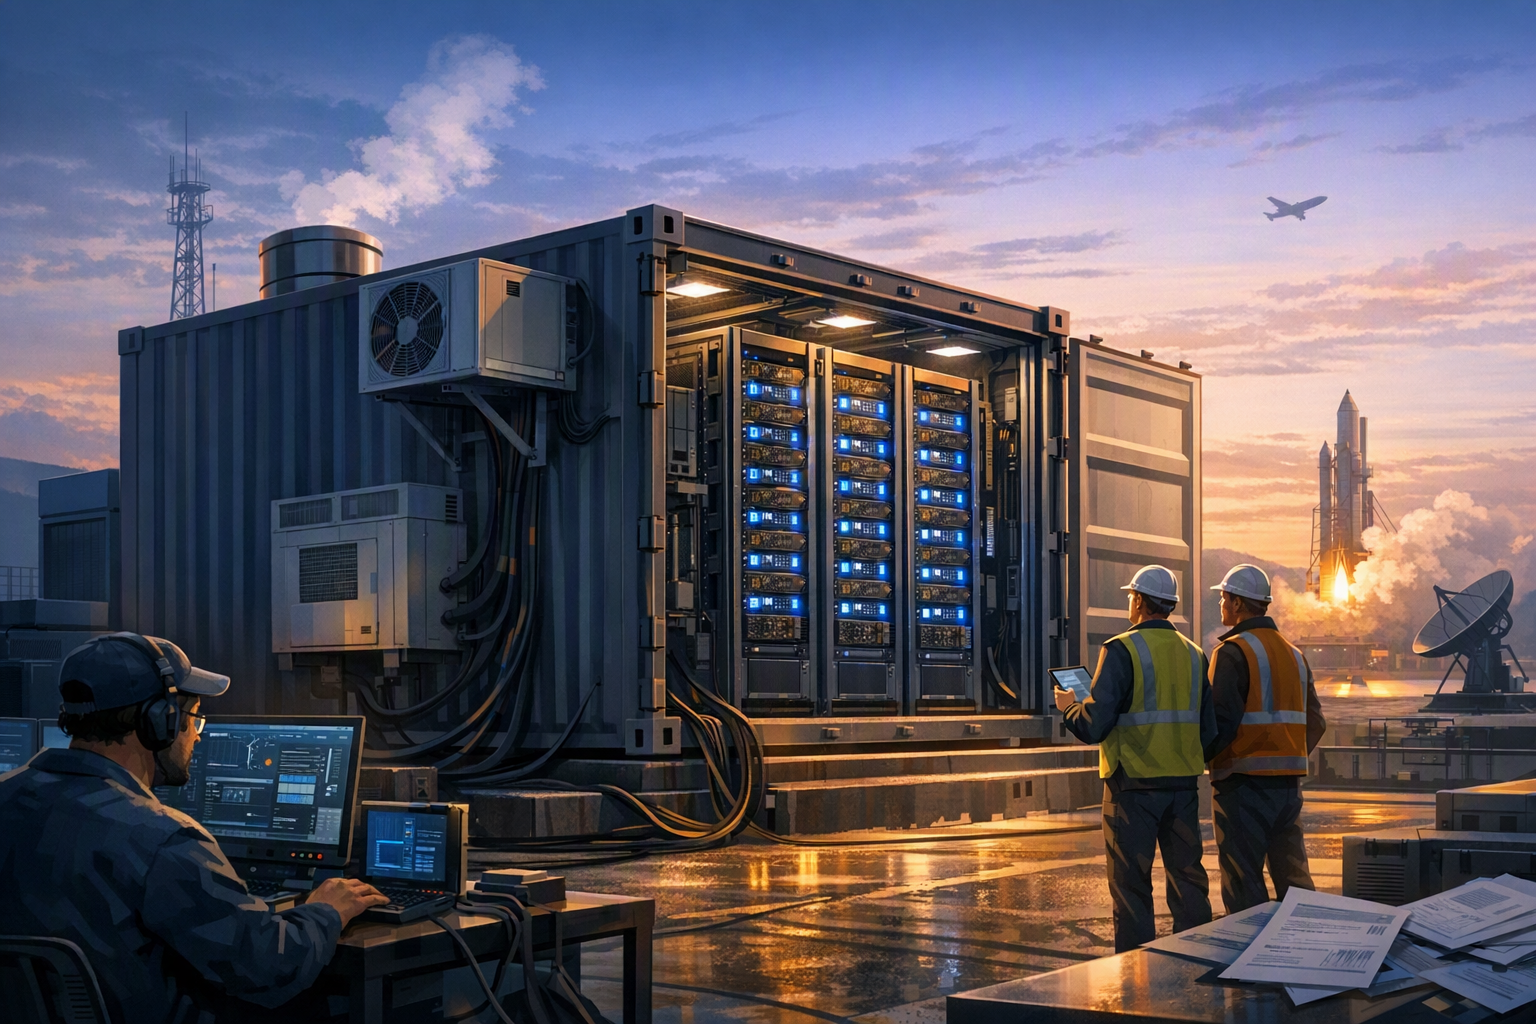
Sonic Inference Pod är ett modulärt AI datacenter i en standardiserad 20 fots fraktcontainer med omkring 1 200 GPU:er. Varje enhet ska leverera 1 MW beräkningskapacitet för AI inferens och kunna tas i drift på ungefär tre veckor.
Publicerad avRedigerad med DeepSeek-V4-FlashBilder genererade med GPT Image 1.5
Sonic Inference Pod är ett modulärt AI datacenter i en standardiserad 20 fots fraktcontainer med omkring 1 200 GPU:er.
Varje enhet ska leverera 1 MW beräkningskapacitet för AI inferens och kunna tas i drift på ungefär tre veckor.
Runware uppger att inferenskostnaden kan bli 30–80 procent lägre än hos traditionella molnleverantörer.
Tio poddar är redan utplacerade i USA, Europa och Asien–Stillahavsområdet, medan 160 platser planeras för andra halvåret 2026.
What is Runware's Sonic Inference Pod — a portable, shipping-container-based AI data center that packs up to 1,200 GPUs, delivers inferenceRunware's Sonic Inference Pod: a 1 MW AI inference data center in a 20-foot shipping container
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What is Runware's Sonic Inference Pod — a portable, shipping-container-based AI data center that packs up to 1,200 GPUs, delivers inference. Article summary: Here is a complete breakdown of Runware's Sonic Inference Pod and the company's current status, based on the August 4, 2026 launch announcements and supporting sources.. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, icons, and tiny thu
openai.com
Ett datacenter som kan köras dit det behövs
Den 4 augusti 2026 presenterade AI-inferensbolaget Runware Sonic Inference Pod – ett modulärt datacenter som samlar omkring 1 200 GPU:er och 1 MW IT-kapacitet i en 20-fots fraktcontainer .
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "Runwares Sonic Inference Pod: ett komplett AI-datacenter i en fraktcontainer"?
Sonic Inference Pod är ett modulärt AI datacenter i en standardiserad 20 fots fraktcontainer med omkring 1 200 GPU:er.
What are the key points to validate first?
Sonic Inference Pod är ett modulärt AI datacenter i en standardiserad 20 fots fraktcontainer med omkring 1 200 GPU:er. Varje enhet ska leverera 1 MW beräkningskapacitet för AI inferens och kunna tas i drift på ungefär tre veckor.
What should I do next in practice?
Runware uppger att inferenskostnaden kan bli 30–80 procent lägre än hos traditionella molnleverantörer.
Tanken är att minska väntetiden för ny AI-infrastruktur. I stället för att bygga ett traditionellt datacenter från grunden, med år av tillståndsprocesser, byggarbete och nätanslutningar, levereras podden med lastbil. Den behöver enligt Runware i praktiken mark, el och nätverksanslutning för att kunna börja hantera inferens – alltså den del där en färdig AI-modell används för att generera ett svar, en bild, en video eller annat innehåll .
Vad finns inuti Sonic Inference Pod?
Varje pod är byggd som en komplett, fristående inferensenhet. GPU:erna sitter i noder med mellan två och åtta kort. NVIDIA RTX PRO 6000 uppges vara huvudarbetskortet, medan B200- och B300-serierna är avsedda för tyngre arbetslaster .
Konstruktionen är specialanpassad från grunden: servrar utan traditionella chassin, egna rack, proprietär PCIe-växling, högfrekventa processorer och lokal NVMe-lagring. Ovanpå själva containern placeras en kylare i ungefär samma storleksklass .
Runware uppger att podden kan levereras färdigmonterad och testad. När den väl står på plats ska installationen ta omkring en dag, medan tiden från beställning till drift anges till cirka tre veckor .
Kylning utan löpande vattenförbrukning
Den höga GPU-densiteten kräver effektiv kylning. Sonic Inference Pod använder därför ett slutet vätskekylsystem som återcirkulerar omkring 1,5 kubikmeter vatten kontinuerligt. Enligt Runware innebär det ingen normal vattenförbrukning, inget spillvatten och inga utsläpp från själva kylkretsen .
Systemet kombineras med torrkylning och ska hålla temperaturen inom två grader under långvarig belastning . Det innebär inte att podden saknar vatten helt – samma mängd vätska cirkulerar i systemet – utan att den inte behöver fyllas på löpande under normal drift.
Specifikationer och kostnadsmål
Beräkningskapacitet: cirka 1 200 GPU:er och 1 MW IT-kapacitet per pod
Inferenskostnad: Runware anger 30–80 procent lägre kostnad än traditionella molnleverantörer; i vissa bolagsuppgifter nämns besparingar på upp till 90 procent
Leveranstid: ungefär tre veckor från beställning till drift
Kylning: slutet vätskekylsystem utan löpande vattenförbrukning
Nätverk: poddarna ska fungera som en gemensam flotta som i realtid styr förfrågningar till närmaste lediga kapacitet
Det sista är centralt i Runwares modell. I stället för att låta all trafik gå till ett fåtal stora, centrala datacenter vill bolaget placera beräkningskapacitet närmare både elanläggningar och användare . Kortare avstånd kan i teorin minska fördröjning och behovet av långväga överföring, även om den faktiska effekten beror på var poddarna placeras och hur nätverket används.
Tio poddar är redan utplacerade
Vid lanseringen uppgav Runware att tio poddar redan var installerade i USA, Europa och Asien–Stillahavsområdet . Europa var då den första regionen som hanterade trafik, medan utrullningen på USA:s västkust hade inletts .
Runware hade identifierat 160 platser för fortsatt expansion under andra halvåret 2026. Den första utbyggnadsvågen ska ge upp till 10 000 inferensnoder under året, och bolaget siktar på mer än 1 GW inferenskapacitet under 2027 .
Kundbasen fanns före poddarna
Sonic Inference Pod är ny, men Runwares plattform har redan använts i stor skala. Bolaget uppger att tjänsten har drivit mer än 10 miljarder AI-genereringar åt över 200 000 utvecklare och mer än 300 miljoner slutanvändare . Bland de namngivna kunderna finns Wix, Together.ai, ImagineArt, Quora, OpenArt, Freepik och Higgsfield AI, tillsammans med ett antal privata företagsinstallationer .
På sin webbplats rapporterade Runware vid mitten av 2026 över 20 miljarder hanterade förfrågningar, mer än 500 miljoner slutanvändare, över 1 miljon utvecklare och fler än 400 000 modeller på plattformen . Siffrorna är bolagets egna och avser plattformens samlade användning, inte enbart de nya poddarna.
Finansiering på 63 miljoner dollar
Runware har tagit in två större finansieringsrundor:
13 miljoner dollar i såddfinansiering i september 2025, ledd av Insight Partners, med deltagande från a16z Speedrun, Begin Capital och Zero Prime .
50 miljoner dollar i Serie A, rapporterad i december 2025 och formellt presenterad av Runware i januari 2026. Dawn Capital ledde rundan, där även Comcast Ventures, Speedinvest, Insight Partners och a16z Speedrun deltog .
Baserat på dessa rundor uppger bolaget att den totala finansieringen uppgår till 63 miljoner dollar .
Miljöargumentet – och vad de faktiskt betyder
Runware lyfter fram fyra miljö- och infrastrukturskäl för den modulära modellen:
Ingen löpande vattenförbrukning i kylningen. Den slutna kretsen återanvänder samma kylvätska i stället för att förlita sig på vattenkrävande evaporativ kylning .
Mindre behov av långväga överföring. Poddar kan placeras nära befintliga transformatorstationer, industriparker eller andra lämpliga platser nära användarna .
Bättre utnyttjande av befintlig elkapacitet. Runware vill ansluta enheterna där el redan finns tillgänglig, i stället för att alltid kräva nya nätförstärkningar .
Snabbare etablering. En levererad podd ska kunna installeras på ungefär en dag, även om hela processen från beställning till drift tar omkring tre veckor .
Det är dock främst en förändring av hur AI-kapacitet byggs och placeras – inte ett löfte om att all energianvändning försvinner. Poddarna behöver fortfarande stora mängder el, och klimatpåverkan beror bland annat på vilken energimix som används på varje plats.
En möjlig ny modell för AI-infrastruktur
Sonic Inference Pod är Runwares försök att göra AI-infrastruktur mer modulär och flyttbar. Om bolagets tidsplan håller kan nya kapacitetsenheter placeras där el, nätanslutning och efterfrågan redan finns, i stället för att all AI-trafik koncentreras till avlägsna jättedatacenter .
Med tio poddar i drift, 160 identifierade platser och målet att nå över 1 GW kapacitet 2027 återstår den stora frågan: om modellen kan skalas i praktiken med samma kostnad, prestanda och driftsäkerhet som Runware nu utlovar.
runware.aiSonic Inference Pods: Dramatically Cheaper AI Inference
unite.aiRunware dodává kontejnerové datové centrum pro umělou inteligenci za nižší cenu
finance.yahoo.comRunware Unveils the Sonic Inference Pod, a Modular Data ...
runware.aiIntroducing Sonic Inference Pods: Modular data centers built for ...
linkedin.comExcited to bit of what I've been working on: Runware is ...