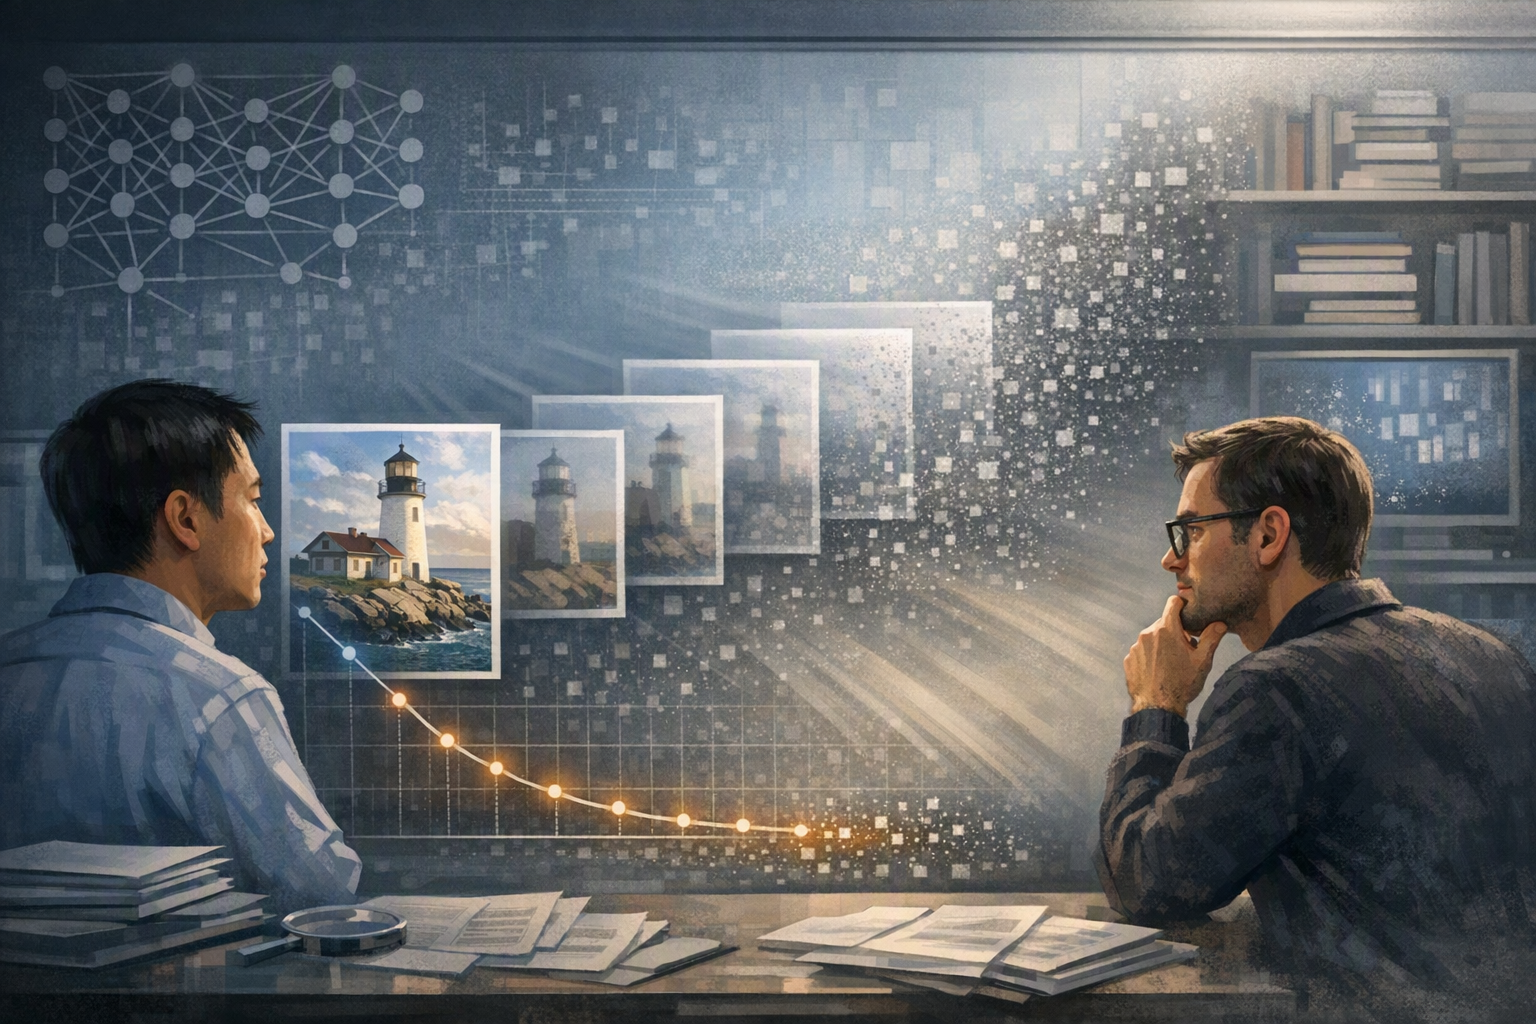
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder. Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
Publicerad avRedigerad med GPT-5.6 LunaBilder genererade med GPT Image 1.5
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder.
Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
När datamängderna växte blev enskilda bilder allt mindre avgörande. Vid större skala kunde även en hel konstnärs verk eller alla fotografier av en viss person tas bort utan någon tydlig förändring i resultatet.
Resultatet försvårar en enkel förklaring där en viss bild direkt orsakar ett AI resultat, men avgör varken om upphovsrätt har kränkts eller om modellen har memorerat material.
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-Attribution decay describes how a diffusion model’s output becomes harder to link to any single training image as the dataset grows.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-. Article summary: Dai and Gifford found “attribution decay”: as a diffusion image generator is trained on more data, the causal effect of any one training item on a particular generated image can shrink until it is too small to detect. Th. Topic tags: general, education, general web, user generated, government. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, wat
openai.com
En studie från MIT:s Computer Science and Artificial Intelligence Laboratory, CSAIL, pekar på ett problem för den som vill spåra en AI-genererad bild tillbaka till en bestämd källa: attribution decay, eller ungefär ”attribueringsförsvagning”.
När en diffusionsmodell tränas på allt fler bilder kan den mätbara, kausala påverkan från ett enskilt tränings exempel på ett visst resultat bli så liten att resultatet knappt förändras när bilden tas bort.
Det betyder inte att modellen aldrig såg bilden, att den inte kan återskapa den eller att upphovsrättsrisker försvinner. Studien visar ett snävare tekniskt resultat: i ett kontrollerat borttagningstest kan ett visst tränings exempel sluta vara nödvändigt för att generera ett visst resultat.
Så testade forskarna träningsdatans påverkan
Vanliga metoder för påverkananalys försöker uppskatta hur ett tränings exempel har påverkat en modell. Zheng Dai och David Gifford valde i stället att bygga en diffusionsensemble som möjliggör ett kontrollerat kontrafaktiskt test. Ensemblen består av självständigt tränade komponenter, där varje komponent får tillgång till en noggrant utformad del av träningsdatan.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "När AI-bilden tappar spåret till sitt ursprung"?
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder.
What are the key points to validate first?
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder. Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
What should I do next in practice?
När datamängderna växte blev enskilda bilder allt mindre avgörande. Vid större skala kunde även en hel konstnärs verk eller alla fotografier av en viss person tas bort utan någon tydlig förändring i resultatet.
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder. Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
Publicerad avRedigerad med GPT-5.6 LunaBilder genererade med GPT Image 1.5
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder.
Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
När datamängderna växte blev enskilda bilder allt mindre avgörande. Vid större skala kunde även en hel konstnärs verk eller alla fotografier av en viss person tas bort utan någon tydlig förändring i resultatet.
Resultatet försvårar en enkel förklaring där en viss bild direkt orsakar ett AI resultat, men avgör varken om upphovsrätt har kränkts eller om modellen har memorerat material.
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-Attribution decay describes how a diffusion model’s output becomes harder to link to any single training image as the dataset grows.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-. Article summary: Dai and Gifford found “attribution decay”: as a diffusion image generator is trained on more data, the causal effect of any one training item on a particular generated image can shrink until it is too small to detect. Th. Topic tags: general, education, general web, user generated, government. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, wat
openai.com
En studie från MIT:s Computer Science and Artificial Intelligence Laboratory, CSAIL, pekar på ett problem för den som vill spåra en AI-genererad bild tillbaka till en bestämd källa: attribution decay, eller ungefär ”attribueringsförsvagning”.
När en diffusionsmodell tränas på allt fler bilder kan den mätbara, kausala påverkan från ett enskilt tränings exempel på ett visst resultat bli så liten att resultatet knappt förändras när bilden tas bort.
Det betyder inte att modellen aldrig såg bilden, att den inte kan återskapa den eller att upphovsrättsrisker försvinner. Studien visar ett snävare tekniskt resultat: i ett kontrollerat borttagningstest kan ett visst tränings exempel sluta vara nödvändigt för att generera ett visst resultat.
Så testade forskarna träningsdatans påverkan
Vanliga metoder för påverkananalys försöker uppskatta hur ett tränings exempel har påverkat en modell. Zheng Dai och David Gifford valde i stället att bygga en diffusionsensemble som möjliggör ett kontrollerat kontrafaktiskt test. Ensemblen består av självständigt tränade komponenter, där varje komponent får tillgång till en noggrant utformad del av träningsdatan.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "När AI-bilden tappar spåret till sitt ursprung"?
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder.
What are the key points to validate first?
I en studie från 2026 analyserade forskare 24 diffusionsensembler och sju offentliga bildsamlingar, med datamängder på mellan 256 och över 160 000 bilder. Forskarna kunde stänga av påverkan från utvalda träningsbilder utan att träna om hela modellen, och jämförde sedan originalbilden med kontrafaktiska versioner.
What should I do next in practice?
När datamängderna växte blev enskilda bilder allt mindre avgörande. Vid större skala kunde även en hel konstnärs verk eller alla fotografier av en viss person tas bort utan någon tydlig förändring i resultatet.
Det gör det möjligt att ställa en konkret fråga: Vad skulle modellen ha genererat om den här bilden inte hade påverkat träningen? I stället för att träna om en stor modell från grunden kan forskarna stänga av de komponenter som har sett den utvalda bilden och sedan skapa ett jämförelseresultat. Det är en ablation av bildens påverkan – inte bara en uppskattning av den.
Forskarna utvärderade 24 diffusionsensembler på sju offentliga bildsamlingar. Datamängderna sträckte sig från 256 bilder till över 160 000, vilket gjorde det möjligt att undersöka hur attribueringen förändrades när mängden träningsdata ökade. De jämförde en ursprunglig generering med kontrafaktiska versioner där utvalda träningsenheter hade utelämnats.
Den största uppmätta skillnaden mellan originalresultatet och de kontrafaktiska resultaten kallades counterfactual radius, eller kontrafaktisk radie. Måttet användes för att beskriva hur mycket en enskild borttagen träningsenhet kunde förändra resultatet.
Vad innebär ”attribution decay”?
Den kontrafaktiska radien minskade när träningsdatamängderna växte. I praktiken innebar det att en bild oftare kunde tas bort utan att resultatet förändrades på ett sätt som var tydligt enligt studiens mätmetod.
Det är ett något kontraintuitivt resultat: mer träningsdata kan göra en genererad bild mindre möjlig att koppla till ett enskilt exempel, även när exemplet faktiskt ingick i träningsdatan. Modellen kan i stället lära sig breda och överlappande mönster från många källor, snarare än att förlita sig på en identifierbar bild för ett specifikt resultat.
Vid tillräckligt stor skala gällde effekten inte bara enskilda bilder. Studien rapporterade att det i det testade kontrafaktiska scenariot även kunde gå att ta bort alla bilder av en viss konstnär, eller alla fotografier som föreställde en viss person, utan att det genererade resultatet förändrades nämnvärt.
Det är därför forskarna talar om en försvagning snarare än en vanlig misslyckad spårning. Problemet behöver inte vara att utredarna saknar ett tillräckligt kraftfullt verktyg. Den kausala kopplingen mellan en källa och ett resultat kan i sig ha blivit för utspridd för att isoleras.
Kan det påverka upphovsrättsmål?
Attribution decay kan göra en viss typ av upphovsrättsanspråk svårare att bevisa: påståendet att ett omtvistat resultat direkt orsakades av en namngiven konstnärs verk, eller av kopior av dessa verk, i träningsdatan.
Om det inte gör någon märkbar skillnad att ta bort en hel konstnärs verk blir det svårare att hävda att just den samlingen var individuellt nödvändig för den specifika bilden enligt det kausala testet. Storskalig träning försvagar därmed en enkel berättelse där ett lätt igenkännbart resultat betraktas som den direkta produkten av ett identifierbart verk eller en enskild konstnär. Studien kan därför komplicera immaterialrättsliga processer som rör generativa bildsystem.
Men forskningen avgör inte om ett företag har gjort sig skyldigt till upphovsrättsintrång, och den skapar inte automatiskt något juridiskt försvar. Upphovsrättstvister kan handla om flera olika frågor, bland annat:
om skyddade verk kopierades under träningen;
om ett resultat är väsentligen likt ett skyddat verk;
vad systemet kan återskapa med vissa instruktioner;
vilken skada som har uppstått; och
vilka avtalsvillkor eller andra rättsliga regler som gäller.
Den tekniska betydelsen av ”kan inte attribueras” ska alltså inte blandas ihop med den juridiska betydelsen av ”har inte kopierats”.
Studien visar inte att AI saknar minne
Experimentet undersöker hur känsligt resultatet är för att enskilda träningsenheter tas bort. Det testar inte alla sätt på vilka en modell kan behålla eller återskapa information.
En modell kan visa liten beroendekänslighet för en viss bild i borttagningstestet och ändå återskapa ett särskilt verk vid vissa instruktioner eller under vissa villkor för slumpning. Ett resultat kan också likna ett skyddat verk även om ingen enskild träningsbild kan visas vara kausalt nödvändig för resultatet.
Det är därför viktigt att skilja mellan tre påståenden:
Bilden påverkade resultatet: borttagningstestet visar en mätbar förändring när bildens påverkan tas bort.
Modellen såg eller behöll bilden: modellen fick tillgång till bilden och kan ha memorerat delar av den.
Resultatet kopierar ett skyddat verk: en juridisk och teknisk slutsats som kräver ytterligare bevisning.
Attribution decay berör direkt den första frågan. Den avgör inte den andra eller tredje.
Gäller resultatet även språkmodeller?
Studien handlar om diffusionsbaserade generativa modeller för bilder och närliggande audiovisuellt material. Ensemblens arkitektur och det observerade skalningsmönstret kan därför inte automatiskt överföras till transformerbaserade stora språkmodeller, så kallade LLM:er.
Språkmodeller har andra arkitekturer, träningsmetoder, tokenrepresentationer och sätt att generera resultat. Studien kan ge idéer till framtida forskning om attribuering, men den visar inte att samma form av attribution decay förekommer i LLM:er.
Vilka andra bevis behövs?
När frågan är om ett AI-system har kopierat ett verk är attribution decay bara en del av bilden. Domstolar och tekniska utredare kan fortfarande behöva granska:
om systemet kan återskapa ett specifikt verk med kontrollerade instruktioner;
visuell likhet mellan resultatet och det påstått kopierade verket;
uppgifter om träningsdatans ursprung, åtkomst och användning;
modellrevisioner och teknisk dokumentation;
om resultatet uttrycker en bred stil eller ett identifierbart, skyddat uttryck; och
vilka juridiska kriterier som gäller i den aktuella tvisten.
Studiens viktigaste slutsats är därför mer avgränsad – och mer användbar – än påståendet att AI ”glömmer” sina källor. När diffusionsdatamängder växer kan den kausala insatsen från enskilda tränings exempel bli för utspridd för att upptäckas i ett visst resultat. Det gör källspårning svårare, men omöjliggör varken analyser av memorering och återskapande eller en upphovsrättslig prövning.
semafor.comGenerative AI outputs are unattributable, study finds - Semafor