AnswersPublished26 sources
Samsung vill stapla HBM-minne direkt på AI-chip
Samsung säger att zHBM kan öka AI systemens svarshastighet med mer än tio gånger genom att stapla HBM direkt ovanpå en AI accelerator i stället för bredvid den. Bolagets mål för ett gränssnitt med zHBM är omkring 8 gånger HBM5 prestanda, över 10 gånger högre minnestäthet, cirka 3 gånger bättre energieffektivitet och...
Publicerad avRedigerad med GPT-5.6 TerraBilder genererade med GPT Image 2
Research answer
Key takeaways
- Samsung säger att zHBM kan öka AI systemens svarshastighet med mer än tio gånger genom att stapla HBM direkt ovanpå en AI accelerator i stället för bredvid den.
- Bolagets mål för ett gränssnitt med zHBM är omkring 8 gånger HBM5 prestanda, över 10 gånger högre minnestäthet, cirka 3 gånger bättre energieffektivitet och mer än 50 procent lägre termiskt motstånd.
- Ingenjörer från OpenAI och Intel bedömer att CXL främst passar som ett extra kapacitetslager och för sällan använd data, snarare än som ersättare för HBM när AI modeller körs aktivt.
AI Prompt
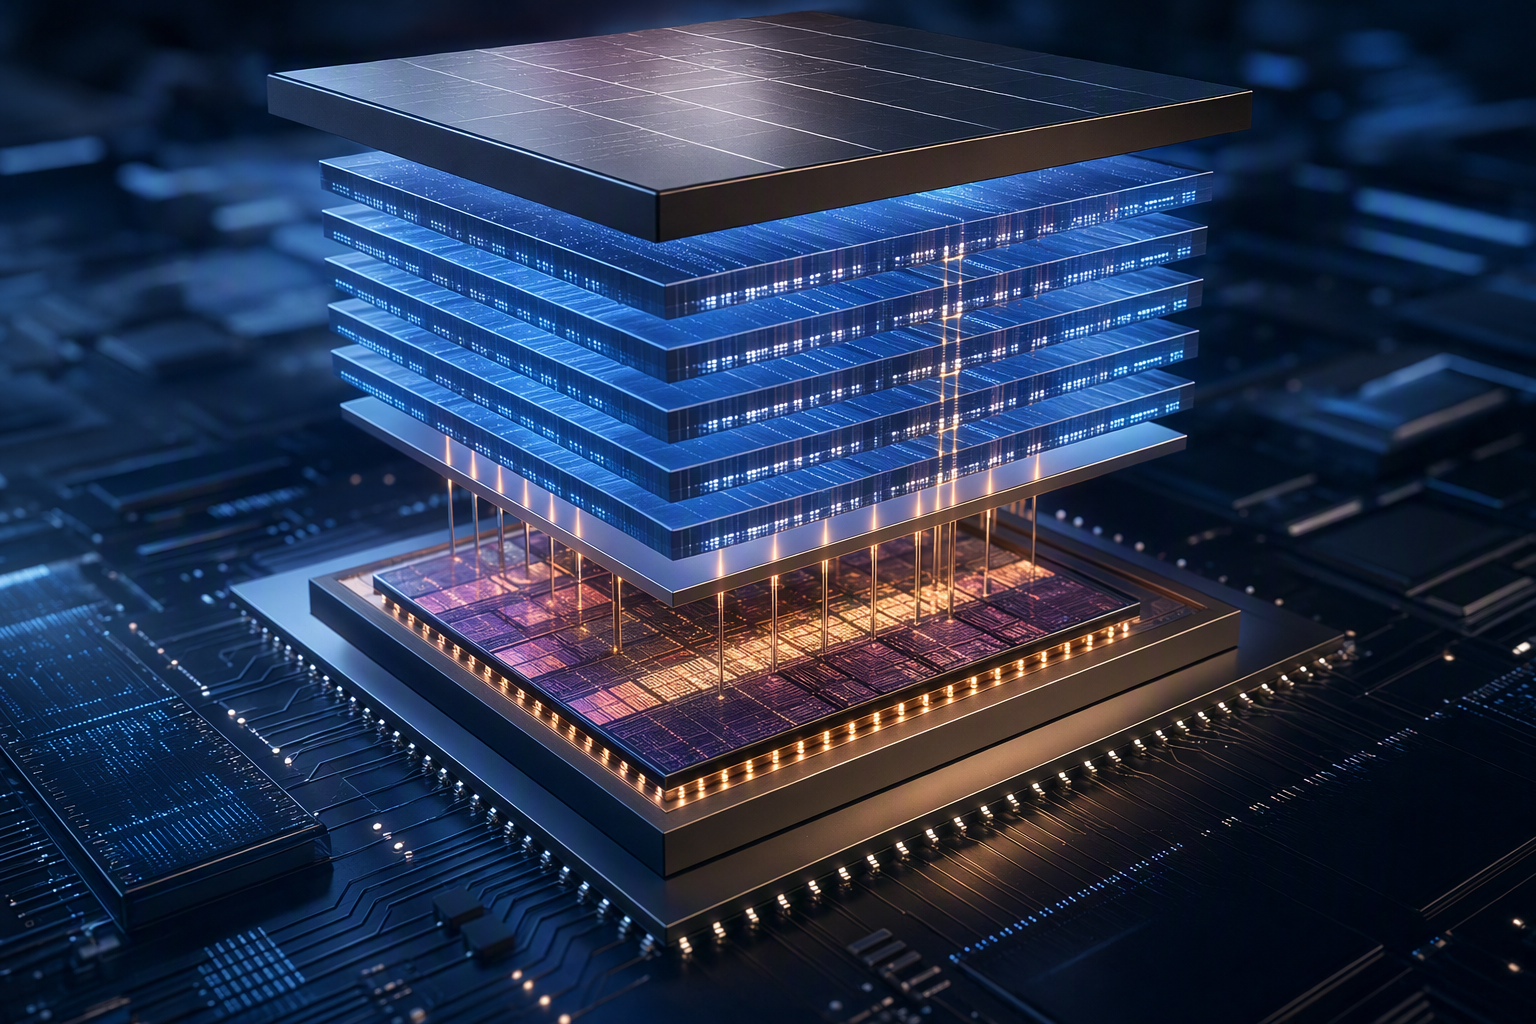
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Samsung vill flytta AI-minnet från sidan av processorn till dess ovansida. Med konceptet zHBM ska högbandbreddsminne, HBM, staplas direkt ovanpå en AI-accelerator i ett vertikalt 3D-paket. Vid AI Infrastructure Summit i Santa Clara den 16 september beskrev Samsung detta som en väg mot snabbare och mer responsiva AI-agenter. 1
9
Skillnaden mot dagens HBM-paketering
I dagens vanliga HBM-lösningar ligger minnesstackarna normalt bredvid GPU:n eller en annan AI-accelerator, sammankopplade med avancerad paketering på samma plan. Det brukar beskrivas som 2,5D-paketering. zHBM vänder i stället konstruktionen uppåt: HBM placeras direkt ovanpå acceleratorn. 12
13
Tanken är enkel: när data behöver färdas en kortare fysisk sträcka mellan beräkning och minne kan bandbredden öka och energin för dataförflyttningen minska. Samtidigt kan mer minneskapacitet få plats på samma yta. Samsung pekar på nästa generations wafer bonding, bland annat hybridkopparbindning, som en förutsättning för den vertikala integrationen. 7
48
Det är dock viktigt att skilja vision från produkt. Samsung har visat zHBM som en konceptmodell och har ännu inte presenterat någon tidplan för kommersialisering. 13
14
Samsungs löften: upp till 1 000 token per sekund
Samsung räknar med att ett framtida gränssnitt som använder zHBM ska kunna ge:
- cirka 8 gånger prestandan hos HBM5
- mer än 10 gånger minnestätheten jämfört med konventionellt HBM5
- omkring 3 gånger bättre energieffektivitet
- mer än 50 procent lägre termiskt motstånd.
13
48
Vid toppmötet sade Samsung också att zHBM skulle kunna öka AI-systemens svarshastighet med mer än tio gånger, med målet att nå 1 000 token per sekund. En token är en liten textenhet som språkmodeller bearbetar och genererar. 1
9
Siffrorna är Samsungs egna framtidsmål, inte oberoende verifierade mätresultat från en kommersiellt tillgänglig accelerator. Att stapla minne direkt över logik innebär dessutom svåra frågor om värme, tillverkningsutbyte, driftsäkerhet och kvalificering tillsammans med chiptillverkarnas plattformar.
Därför kopplas zHBM till AI-agenter
Samsung presenterade tekniken i en tid då AI-agenter får allt större uppmärksamhet. Till skillnad från en AI som bara svarar på en enskild fråga kan en agent behöva hämta kontext, köra inferens, använda verktyg och sedan skapa ett resultat – ofta i flera omgångar.
I sådana arbetsflöden räcker det inte alltid med mer beräkningskraft. Om acceleratorn tvingas vänta på data från minnet uppstår en flaskhals. zHBM är tänkt att minska just den begränsningen genom att föra HBM närmare beräkningen och göra dataförflyttningen mer energieffektiv. 1
7
Om det faktiskt leder till de utlovade förbättringarna för hela AI-tjänster beror däremot på långt mer än minnesplaceringen: acceleratorn, mjukvaran, modellen och den samlade paketeringsdesignen spelar alla roll.
zNAND-O ska ge ett tätare kapacitetslager
Samtidigt visade Samsung upp zNAND-O, en NAND-arkitektur för datatunga miljöer och edge-AI. Den placeras mellan DRAM och vanlig NAND-lagring i minneshierarkin. Målet är högre täthet än DRAM, men bättre I/O-prestanda, kortare svarstid och bättre energieffektivitet än traditionell NAND. 49
51
Produkterna har alltså olika roller:
- zHBM är tänkt som det snabbaste minneslagret precis intill acceleratorn.
- zNAND-O är tänkt som ett tätare lager för data och modellkapacitet som skulle bli dyr att hålla helt i DRAM.
49
53
Samsung hänvisade till ett test med en GPT-modell med 120 miljarder parametrar, där zNAND-O ska ha nått samma tokenhastighet som en traditionell DRAM-server till en sjättedel av driftkostnaden. Det är ett resultat som Samsung själv rapporterar från ett specifikt test, inte ett generellt kostnadslöfte för alla stora AI-modeller. 54
55
Bolaget har också kopplat zNAND-O till den långsiktiga utmaningen med mycket stora modeller på själva enheten och har sagt att AI med modeller i storleksordningen en biljon parametrar kan bli relevant lokalt på enheter omkring 2030. 53
CXL ersätter sannolikt inte HBM i aktiv AI-körning
På konferensen lyftes också en central skillnad i AI-minnesmarknaden: mer kapacitet betyder inte att alla minnestyper kan ersätta varandra.
OpenAI-forskaren Daniel Morris, som arbetar med AI-acceleratorer, sade att han inte hittat något användningsfall för CXL när AI-modeller faktiskt ska köras. Däremot kan CXL, Compute Express Link, ha ett värde för sällan använd data i stora modeller. Intels Vidia Thiagarajan beskrev på liknande sätt CXL-baserad minnespoolning som ett komplement till sekundär lagring, inte som en ersättare för HBM, eftersom bandbredden är betydligt lägre än för HBM. 18
22
Det innebär inte att CXL saknar funktion. Bilden som växer fram är snarare en minneshierarki: HBM nära acceleratorn för aktiv och bandbreddskänslig beräkning, medan CXL och andra minnes- eller lagringslager bidrar med kapacitet för mindre tidskritiska data.
Vad det betyder för Samsung och SK hynix
På kort sikt avgörs HBM-konkurrensen fortfarande av vem som kan tillverka, kvalificera och leverera minne i volym till specifika acceleratorplattformar. zHBM ger Samsung en tydlig långsiktig arkitektur att satsa på, men företaget måste fortfarande bevisa utbyte, värmehantering, tillförlitlighet och kundintegration.
Samtidigt stärker skepsisen mot att CXL skulle kunna ersätta lokalt HBM argumentet för att högbandbreddsminne nära acceleratorn förblir centralt. Den avgörande frågan är därför inte bara vem som har den mest offensiva 3D-idén, utan vem som först kan omsätta avancerad paketering och minnesteknik i kvalificerade produkter med hög volym. 18
33
36
Slutsats
Samsungs budskap är att AI-prestanda allt oftare begränsas av hur data flyttas, hur mycket minne som ryms, energiförbrukning och värme – inte enbart av beräkningskapacitet. zHBM är ett försök att lösa delar av problemet genom att bygga minnet ovanpå AI-acceleratorn, medan zNAND-O ska bidra med ett mer kapacitetstätt lager för stora AI-arbetslaster.
Potentialen i Samsungs siffror är stor, men tekniken befinner sig fortfarande på konceptstadiet. För köpare och planerare av AI-infrastruktur är den viktigaste signalen därför riktningen: framtidens AI-system lär använda allt mer specialiserade och vertikalt integrerade minneslager, där HBM fortsatt har en nyckelroll på den mest prestandakritiska beräkningsvägen. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung vill stapla HBM-minne direkt på AI-chip"?
Samsung säger att zHBM kan öka AI systemens svarshastighet med mer än tio gånger genom att stapla HBM direkt ovanpå en AI accelerator i stället för bredvid den.
What are the key points to validate first?
Samsung säger att zHBM kan öka AI systemens svarshastighet med mer än tio gånger genom att stapla HBM direkt ovanpå en AI accelerator i stället för bredvid den. Bolagets mål för ett gränssnitt med zHBM är omkring 8 gånger HBM5 prestanda, över 10 gånger högre minnestäthet, cirka 3 gånger bättre energieffektivitet och mer än 50 procent lägre termiskt motstånd.
What should I do next in practice?
Ingenjörer från OpenAI och Intel bedömer att CXL främst passar som ett extra kapacitetslager och för sällan använd data, snarare än som ersättare för HBM när AI modeller körs aktivt.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push