AnswersPublished14 sources
Wan-Animate-2 animerar karaktärer direkt från video – utan skelettdata
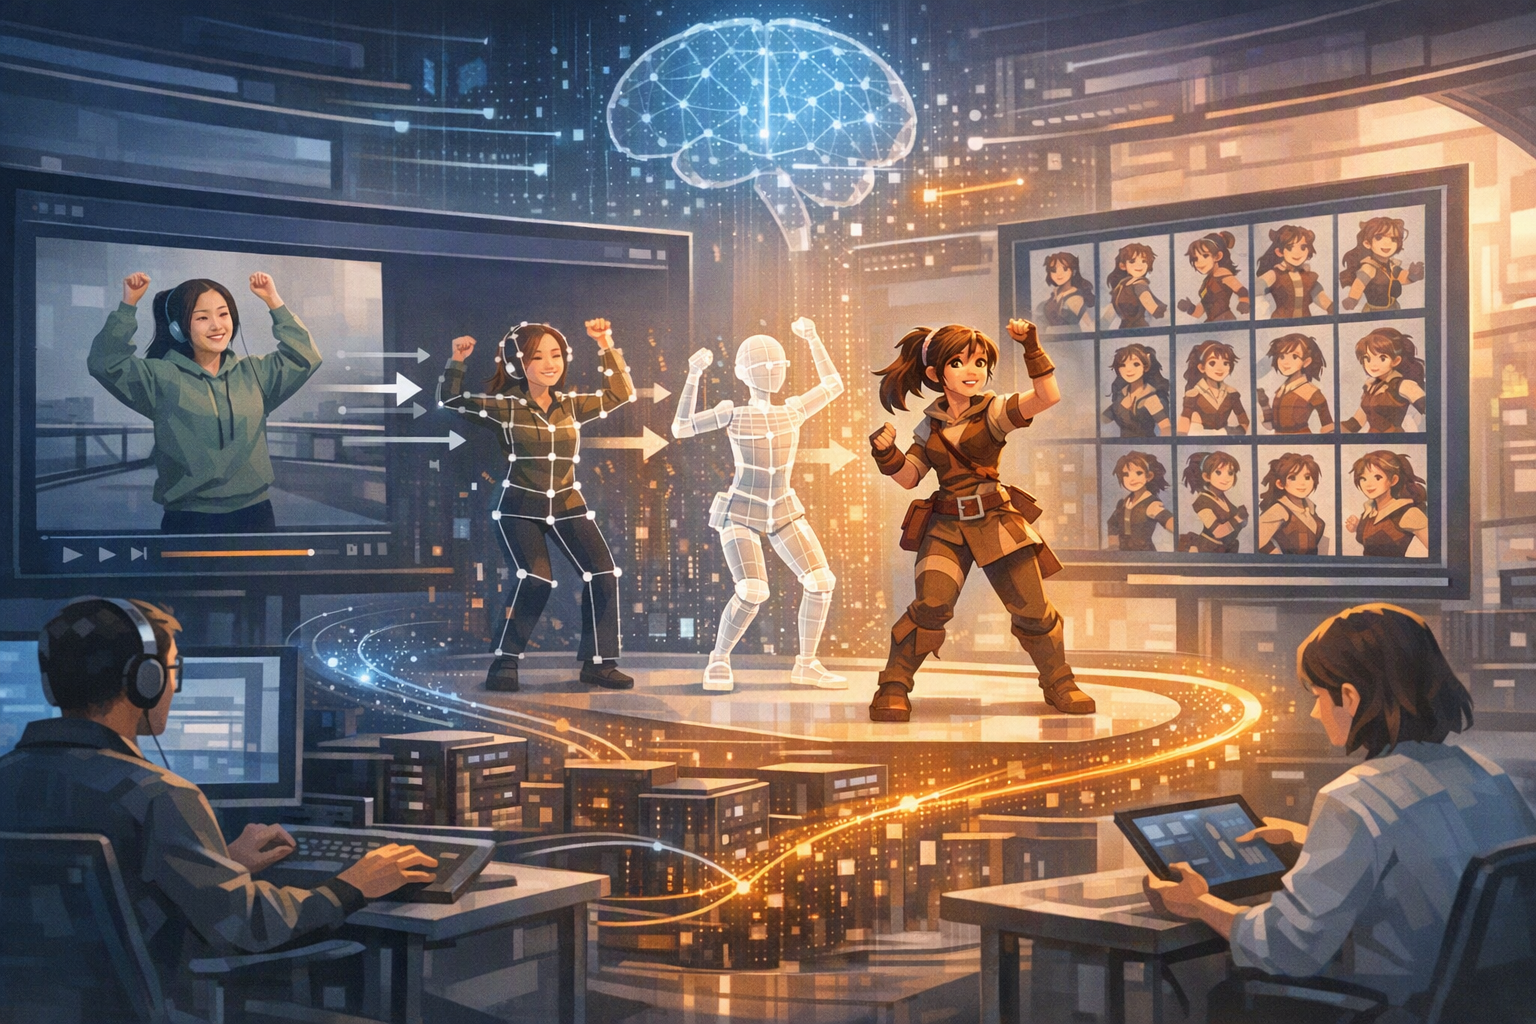
Wan Animate 2 animerar en referenskaraktär utifrån en styrande video och försöker samtidigt bevara karaktärens identitet. Modellen matar videons visuella latentdata direkt in i en Diffusion Transformer i stället för att först extrahera ett skelett eller komprimera rörelsen.
Publicerad avRedigerad med GPT-5.6 LunaBilder genererade med GPT Image 1.5
Research answer
Key takeaways
- Wan Animate 2 animerar en referenskaraktär utifrån en styrande video och försöker samtidigt bevara karaktärens identitet.
- Modellen matar videons visuella latentdata direkt in i en Diffusion Transformer i stället för att först extrahera ett skelett eller komprimera rörelsen.
- Enligt forskarna ger metoden bättre handrörelser, färre förvrängda lemmar och stabilare identitet över tid.
- Den strömlinjeformade Wan Animate 2 Lite når rapporterat 24 bilder per sekund i 400 × 720 upplösning på fyra H100 GPU:er.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Alibaba’s open source Wan Animate 2, released by the Tongyi Wanxiang team in August 2026, and how does its end to end diffusion Tran. Article summary: Wan Animate 2 is Alibaba Tongyi Lab’s open character animation system: it animates a reference character from a driving video, while retaining the character’s identity.. Topic tags: general web, prompt engineering, ai, workflow, productivity. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbna
Wan-Animate-2 är Alibabas öppna system för karaktärsanimering. I praktiken kan en användare ge modellen en referensbild eller referenskaraktär tillsammans med en så kallad styrande video – exempelvis en person som går, dansar eller gör en gest. Modellen överför rörelsen till karaktären samtidigt som den försöker bevara ansikte, kläder och visuella särdrag. 1
Den stora tekniska nyheten är att Wan-Animate-2 inte först omvandlar videon till ett mänskligt skelett eller en komprimerad rörelsebeskrivning. I stället läser en omarbetad Diffusion Transformer, eller DiT, videons visuella information direkt. Det är en viktig skillnad eftersom varje mellanled kan tappa information eller föra in fel.
Därför hoppar modellen över skelettet
Traditionella posebaserade arbetsflöden försöker ofta hitta leder och landmärken i den styrande videon. Om handen upptäcks fel, eller om kroppen delvis döljs, kan felet följa med in i animationen. En komprimerad rörelserepresentation riskerar dessutom att förenkla sådant som fingerrörelser, ansiktsuttryck och kontakt mellan personer.
Wan-Animate-2 använder i stället videons visuella latentdata i en tvådelad DiT-arkitektur. En ren referens- och rörelsegren förser den brusiga avbrusningsgrenen med information som är tidsmässigt anpassad till processen. Tanken är att behålla fler detaljer i både rum och tid, vilket enligt forskarna förbättrar rörelsens flyt och karaktärens identitetsstabilitet. 1
Bättre händer – men inga garantier
Författarna kopplar modellens förbättrade handartikulation och färre förvrängda eller saknade lemmar till att finstämda visuella rörelsedetaljer inte behöver pressas genom ett skelettbaserat mellanformat. Testerna omfattar också olika karaktärsstilar, kroppsformer, scener med flera personer och mer varierade rörelser. 1
Det betyder dock inte att varje indata blir felfri. Resultaten är framför allt ett tecken på ett bredare användningsområde än vad poseberoende system vanligtvis erbjuder – inte ett löfte om perfekt animation i alla situationer.
Kameravinkel kan styras med text
Wan-Animate-2 har även en textstyrd funktion för kamerans synvinkel. En särskild Viewpoint LoRA, tränad med syntetiskt flervydata från Unreal Engine, ska kunna skilja kamerans perspektiv från den ursprungliga styrande videon. 1
Det innebär att användaren kan be om en annan kameravinkel under körning, utan att spela in en ny föreställning eller träna om grundmodellen. Systemet är dessutom avsett för scener med flera karaktärer, där varje figur ska behålla sin egen identitet och rörelse. 3
8
24 bilder per sekund kräver datacenterklassad hårdvara
Realtidslöftet gäller framför allt den destillerade och lättare versionen Wan-Animate-2-Lite, inte nödvändigtvis den fullständiga Base-modellen. Forskarna beskriver en accelereringsprocess i tre steg: förträning med teacher forcing, en felbuffert och Self-Forcing-destillering med återkoppling över videoblock. Det gör autoregressiv streaming möjlig, där videon genereras i mindre delar i stället för först när hela sekvensen är klar. 1
Den rapporterade hastigheten är 24 bilder per sekund i 400 × 720 upplösning på fyra Nvidia H100-GPU:er. Det är ett betydande resultat för ett öppet system, men ska inte tolkas som att modellen automatiskt producerar 720p-video i 24 bilder per sekund på en vanlig hemmadator. 1
8
Hur starka är SOTA-påståendena?
I uppsatsen och tillhörande användarstudier presenteras resultat som konkurrenskraftiga med kommersiella, stängda verktyg som ByteDances Dreamina och Kuaishous KLING MotionControl. Offentlig rapportering beskriver i vissa fall resultaten som jämförbara eller likvärdiga. 1
3
Det är samtidigt viktigt att skilja mellan utvecklarrapporterade jämförelser och oberoende, standardiserade tester. ”Kommersiell SOTA” – alltså resultat i nivå med den kommersiella teknikens framkant – bör därför ses som ett starkt men fortfarande preliminärt påstående.
Varför den öppna lanseringen spelar roll
Alibaba har gjort modellvikter, kod och verktyg för inferens tillgängliga under Apache 2.0. Det ger utvecklare möjlighet att granska systemet, köra det på egen infrastruktur, anpassa det och bygga in det i egna produktionsflöden. 1
2
Det är särskilt relevant eftersom kontrollerad karaktärsanimering länge har varit en flaskhals i AI-video. Att skapa ett enskilt imponerande klipp är en sak. Att hålla samma karaktär konsekvent genom flera scener, få händer och ansikten att fungera, styra samspelet mellan flera personer och samtidigt få låg fördröjning är betydligt svårare.
En öppen modell kan också påskynda utvecklingen runt själva kärnmodellen. Communityverktyg kan bygga noder för exempelvis ComfyUI, minnessnål inferens, maskning, kompositering och karaktärskontinuitet. Hur snabbt det sker beror dock på hårdvarukostnad, reproducerbarhet, licensfrågor kring träningsdata och hur väl modellen integreras i praktiska arbetsflöden.
Wan-Animate-2 och Wan3.0 fyller olika roller
Wan-Animate-2 fokuserar på framförandet och karaktärskontrollen: hur en figur rör sig, uttrycker sig och placeras i en scen.
Wan3.0 fokuserar på ingångsmaterialet för företag. Alibaba uppger att den separat distribuerade modellen kan skapa videor på upp till 30 sekunder från bland annat dokument, kalkylblad, presentationer och webbsidor, utöver vanliga multimodala indata. 2
Tillsammans pekar systemen mot ett möjligt arbetsflöde där affärsmaterial först omvandlas till videoinnehåll och där karaktärer sedan kan animeras mer kontrollerat. Men det är två separata produkter – inte bevis på en färdig, integrerad produktionssvit från dokument till färdig animation.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Wan-Animate-2 animerar karaktärer direkt från video – utan skelettdata"?
Wan Animate 2 animerar en referenskaraktär utifrån en styrande video och försöker samtidigt bevara karaktärens identitet.
What are the key points to validate first?
Wan Animate 2 animerar en referenskaraktär utifrån en styrande video och försöker samtidigt bevara karaktärens identitet. Modellen matar videons visuella latentdata direkt in i en Diffusion Transformer i stället för att först extrahera ett skelett eller komprimera rörelsen.
What should I do next in practice?
Enligt forskarna ger metoden bättre handrörelser, färre förvrängda lemmar och stabilare identitet över tid.
Sources
arxiv.orgWan-Animate-2: Pushing the Application Boundaries of Character ...
outlookindia.comWan-Animate-2 Goes Open Source for AI Character Animation
alphasignal.aiAlibaba's Wan-Animate-2 Beats Proprietary Platforms Without a ...
opensourceforu.comAlibaba Open Sources Wan-Animate-2: Real-Time AI Character Animation - Open Source For You