AnswersPublished16 sources
En gemensam arkitektur för kodkunskap på åtta språk
Förslaget skiljer språkadaptrar från en gemensam motor för beroenden, obligatoriska deklarationer, kodning och budgetkontroll. En leverans kan vara komplett för ett avgränsat statiskt uppdrag, men ingen metod kan garantera att godtyckligt stora program ryms förlustfritt i en enda ram på 24 576 byte.
Publicerad avBilder genererade med GPT Image 2
Research answer
Key takeaways
- Förslaget skiljer språkadaptrar från en gemensam motor för beroenden, obligatoriska deklarationer, kodning och budgetkontroll.
- En leverans kan vara komplett för ett avgränsat statiskt uppdrag, men ingen metod kan garantera att godtyckligt stora program ryms förlustfritt i en enda ram på 24 576 byte.
- Historiska mätningar visar en ram på 18 869 byte och 40 godkända riktade tester – men siffrorna gäller en begränsad Python baserad körning och verifierades inte på nytt här.
- Tree sitter föreslås som strukturell parser, inte som ersättning för kompilatorer, typkontroll eller förståelse av körning.
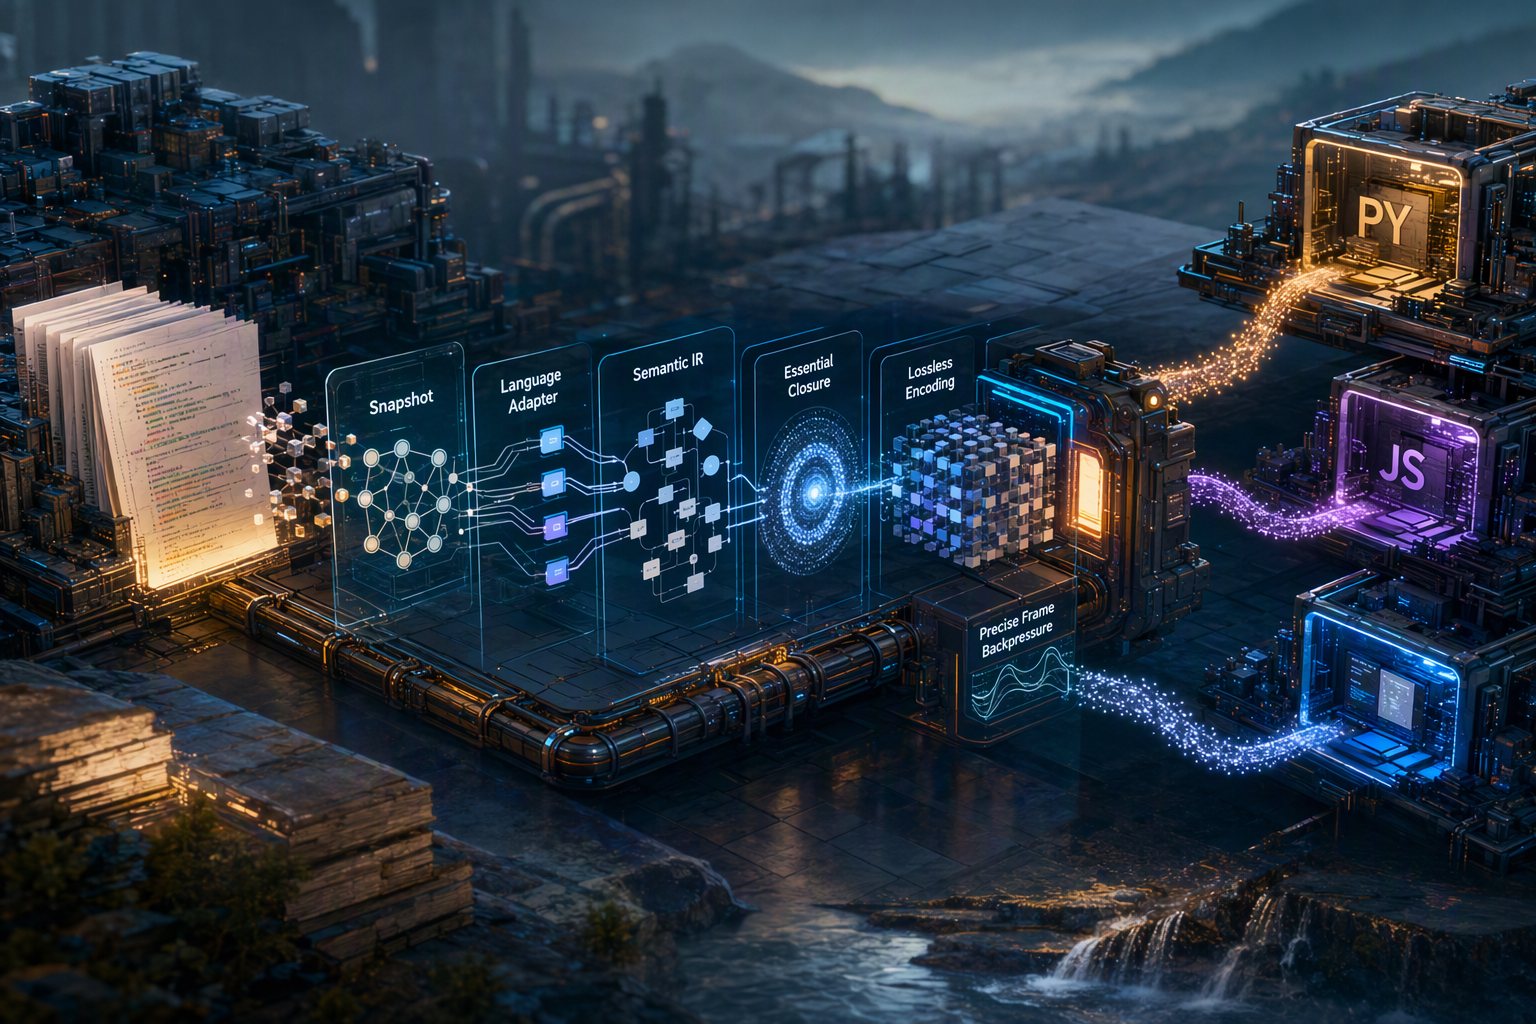
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Ett förslag – inte en färdig flerspråkig produkt
Hur sammanfattar man viktig kodkunskap från ett projekt på ett sätt som är begripligt, kontrollerbart och litet nog att skickas vidare? Förslaget här är en lagerindelad arkitektur: skrivskyddad ögonblicksbild → språkadapter → gemensam semantisk IR → obligatoriskt beroendeslutet innehåll → förlustfri kodning → exakt budgetkontroll → oberoende konsument.
Tanken är att återanvända den befintliga motorns generella mekanismer för urval och budgetkontroll, men inte dess Python-specifika regler för att tolka program. Åtta språk kräver åtta språkmedvetna adaptrar; det som kan delas är infrastrukturen efter att varje adapter har omvandlat källan till en kontrollerad gemensam representation.
Det här är ett tekniskt förslag, inte ett påstående om att stödet redan finns. Ingen fil ändrades, inget kommando kördes och ingen ny beroendekomponent installerades i arbetet bakom förslaget. Flera detaljer – bland annat officiella språkregler och de konkreta parserpaketens täckning – återstår att verifiera innan implementation kan godkännas.
Vad visar de historiska mätningarna?
En tidigare verifieringskörning rapporterade en ram på 18 869 byte för kärninnehållet från en ögonblicksbild med fem FastCode-filer. Samma historiska kvitto redovisade 79 importer, 84 deklarationer och 79 statiska beroendereferenser. De 84 deklarationerna omfattade även metoder och nästlade definitioner – inte bara publika toppnivågränssnitt.
Men resultatet var inte en fullständig beskrivning av all programsemantik. Kvittohistoriken uppger att 751 anropsuttryck utelämnades: 16 i prioriteringsnivå P2 och 735 i P3. Det är därför korrekt att kalla resultatet en partiell leverans med en redovisad kärna, inte en heltäckande återgivning av programmet.
Samma historik anger att 40 riktade regressionstester passerade. Ett äldre planeringsdokument uppger också att en större samling med 205 offline-tester hade passerat. Det är historiska uppgifter, inte resultat från en ny körning för det här förslaget. De visar inte i sig att systemet fungerar för åtta språk.
Ett tidigare experiment jämförde en full ram på 378 113 byte, en äldre kärna på 59 292 byte och den senare ramen på 18 869 byte. Skillnaden kan bero på både att valfria poster utelämnades och på ändrad representation. Den kan alltså inte tillskrivas en enda komprimeringsmetod eller användas som ett generellt löfte om hur mycket kod som alltid kan sparas.
Även befintliga gränser spelar roll. En tidigare teknisk överenskommelse anger en gräns på 22 016 byte för V2 A och 12 288 byte för V2 B. Förslagets fysiska tak på 24 576 byte ska därför inte tolkas som tillstånd att höja de äldre gränserna. Den befintliga lösningen beskrivs dessutom som Python-specifik på flera punkter, bland annat genom användning av Pythons AST. Mekanismer kan återanvändas; språkreglerna behöver skiljas ut.
Den centrala gränsen: 24 KB är ett tak, inte en garanti
Om mängden obligatoriska deklarationer är obegränsad kan den inte alltid representeras i en ram med fast storlek. Dubblettborttagning, hashar och komprimering ändrar inte den grundläggande kapacitetsgränsen.
Därför behöver systemet ha tre ärliga utfall:
- Kärnan ryms: leverera den och kontrollera att alla obligatoriska delar finns med.
- Kärnan ryms inte: stoppa och rapportera att uppdraget inte kan slutföras inom den beviljade ramen.
- Ett annat leveranssätt godkänns: exempelvis flera ramar eller separata uppdrag. Då får man inte samtidigt hävda att allt finns i en enda ram.
Den rimliga garantin är alltså begränsad: för deklarerade uppgifter och en bestämd indatamängd är det obligatoriska statiska innehållet komplett, och varje accepterad ram håller sig inom den gällande budgeten. Det är inte en garanti om att all körningssemantik, all dynamisk dispatch eller varje godtyckligt stort projekt kan återges utan förlust.
En gemensam representation – med synliga bevis och osäkerhet
Förslaget kallar den gemensamma modellen Universal Semantic Graph IR. Den ska ge språkadaptrar ett gemensamt format för kodstrukturer, beroenden, villkor och belägg. Den behöver minst fyra slags noder:
| Nod | Vad den representerar |
|---|---|
| Paket eller namnrymd | En logisk behållare. Paket, katalog och namnrymd ska inte automatiskt behandlas som samma sak. |
| Modul eller fil | En källfil eller språklig modul med en verifierbar identitet. |
| Kontraktsnod | Typer, gränssnitt, traits, strukturer, enum, alias och andra deklarationer med betydelse för ett API. |
| Anropsbar nod | Funktioner, metoder, konstruktorer och andra anropsbara deklarationer. |
Relationerna behöver också skiljas åt. DependsOn beskriver en deklarerad referens till en modul eller deklaration, Implements en uttrycklig implementeringsrelation, Calls ett anropsställe och Extends arv. Att källkoden innehåller en relation är inte automatiskt bevis för att den kompilerar eller körs som man förväntar sig. Dynamiska eller tvetydiga mål ska kunna markeras som okända i stället för att gissas fram.
Varje nod och relation bör bära källposition, villkor, regelversion och evidensnivå. En rå källbytesposition ska inte förväxlas med en parserposition efter teckenkodning; de behöver kopplas ihop genom en verifierbar mappning. En deklarationssignatur ska också hållas åtskild från en deklarationskropp: ett klasshuvud bevisar inte att hela klassens innehåll har analyserats.
I den föreslagna modellen ingår därför bland annat språkidentitet, källintervall, filhash, villkor, evidens, synlighet, signatur, noder, kanter, obligatoriska uppgifter, täckningsmått och diagnostik. Typer och fält kan hjälpa till att fånga fel, men ersätter inte kontroller av att referenser faktiskt finns, att källpositioner är giltiga och att okända tillstånd inte felaktigt rapporteras som säkra.
Synlighet är inte bara ja eller nej
Ett enda fält som säger ”publik” riskerar att dölja viktiga skillnader. Systemet bör skilja mellan deklarerad åtkomst, vilken publik som kan nå deklarationen, exporterat namn, villkor och hur starkt belägget är.
För TypeScript stöder dokumentationen exempelvis både vanliga exporter och typbaserade exporter. Type-only-importer och -exporter skiljs från värden i körningstid 3
7. Samtidigt är en moduldeklaration inte samma sak som att en post säkert är tillgänglig som ett pakets publika ingång; inställningar för paketets exports och modulläge kan spela roll
8.
För de övriga språken måste motsvarande regler behandlas som adapterpolicy som ska verifieras mot respektive språkstandard. Några viktiga försiktighetsprinciper:
- Python: ett namn som börjar med understreck är en konvention, inte en åtkomstkontroll. Dynamisk export, import och modifikatörer i körningstid får inte gissas.
- Java och C#: åtkomst i en deklaration räcker inte om en omgivande typ, modul eller container begränsar den. Delvisa deklarationer och genererad kod kan lämna frågor obesvarade.
- Go: exportregler måste följa språkets regler för identifierare; en enkel kontroll av ASCII-versaler räcker inte. Byggvillkor och plattformsfiler behöver bevaras.
- Rust: offentlig räckvidd beror bland annat på vägen genom moduler. Makron och procedurmakron ska inte behandlas som om deras genererade deklarationer redan hade analyserats.
- C och C++: att en deklaration finns i en header bevisar inte att den exporteras från en binär. Förvillkor, makron, länkning och åtkomstregler kräver separata kontroller.
När det inte går att avgöra om en deklaration tillhör den obligatoriska offentliga ytan ska den märkas som villkorad eller okänd. Om den försiktiga tolkningen gör att kärnan blir för stor ska systemet stoppa – inte anta att deklarationen är privat för att få ramen att passa.
Parser utan målmaskinens kompilatorverktyg
Förslaget väljer Tree-sitter som en möjlig strukturell grund. Tree-sitter bygger konkreta syntaxträd och är avsett att kunna parsa även medan källkod är ofullständig eller innehåller syntaxfel 11. Frågor uttrycks som mönster som matchar bestämda nodtyper i trädet
16. Det gör verktyget användbart för deklarationer och strukturer, men det gör det inte till en kompilator, typkontroll eller fullständig modell av körningstid.
Målmaskinen ska enligt förslaget inte installera språkens SDK:er eller tunga byggverktyg, till exempel JDK, .NET SDK, Node.js, Rust/Cargo, Go eller GCC/Clang. Den tänkta lösningen använder i stället befintlig Python-värd och godkända, förkompilerade parserkomponenter. Trädsitter-bindningens kompatibilitet med språkets ABI behöver kontrolleras för varje komponent; att ett paket kan hämtas eller installeras är inte samma sak som att grammatiken är kompatibel 13.
Det här är fortfarande en beroendefråga som måste godkännas. Varje komponent behöver fast version, källa, hash, licens, plattformsstöd och en genomgång av sina beroenden. Saknas en godkänd förkompilerad komponent ska systemet rapportera det, inte kompilera den lokalt eller ladda ned ett verktyg automatiskt. Parsern själv är körbar kod; det som inte ska köras är projektets egen kod, byggskript, paketåterställning eller kodgeneratorer.
Språkadaptrarna gör det som den gemensamma motorn inte kan
Varje adapter får ett fast språk-ID, versionsbunden adapter- och grammatikidentitet samt en tydlig lista över vad den kan och inte kan analysera. Den tar emot en auktoriserad källögonblicksbild och ett begränsat analyskontextobjekt. Den ska inte själv läsa godtyckliga filer, kontakta nätet, ladda pluginer eller köra kommandon.
Den gemensamma arbetsgången föreslås vara:
- Begränsa projekt och filurval med serverns auktoriseringslista.
- Läs filer till en begränsad, skrivskyddad ögonblicksbild och registrera hash och kodning.
- Välj en godkänd grammatik via språkrouter.
- Extrahera deklarationer, beroenden, villkor, synlighetskandidater och anropsställen.
- Kontrollera IR, källpositioner, referenser och diagnostik.
- Skapa den obligatoriska kärnan och mät hela den färdiga ramen.
- Låt en separat konsument avkoda, kontrollera källorna och bedöma om uppgifterna uppfyllts.
En grundprincip för traverseringen är att skilja mellan toppnivådeklarationer, API-medlemmar och beroenden i valfri omfattning. Parsern får inte gå vilse i funktionskroppar när den letar efter toppnivådefinitioner, men lokala importer får inte försvinna bara för att de inte står högst upp i filen. Villkorsblock ska bevaras i stället för att ett godtyckligt byggläge väljs. Dubbletter ska identifieras med källa och deklarationstyp – inte enbart med namn.
För varje språk behöver implementationen senare leverera en inventering av grammatiken, prov på vilka syntaxformer som fångas, negativa tester för tvetydiga fall och en oberoende kontroll av att den extraherade källtexten motsvarar de angivna bytepositionerna. Ett syntaxträd som går att skapa är inte bevis för att adaptern täcker språket.
Kärnan, kodningen och den adaptiva budgeten
Motorns del kan vara språkoberoende om den bara tar emot en redan verifierad graf, en uppsättning obligatoriska uppgifter, en kodare, en policy och en budget. Då behöver den inte tolka om källkoden eller använda olika budgetregler för olika språk. Det betyder däremot inte att språken är semantiskt likadana, att deras grafer får samma storlek eller att dagens motor redan är språkoberoende.
Bevara det nödvändiga före det valfria
Förslaget samlar prioriteringarna i tre behandlingslager:
| Lager | Innehåll | Regel |
|---|---|---|
| Obligatoriskt | P0, P1 och allt stöd som krävs för att uppfylla en obligatorisk uppgift | Får inte tas bort för att klara budgeten. |
| Semantiskt stöd | Vanligen P2 | Kan läggas till om utrymme finns; blir obligatoriskt om en uppgift beror på det. |
| Detaljer | Vanligen P3 | Kan utelämnas, men utelämnandet ska redovisas. |
Den obligatoriska kärnan är en beroendeslutning. Om en uppgift kräver en deklaration kan den också kräva signatur, villkor, alias, källbelägg och stöddeklarationer. Att spara en beroenderelation men tappa villkoret som gör den sann är inte förlustfritt.
”Förlustfrihet” bör användas med precision: kodningen kan vara förlustfri för de poster som valts ut; kärnan kan vara komplett i förhållande till de uttryckligen definierade uppgifterna; men detta är inte samma sak som att all programsemantik finns med.
Systemet bör behålla både ett kompatibilitetsläge som skyddar den tidigare mängden definitioner och ett uttryckligt API-läge som skyddar en avgränsad publik yta med stödrelationer. Det nya läget får inte i smyg göra metoder, nästlade definitioner eller osäkra offentlighetsfall valfria.
Interna tabeller kan minska upprepning
Förlustfri kodning kan använda separata tabeller för filer och sökvägar, symboler och typtexter, villkor, källpositioner och relationer. Upprepade strängar kan då ersättas av referenser, men avkodaren måste kunna återskapa exakt samma valda poster. En hash får hjälpa till med identitet och sökning, men inte ersätta källtext som behövs för att förstå en signatur.
Referenserna måste vara stabila och kontrolleras. Kollisioner ska jämföras mot originalvärdet; publika alias får inte slås ihop bara för att de liknar varandra. Det är också klokt att mäta både en direkt och en tabellbaserad representation: för små mängder kan den enklare formen bli kortare.
Det är därför inte försvarbart att lova att en generell algoritm alltid tar bort en viss andel redundans. Resultaten bör i stället redovisa separat vad som kom från att valfria poster utelämnades, vad som kom från effektivare representation och hur stor den slutliga ramen blev.
Budgetkontroll som kan stoppa
Motorn bör ha tydliga tillstånd: klar för leverans, fullständig leverans, komplett kärna med utelämnade tillval, budgetpress, kärnöverskridande och blockerad analys. Bara ett tydligt budgetproblem ska kunna ge anledning till att försöka igen med en större uttryckligen godkänd budget.
Den effektiva gränsen är det minsta av det fysiska taket, protokollets gräns, projektets gräns och anroparens tilldelning. Storleken ska mätas på hela den frysta ramen – inklusive yttre JSON-RPC, escape-sekvenser, identiteter, diagnostik och avslutande radbrytning – och samma byteföljd ska mätas och skickas.
Ett begränsat yttre försökssystem kan återanvända samma ögonblicksbild och högst tre budgetförfrågningar. Om ögonblicksbilden, behörigheten, reglerna eller protokollet ändras ska tidigare uppskattningar inte återanvändas. Källfel, parserfel och behörighetsproblem ska inte behandlas som budgetproblem.
En uppmätt mängd byte är dessutom inte samma sak som antal modelltoken. Om ramen komprimeras måste mottagaren kunna avkoda den; den komprimerade datan ska inte beskrivas som direkt läsbar kunskap för en modell. Avkodade byte och token behöver redovisas separat.
Åtta referensprojekt – och hur de ska testas
Förslaget pekar ut möjliga huvudprojekt, men de är ännu inte låsta, hämtade eller verifierade för denna plan:
| Språk | Föreslaget projekt och fokus |
|---|---|
| TypeScript | Redux: typer, lagringsskapande och exporter. |
| Java | Spring Framework, särskilt spring-core: typ- och konverterarkontrakt. |
| C# | ASP.NET Cores HTTP-abstraktioner: kontext, request/response och gränssnitt. |
| Python | FastCodes befintliga femfilsomfång: kompatibilitet, metoder, nästlade definitioner och importer. |
| Rust | ripgrep: sökkonfiguration och resultatgränssnitt. |
| Go | Gin: motor, kontext och publika deklarationer. |
| C | Redis: kärnobjekt och relaterade deklarationer. |
| C++ | fmt: formatparametrar och API i centrala headerfiler. |
Varje projekt behöver låsas innan storlekstester börjar: version eller innehållshash, licens, filurval, filhashar, vilka deklarationer som ingår, uppgifter, synlighetspolicy, villkor, förväntade resultat och versioner på adapter, grammatik och kodare. Annars finns risk att urvalet ändras efter att ett test misslyckats.
Jämförelser ska inte bygga enbart på antal rader kod. Planen föreslår både en råstorleksaxel – med FastCodes tidigare rapporterade läsmängd på ungefär 106 KB som jämförelsepunkt – och en kontraktsaxel som räknar beroenden, deklarationer, signaturbyte, villkor och alias. Små men täta publika API:er och stora mängder svårkomprimerade signaturer behöver också egna belastningsfall.
Viktiga acceptanskrav är 100 procents återkallning av den frysta, oberoende listan över obligatoriska deklarationer och beroenden; korrekt bevarande av signatur, villkor, alias och källposition; giltig avkodning; inga felaktiga säkra relationer i negativa testfall; samt en hel ram inom den tillämpliga budgeten. Alla begärda filer och deklarationer måste redovisas, även de som hoppas över eller misslyckas.
Testets facit får inte enbart skapas av samma regler som producerar resultatet. En separat granskare behöver läsa källan och jämföra med frysta förväntningar. Testerna bör också ändra deklarationsordning, alias, radslut och villkorsomslag. Extra valfri brödtext får inte tränga undan kärnan; om ett obligatoriskt API växer så mycket att ramen inte räcker ska resultatet bli ett verkligt stopp.
Först när alla åtta frysta huvudprojekt klarar kärn-, käll- och budgetkontroller kan man säga att lösningen klarat den här referenssamlingen. Det skulle fortfarande inte bevisa att varje projekt på dessa språk ryms i en ram på 24 KB.
Säkerhets- och driftgränser
Projektets källkod, kommentarer, strängar och metadata ska behandlas som opålitliga data. Förfrågningar ska kunna välja bland servergodkända projekt och bara minska omfattningen; de ska inte kunna ange godtyckliga sökvägar, webbadresser, kommandon eller pluginer.
Analysen ska inte importera målmoduler, köra dekoratörer eller annotationer, återställa beroenden eller köra bygg- och genereringsskript. Om en sekretessgranskning krockar med kravet att bevara obligatorisk information ska systemet be om godkännande eller stoppa – inte ta bort innehåll och ändå kalla resultatet komplett.
Parser-, adapter-, IR-, policy-, kodnings- och protokollversioner behöver hanteras var för sig. Ett nytt format bör upptäckas och förhandlas uttryckligen; det ska inte smygas in i ett gammalt fält eller ändra beteendet hos äldre V1/V2-konsumenter. En konsument som inte känner igen formatet ska avvisa det i stället för att gissa.
Fyra steg från Python till åtta språk
Steg 1: Python och kompatibilitet. Mappa den befintliga extraktionen till IR, lägg till signaturer och villkor och flytta Python-specifika regler till en adapter. Behåll gamla kontrakt och kontrollera att den tidigare obligatoriska mängden inte minskar. De historiska 18 869 bytena ska mätas om mot samma frysta underlag, inte behandlas som ett krav på exakt identiskt resultat.
Steg 2: Tree-sitter samt Go och TypeScript. Först efter kontroll av förkompilerade komponenter, ABI, beroenden och plattform. Täck bland annat Go-importer och exportregler, TypeScript typ- och värdeexporter, omexporter och villkor. Python kan använda en Tree-sitter-parser som separat jämförelse, utan att den stabila standardbiblioteksbaserade vägen ersätts direkt.
Steg 3: Java och C#. Lägg till paket, namnrymder, åtkomstregler, gränssnittsmedlemmar, generiska villkor, egenskaper och delvisa deklarationer. Läs bara godkänd deklarativ metadata; kör inte byggverktyg eller beroendeåterställning.
Steg 4: Rust, C och C++. Behandla Rust, C och C++ som tre separata adaptrar. Testa moduler, traits, livstider och villkor i Rust; deklaratorer, inkluderingsregler och förvillkor i C; samt mallar, åtkomst, länkning och moduler i C++. Makron och genererad kod ska inte låtsas vara analyserade när de inte har expanderats.
Varje steg kräver godkända tester utan att gamla nödvändiga kontroller plockas bort, en oberoende källkontroll, en riktig mätning av hela ramen och belägg för att målprojektets kod inte körts eller ändrats. Att godkänna ett förslag ger inte i sig tillstånd att installera beroenden, köra försök eller koppla in en värdtjänst.
Slutsats: gör osäkerheten och gränserna till en del av produkten
En gemensam kodkunskapsmotor för åtta språk framstår som genomförbar om den bygger på separata språkadaptrar, en verifierbar gemensam IR och en budgetmotor som aldrig får offra obligatoriskt innehåll i tysthet. Tree-sitter kan bidra med syntaxstrukturen; det kan inte ersätta språkstandarder, kompilatorer eller förståelse av körning.
Innan lösningen kan kallas produktionsklar återstår bland annat att verifiera språkregler och grammatiker, godkänna förkompilerade komponenter, säkra oberoende kontroll av synlighet och signaturer samt faktiskt testa alla åtta låsta referensprojekt. Det som finns här räcker för att motivera arkitekturriktningen – inte för att säga att åtta språk redan är godkända.
Den industriella kvaliteten ligger inte i ett löfte om en viss komprimeringsgrad. Den ligger i tydliga omfattningar, spårbara källbelägg, synlig osäkerhet, skyddad obligatorisk kärna och ett ärligt felmeddelande när innehållet inte ryms.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "En gemensam arkitektur för kodkunskap på åtta språk"?
Förslaget skiljer språkadaptrar från en gemensam motor för beroenden, obligatoriska deklarationer, kodning och budgetkontroll.
What are the key points to validate first?
Förslaget skiljer språkadaptrar från en gemensam motor för beroenden, obligatoriska deklarationer, kodning och budgetkontroll. En leverans kan vara komplett för ett avgränsat statiskt uppdrag, men ingen metod kan garantera att godtyckligt stora program ryms förlustfritt i en enda ram på 24 576 byte.
What should I do next in practice?
Historiska mätningar visar en ram på 18 869 byte och 40 godkända riktade tester – men siffrorna gäller en begränsad Python baserad körning och verifierades inte på nytt här.