Бенчмарк GPT-5.5: что на самом деле означает 84,9% в GDPval
Самая надежная короткая формулировка: GPT 5.5, по данным OpenAI, набирает 84,9% в GDPval — тесте на выполнение четко заданной интеллектуальной работы в 44 профессиях.[1] Другие цифры, например 73,1% в Expert SWE и 80,5% в BixBench, относятся к другим типам задач и не являются прямыми аналогами GDPval.[8][10] Во внеш...
ОпубликовалОтредактировано с помощью GPT-5.5Изображения созданы с помощью GPT Image 2
Самая надежная короткая формулировка: GPT 5.5, по данным OpenAI, набирает 84,9% в GDPval — тесте на выполнение четко заданной интеллектуальной работы в 44 профессиях.[1]
Другие цифры, например 73,1% в Expert SWE и 80,5% в BixBench, относятся к другим типам задач и не являются прямыми аналогами GDPval.[8][10]
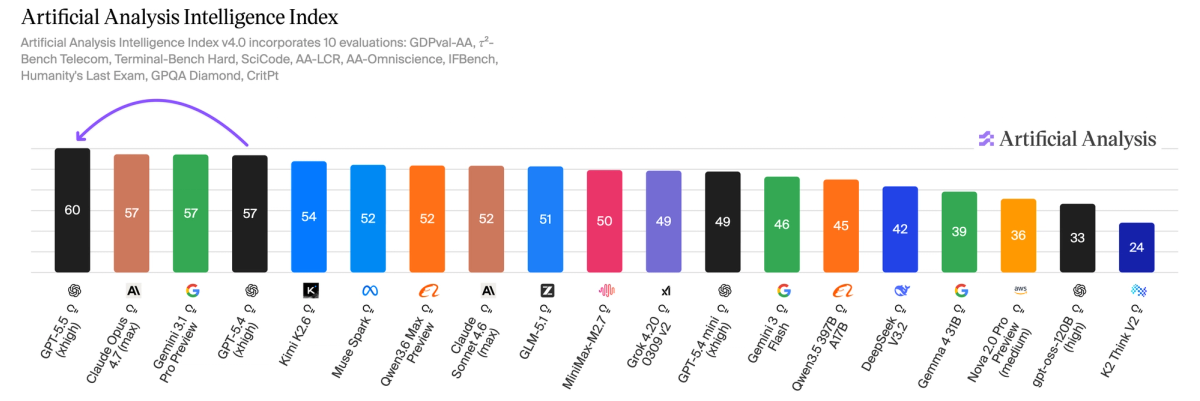
Во внешнем индексе Artificial Analysis GPT 5.5 занимает первое место с отрывом в 3 пункта, но это не значит, что модель выигрывает каждый отдельный тест.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
Промпт ИИ
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
Если нужен один короткий ответ на вопрос «какой бенчмарк у GPT-5.5?», самая аккуратная формулировка такая: GPT-5.5 набирает 84,9% в GDPval. OpenAI описывает GDPval как тест способности ИИ-агентов выполнять четко заданную интеллектуальную работу в 44 профессиях.
Но у этой цифры есть важная рамка. 84,9% — не универсальная “оценка ума” модели и не общий знак качества на все случаи жизни. Это результат в конкретном типе задач: профессиональная, хорошо сформулированная knowledge work, то есть работа с информацией, анализом и подготовкой заданного результата.
Главная цифра: 84,9% в GDPval
Для быстрых сравнений GPT-5.5 чаще всего имеет смысл цитировать именно этот показатель:
По данным OpenAI, GPT-5.5 получает 84,9% в GDPval — бенчмарке, который проверяет способность агентов выполнять четко специфицированную интеллектуальную работу в 44 профессиях.
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Каков краткий ответ на вопрос «Бенчмарк GPT-5.5: что на самом деле означает 84,9% в GDPval»?
Самая надежная короткая формулировка: GPT 5.5, по данным OpenAI, набирает 84,9% в GDPval — тесте на выполнение четко заданной интеллектуальной работы в 44 профессиях.[1]
Какие ключевые моменты необходимо проверить в первую очередь?
Самая надежная короткая формулировка: GPT 5.5, по данным OpenAI, набирает 84,9% в GDPval — тесте на выполнение четко заданной интеллектуальной работы в 44 профессиях.[1] Другие цифры, например 73,1% в Expert SWE и 80,5% в BixBench, относятся к другим типам задач и не являются прямыми аналогами GDPval.[8][10]
Что мне делать дальше на практике?
Во внешнем индексе Artificial Analysis GPT 5.5 занимает первое место с отрывом в 3 пункта, но это не значит, что модель выигрывает каждый отдельный тест.[3]
Почему именно он? Потому что это значение прямо указано в анонсе OpenAI и сопровождается описанием того, что именно измеряет тест. Это делает GDPval хорошей отправной точкой, когда речь идет о GPT-5.5 как о модели для рабочих задач, а не только для программирования, науки или узкой профессиональной области.
Почему нельзя просто сравнить все проценты
На первый взгляд 84,9%, 73,1% и 80,5% выглядят как результаты из одной таблицы. На деле это разные измерения.
Бенчмарк или сравнение
Заявленный результат
Что измеряет
Как читать результат
GDPval
84,9%
Четко заданная интеллектуальная работа в 44 профессиях
Самый удобный короткий показатель из анонса OpenAI для общей оценки GPT-5.5.
Expert-SWE
73,1%
Задачи по программированию; в сообщении Yahoo Finance это описано как внутренняя оценка OpenAI для задач с предполагаемым временем выполнения около 20 часов
Ближе к разработке ПО, но напрямую с GDPval не сравнивается.
BixBench
80,5%
Реальный бенчмарк по биоинформатике
Полезен для оценки в биоинформатике, но в предоставленных источниках подтвержден слабее, чем значение OpenAI по GDPval.
Artificial Analysis Intelligence Index
1-е место, отрыв 3 пункта
Внешний индекс сравнения моделей от Artificial Analysis
Удобен для общей картины рынка моделей, но это не отдельный официальный бенчмарк OpenAI.
Иными словами, вопрос должен звучать не «где процент выше?», а «какой тест ближе к моей задаче?». Для офисной и аналитической работы показатель GDPval информативнее. Для программирования логичнее смотреть на Expert-SWE. Для биоинформатики — на BixBench.
Что показывает внешний индекс Artificial Analysis
Artificial Analysis сообщает, что GPT-5.5 возглавляет его Intelligence Index с преимуществом в 3 пункта. Там же уточняется, что OpenAI лидирует в пяти основных оценках, а еще в трех уступает Gemini 3.1 Pro Preview.
Это важная деталь: первое место в агрегированном внешнем индексе не означает победу во всех отдельных испытаниях. Оно означает, что по методике Artificial Analysis GPT-5.5 в сумме оказывается впереди.
Осторожнее с громкими одиночными цифрами
В публикациях встречаются и другие значения: например, 91,7% в контексте legal AI-возможностей или 82,7% в связи с agentic coding. Такие числа могут быть полезны, если вас интересует именно соответствующий сценарий.
Но для общего ответа они менее удобны: без столь же ясного описания теста, набора задач и группы сравнения их легко неправильно истолковать. В этом смысле 84,9% в GDPval остается более чистой и понятной короткой ссылкой, потому что OpenAI прямо указывает и сам результат, и назначение бенчмарка.
Какую цифру цитировать
Для большинства общих материалов и сравнений лучше использовать такую формулировку:
GPT-5.5, по данным OpenAI, показывает 84,9% в GDPval; этот бенчмарк проверяет способность агентов выполнять четко заданную интеллектуальную работу в 44 профессиях.
Если контекст уже, выбирайте метрику под задачу:
Общая интеллектуальная работа: 84,9% в GDPval.
Разработка ПО: 73,1% в Expert-SWE.
Биоинформатика: 80,5% в BixBench, с оговоркой о более ограниченной источниковой базе.
Широкое сравнение моделей: 1-е место в Artificial Analysis Intelligence Index с отрывом в 3 пункта.
Вывод
Лучший короткий benchmark-ответ для GPT-5.5 — 84,9% в GDPval. Но использовать его нужно точно: это показатель для четко сформулированной профессиональной интеллектуальной работы в 44 профессиях, а не универсальный рейтинг модели на все типы задач. Остальные проценты имеют смысл только вместе с названием бенчмарка и областью, которую он проверяет.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
Почему именно он? Потому что это значение прямо указано в анонсе OpenAI и сопровождается описанием того, что именно измеряет тест. Это делает GDPval хорошей отправной точкой, когда речь идет о GPT-5.5 как о модели для рабочих задач, а не только для программирования, науки или узкой профессиональной области.
Почему нельзя просто сравнить все проценты
На первый взгляд 84,9%, 73,1% и 80,5% выглядят как результаты из одной таблицы. На деле это разные измерения.
Бенчмарк или сравнение
Заявленный результат
Что измеряет
Как читать результат
GDPval
84,9%
Четко заданная интеллектуальная работа в 44 профессиях
Самый удобный короткий показатель из анонса OpenAI для общей оценки GPT-5.5.
Expert-SWE
73,1%
Задачи по программированию; в сообщении Yahoo Finance это описано как внутренняя оценка OpenAI для задач с предполагаемым временем выполнения около 20 часов
Ближе к разработке ПО, но напрямую с GDPval не сравнивается.
BixBench
80,5%
Реальный бенчмарк по биоинформатике
Полезен для оценки в биоинформатике, но в предоставленных источниках подтвержден слабее, чем значение OpenAI по GDPval.
Artificial Analysis Intelligence Index
1-е место, отрыв 3 пункта
Внешний индекс сравнения моделей от Artificial Analysis
Удобен для общей картины рынка моделей, но это не отдельный официальный бенчмарк OpenAI.
Иными словами, вопрос должен звучать не «где процент выше?», а «какой тест ближе к моей задаче?». Для офисной и аналитической работы показатель GDPval информативнее. Для программирования логичнее смотреть на Expert-SWE. Для биоинформатики — на BixBench.
Что показывает внешний индекс Artificial Analysis
Artificial Analysis сообщает, что GPT-5.5 возглавляет его Intelligence Index с преимуществом в 3 пункта. Там же уточняется, что OpenAI лидирует в пяти основных оценках, а еще в трех уступает Gemini 3.1 Pro Preview.
Это важная деталь: первое место в агрегированном внешнем индексе не означает победу во всех отдельных испытаниях. Оно означает, что по методике Artificial Analysis GPT-5.5 в сумме оказывается впереди.
Осторожнее с громкими одиночными цифрами
В публикациях встречаются и другие значения: например, 91,7% в контексте legal AI-возможностей или 82,7% в связи с agentic coding. Такие числа могут быть полезны, если вас интересует именно соответствующий сценарий.
Но для общего ответа они менее удобны: без столь же ясного описания теста, набора задач и группы сравнения их легко неправильно истолковать. В этом смысле 84,9% в GDPval остается более чистой и понятной короткой ссылкой, потому что OpenAI прямо указывает и сам результат, и назначение бенчмарка.
Какую цифру цитировать
Для большинства общих материалов и сравнений лучше использовать такую формулировку:
GPT-5.5, по данным OpenAI, показывает 84,9% в GDPval; этот бенчмарк проверяет способность агентов выполнять четко заданную интеллектуальную работу в 44 профессиях.
Если контекст уже, выбирайте метрику под задачу:
Общая интеллектуальная работа: 84,9% в GDPval.
Разработка ПО: 73,1% в Expert-SWE.
Биоинформатика: 80,5% в BixBench, с оговоркой о более ограниченной источниковой базе.
Широкое сравнение моделей: 1-е место в Artificial Analysis Intelligence Index с отрывом в 3 пункта.
Вывод
Лучший короткий benchmark-ответ для GPT-5.5 — 84,9% в GDPval. Но использовать его нужно точно: это показатель для четко сформулированной профессиональной интеллектуальной работы в 44 профессиях, а не универсальный рейтинг модели на все типы задач. Остальные проценты имеют смысл только вместе с названием бенчмарка и областью, которую он проверяет.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News