ОтветыОпубликовано14 источники
Имплант UCSF научили одновременно распознавать речь и жесты при параличе
Учёные UCSF показали, что один высокоплотный имплант может одновременно переводить намеренную речь и движения верхней части тела в действия цифрового аватара. Модели, обученные на одновременных попытках говорить и жестикулировать, работали лучше, чем модели, обученные только на раздельных заданиях.
ОпубликовалОтредактировано с помощью GPT-5.6 TerraИзображения созданы с помощью GPT Image 2
Ответ на исследование
Ключевые выводы
- Учёные UCSF показали, что один высокоплотный имплант может одновременно переводить намеренную речь и движения верхней части тела в действия цифрового аватара.
- Модели, обученные на одновременных попытках говорить и жестикулировать, работали лучше, чем модели, обученные только на раздельных заданиях.
- Это пока проводной исследовательский прототип, а не готовая для повседневного клинического применения технология.
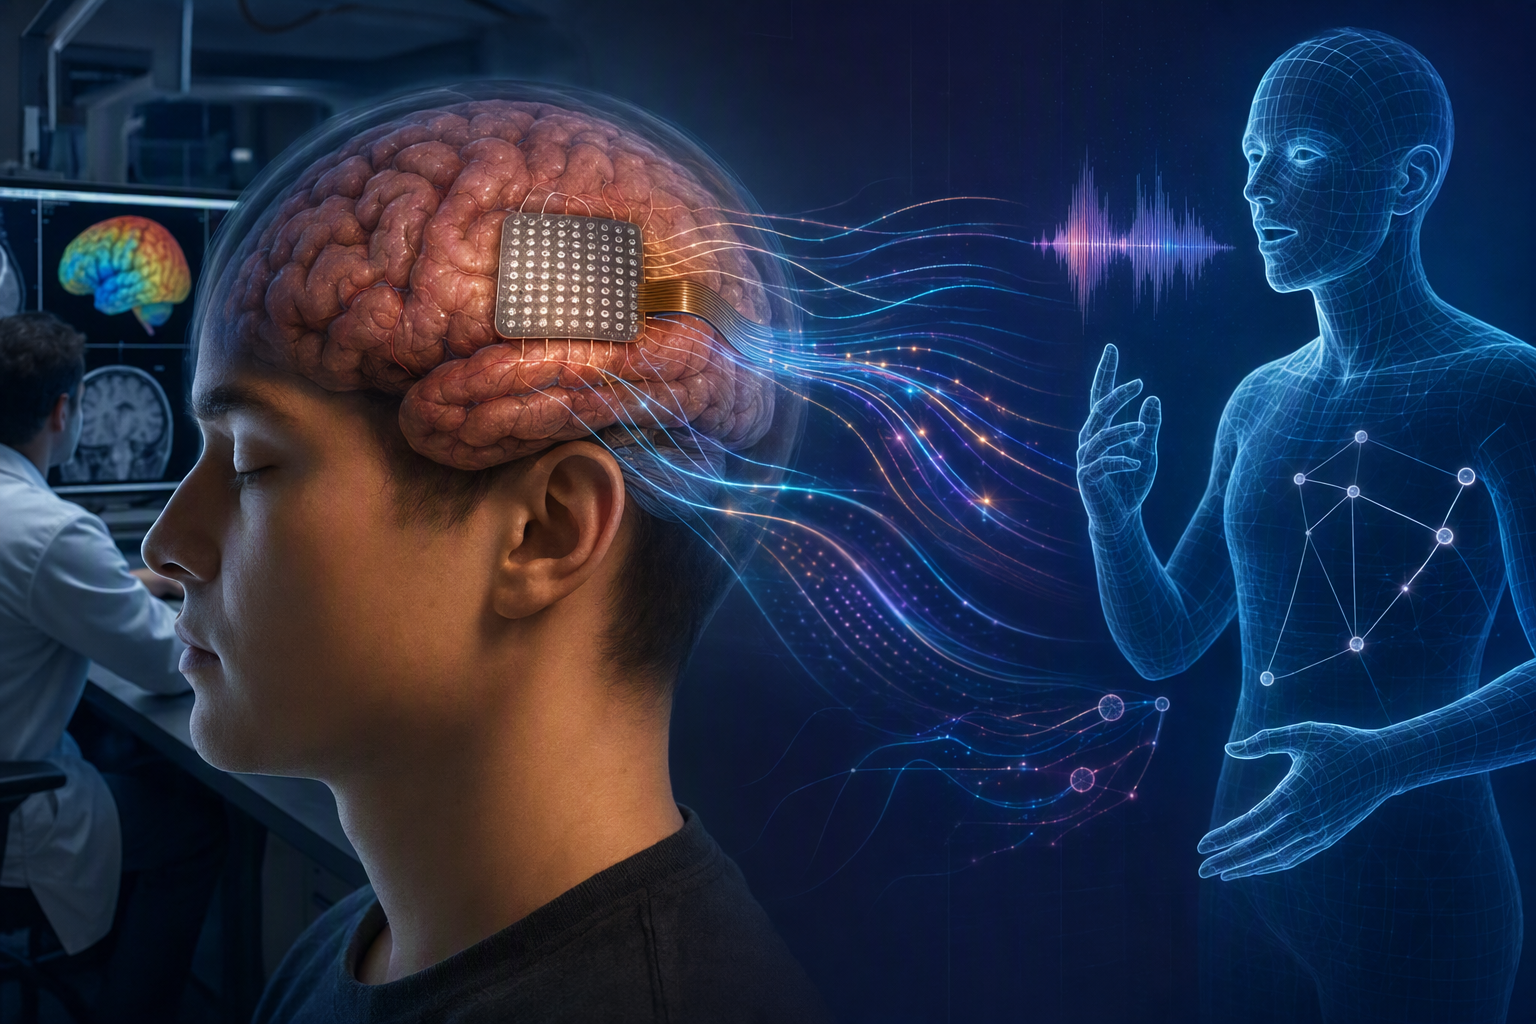
Промпт ИИ
openai.comCreate a landscape editorial hero image for this Studio Global article: How did University of California, San Francisco researchers led by neurosurgeon Edward Chang use 253 electrode electrocorticography arrays i. Article summary: Chang’s team demonstrated that one high density cortical implant can translate a person’s intended words and upper body movements at the same time—allowing a virtual body to communicate with both voice and gesture rather. Topic tags: general web, ai, workflow, productivity, code. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, chart
Разговор — это не только слова. Мы киваем, машем рукой при встрече, подчёркиваем мысль движением, показываем согласие или несогласие. Исследователи Калифорнийского университета в Сан-Франциско (UCSF) под руководством нейрохирурга Эдварда Чанга показали, что один кортикальный имплант может одновременно переводить намеренную речь и жесты верхней части тела в голос и движения виртуального аватара. Это важное доказательство принципа, но ещё не готовая к клиническому повседневному использованию система. 2
7
Как работала система
У трёх участников с тяжёлым параличом голосового тракта и конечностей — в том числе вследствие БАС и инсульта ствола мозга — на поверхности сенсомоторной коры разместили высокоплотные массивы для электрокортикографии (ECoG) с 253 электродами. ECoG регистрирует электрическую активность непосредственно с поверхности мозга.
Участники пытались произносить фразы, выполнять жесты — например, помахать рукой или показать большой палец вверх, — а также делать и то и другое одновременно. Затем алгоритмы машинного обучения сопоставляли эти сигналы с предполагаемой речью и движениями. 2
7
Одновременная коммуникация имеет свой нейронный рисунок
Речь и жесты верхней части тела были связаны с различимыми, но согласованными паттернами корковой активности. Особенно важно, что при попытке говорить и жестикулировать одновременно мозговой сигнал не сводился к простому сложению сигналов из отдельных заданий на речь и движение: у комбинированного действия был собственный характер активности. 2
7
Поэтому нельзя было надёжно считать голос и движение полностью независимыми каналами. Декодеру требовалось учиться именно совместному поведению.
Почему обучение на совместных действиях оказалось лучше
Алгоритмы, которым показывали примеры одновременных попыток говорить и жестикулировать, точнее распознавали такие действия, чем системы, обученные лишь на изолированной речи или отдельных движениях. У двух участников система в реальном времени управляла полнотелым виртуальным аватаром: синтезированная речь звучала одновременно с движениями верхней части тела. 2
7
Чем это может быть удобнее набора текста взглядом
Устройства коммуникации с управлением взглядом часто требуют последовательно выбирать буквы или пункты меню. Такой способ может быть медленным и утомительным. В живой беседе смысл передают не только слова, но и темп, акцент, поза, указательные движения, приветствие и подтверждающий кивок.
Если эти элементы удастся восстановить вместе с речью, общение потенциально станет более быстрым, менее обременительным и выразительным. Однако нынешняя работа подтверждает техническую осуществимость подхода, а не доказывает, что он уже улучшает качество жизни при длительном использовании в быту. 2
7
Что это означает для невербальной коммуникации
Работа указывает на возможность нейропротеза, который со временем сможет возвращать не только слова, но и более широкий коммуникативный замысел: согласие, эмоциональную окраску, приветствие, усиление мысли жестом и участие в смене реплик. Она также поддерживает более общий вывод: один кортикальный интерфейс способен декодировать несколько координированных способов общения. 2
7
Следующий этап — беспроводная имплантируемая система
В демонстрации использовали проводную исследовательскую установку. Команда планирует создать полностью имплантируемую беспроводную версию, чтобы убрать внешний кабель и сделать длительное ежедневное применение более практичным, одновременно развивая многоканальное декодирование. 7
Новая работа продолжает исследование 2023 года, опубликованное в Nature: тогда участница с параличом после инсульта ствола мозга с помощью корковых сигналов управляла выводом текста, синтезированной речи и лицевого аватара с мимикой. 1
3
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Люди также спрашивают
Каков краткий ответ на вопрос «Имплант UCSF научили одновременно распознавать речь и жесты при параличе»?
Учёные UCSF показали, что один высокоплотный имплант может одновременно переводить намеренную речь и движения верхней части тела в действия цифрового аватара.
Какие ключевые моменты необходимо проверить в первую очередь?
Учёные UCSF показали, что один высокоплотный имплант может одновременно переводить намеренную речь и движения верхней части тела в действия цифрового аватара. Модели, обученные на одновременных попытках говорить и жестикулировать, работали лучше, чем модели, обученные только на раздельных заданиях.
Что мне делать дальше на практике?
Это пока проводной исследовательский прототип, а не готовая для повседневного клинического применения технология.
Источники
science.orgSingle brain implant lets paralyzed people both talk and gesture via an avatar
livenowfox.comBrain implant restores gestures, speech for some paralysis patients ...
pmc.ncbi.nlm.nih.govA high-performance neuroprosthesis for speech decoding and ...
ucsf.eduHow Artificial Intelligence Gave a Paralyzed Woman Her ...