Коллапс моделей ИИ: что происходит, когда алгоритмы обучаются на собственных данных
Исследования показывают, что при многократном обучении ИИ на синтетических данных возникает «коллапс моделей»: редкие закономерности исчезают, и модель начинает искажённо отражать реальность. Рекурсивное обучение усиливает статистическое смещение — редкие события из «хвостов» распределения появляются всё реже и со в...
ОпубликовалОтредактировано с помощью GPT-5.5Изображения созданы с помощью GPT Image 2
Исследования показывают, что при многократном обучении ИИ на синтетических данных возникает «коллапс моделей»: редкие закономерности исчезают, и модель начинает искажённо отражать реальность.
Рекурсивное обучение усиливает статистическое смещение — редкие события из «хвостов» распределения появляются всё реже и со временем полностью пропадают.
Даже небольшое количество реальных данных или встроенные априорные ограничения модели могут предотвратить коллапс, сохраняя информацию о редких паттернах.
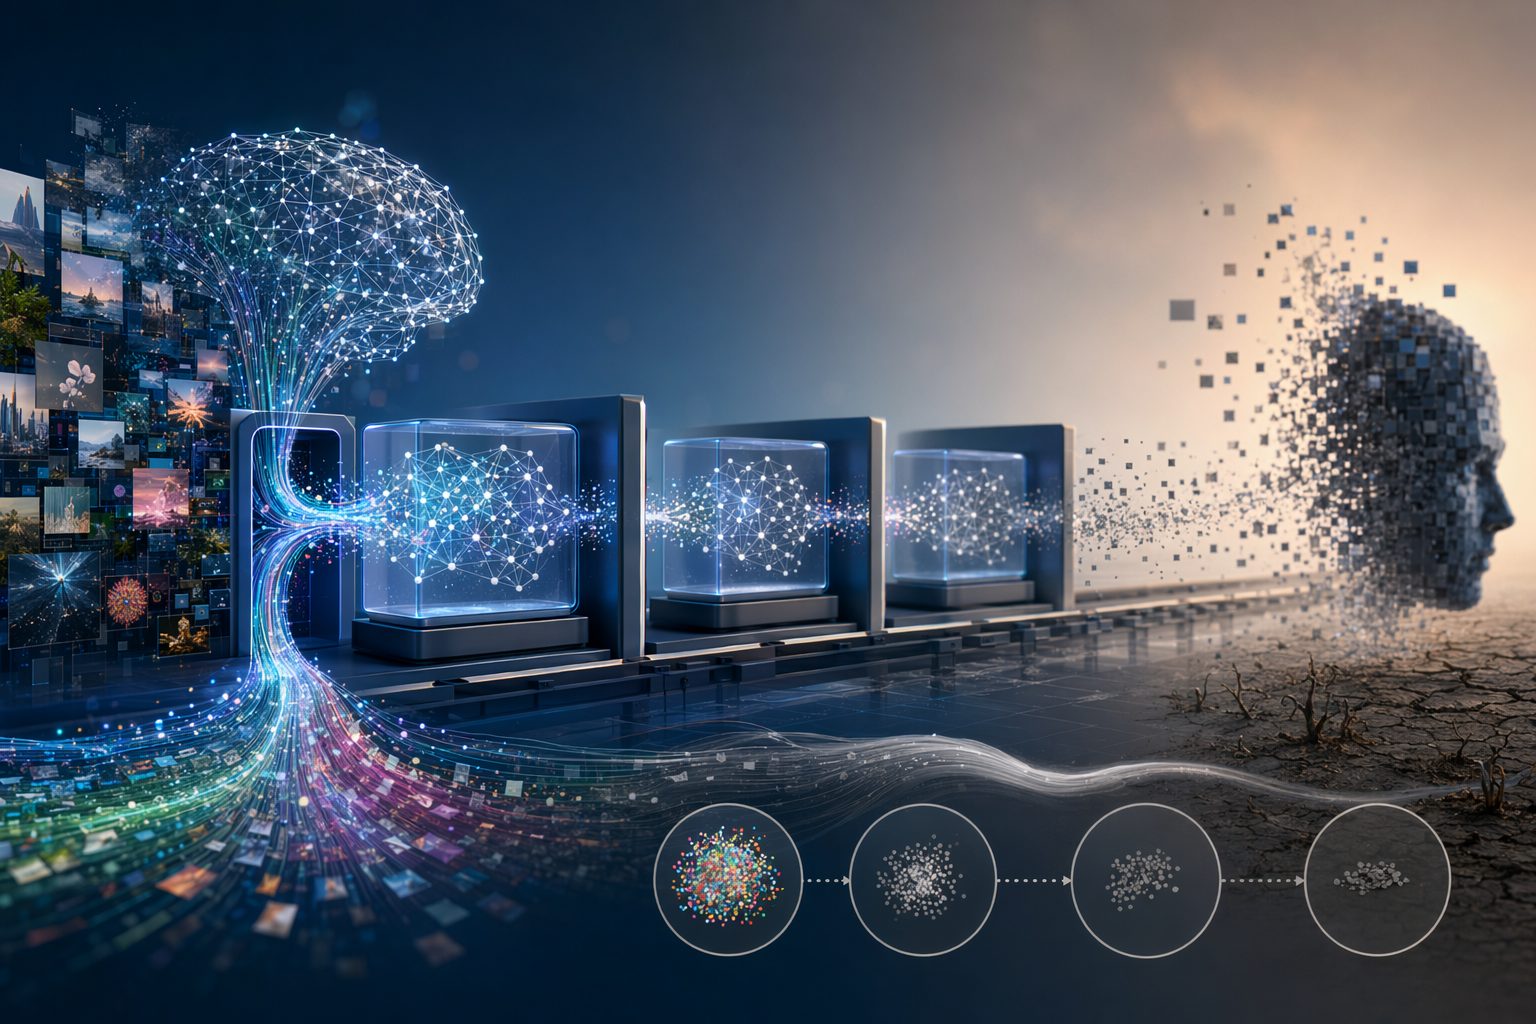
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
Промпт ИИ
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
Генеративные системы искусственного интеллекта всё чаще обучаются на синтетических данных — текстах, изображениях и других материалах, созданных предыдущими моделями. Но исследования показывают, что у такого подхода есть серьёзный риск: явление, известное как коллапс моделей (model collapse). Оно означает постепенную деградацию моделей, когда они теряют способность отражать всё разнообразие исходных данных.
Учёные обнаружили, что если модели снова и снова обучаются на результатах других моделей, а не на реальных данных, они начинают «забывать» редкие закономерности из исходного распределения. Со временем эти потери накапливаются, и представление модели о реальности становится всё более искажённым.
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Каков краткий ответ на вопрос «Коллапс моделей ИИ: что происходит, когда алгоритмы обучаются на собственных данных»?
Исследования показывают, что при многократном обучении ИИ на синтетических данных возникает «коллапс моделей»: редкие закономерности исчезают, и модель начинает искажённо отражать реальность.
Какие ключевые моменты необходимо проверить в первую очередь?
Исследования показывают, что при многократном обучении ИИ на синтетических данных возникает «коллапс моделей»: редкие закономерности исчезают, и модель начинает искажённо отражать реальность. Рекурсивное обучение усиливает статистическое смещение — редкие события из «хвостов» распределения появляются всё реже и со временем полностью пропадают.
Что мне делать дальше на практике?
Даже небольшое количество реальных данных или встроенные априорные ограничения модели могут предотвратить коллапс, сохраняя информацию о редких паттернах.
Понимание этого эффекта становится всё более важным: по мере роста количества AI‑контента в интернете будущие системы всё чаще рискуют обучаться именно на таких синтетических данных.
Что такое «коллапс моделей»
Коллапс моделей — это режим отказа генеративных алгоритмов, возникающий, когда новые модели обучаются на данных, созданных предыдущими моделями, а не на исходных человеческих данных.
Исследования показывают, что при таком рекурсивном обучении возникают необратимые дефекты: модели постепенно теряют информацию о «хвостах распределения» — редких или необычных примерах, которые встречаются нечасто, но критически важны для точного описания реального мира.
В результате:
выходы модели становятся менее разнообразными;
алгоритм всё чаще воспроизводит только наиболее типичные паттерны;
необычные случаи практически исчезают.
Этот эффект был продемонстрирован на разных типах генеративных моделей, включая:
большие языковые модели (LLM);
вариационные автоэнкодеры (VAE);
модели гауссовых смесей (GMM).
То, что коллапс проявляется сразу в нескольких архитектурах, говорит о важном выводе: проблема связана не с конкретным алгоритмом, а с самой природой генеративного обучения на рекурсивных синтетических данных.
Почему рекурсивное обучение стирает редкие паттерны
Причина во многом статистическая.
Когда модель генерирует данные, она чаще воспроизводит наиболее вероятные структуры из обучающего распределения. Редкие события находятся в его «хвостах» и при случайной выборке встречаются значительно реже.
Если следующая модель обучается на таком синтетическом наборе данных, происходит цепная реакция:
редкие примеры становятся ещё более редкими;
модель изучает уже слегка искажённое распределение;
последующие поколения усиливают это искажение.
Каждая новая итерация закрепляет смещение предыдущей. В какой‑то момент редкие примеры полностью исчезают из обучающего корпуса.
После этого восстановить их почти невозможно: доказательства того, что такие случаи существовали, просто исчезают из данных.
Как реальные данные или априорные знания предотвращают коллапс
Одно из самых неожиданных наблюдений последних исследований — для предотвращения коллапса может требоваться очень небольшое количество реальной информации.
В анализе статистических моделей из класса экспоненциальных семейств исследователи показали, что даже одна точка данных из реального распределения может выступать якорем для обучения. Она сохраняет информацию о существовании редких паттернов и не позволяет системе сходиться к неправильному распределению.
Похожую роль могут играть и априорные знания — ограничения или предположения, встроенные в модель. Они сужают пространство возможных распределений и не позволяют алгоритму полностью «уплыть» в сторону смещённых закономерностей синтетических данных.
На практике это означает:
реальные образцы поддерживают существование редких, но корректных паттернов;
априорные ограничения удерживают структуру данных;
даже при большом количестве синтетических данных обучение может оставаться стабильным.
Почему проблема особенно важна для больших языковых моделей
Для современных ИИ‑систем этот риск становится всё более актуальным.
Большие языковые модели обучаются на огромных корпусах интернет‑текста. Но по мере того как всё больше контента создаётся самими ИИ‑системами, эти данные начинают заполнять интернет — а значит, и будущие обучающие датасеты.
Если новые поколения моделей будут обучаться преимущественно на таком контенте, возможны последствия:
снижение разнообразия генерируемых ответов;
ухудшение обработки редких и необычных ситуаций;
постепенное сужение представления модели о мире.
Поэтому исследователи предупреждают: чтобы сохранить качество систем, необходимо поддерживать доступ к надежным данным, созданным людьми, или внедрять механизмы, которые сохраняют структуру исходного распределения при обучении.
Ограничения текущих исследований
Хотя сам механизм коллапса моделей хорошо подтверждён, некоторые детали остаются предметом обсуждения.
Например, вывод о том, что одна реальная точка данных может остановить коллапс, получен в основном на теоретических моделях и упрощённых статистических системах, а не на полномасштабных экспериментах с современными LLM.
Поэтому в реальных системах объём необходимых «якорных» данных может зависеть от архитектуры модели, состава датасета и процедуры обучения.
Тем не менее общий вывод остаётся очевидным: если ИИ обучается только на данных, созданных другими ИИ, со временем он начинает терять части реальности. Поддержание связи с реальными данными становится ключевым условием устойчивого развития таких систем.
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...