ОтветыОпубликовано16 источники
Как ИИ-агенту работать с большим архивом документов
Передать системе весь архив можно, но это не значит, что все материалы должны одновременно попасть в один запрос к модели. Recursive Language Models предлагают хранить длинный ввод вне окна контекста и разбирать его частями, при необходимости вызывая модель для отдельных фрагментов.[3] Для практической системы важны...
ОпубликовалИзображения созданы с помощью GPT Image 2
Ответ на исследование
Ключевые выводы
- Передать системе весь архив можно, но это не значит, что все материалы должны одновременно попасть в один запрос к модели.
- Recursive Language Models предлагают хранить длинный ввод вне окна контекста и разбирать его частями, при необходимости вызывая модель для отдельных фрагментов.[3]
- Для практической системы важны не только поиск и суммаризация, но и ссылки на источники, фиксация непрочитанного и понятные промежуточные отчёты.[7][12]
- Поэтапное чтение помогает организовать исследование, но не отменяет ограничений по времени, стоимости и надёжности.
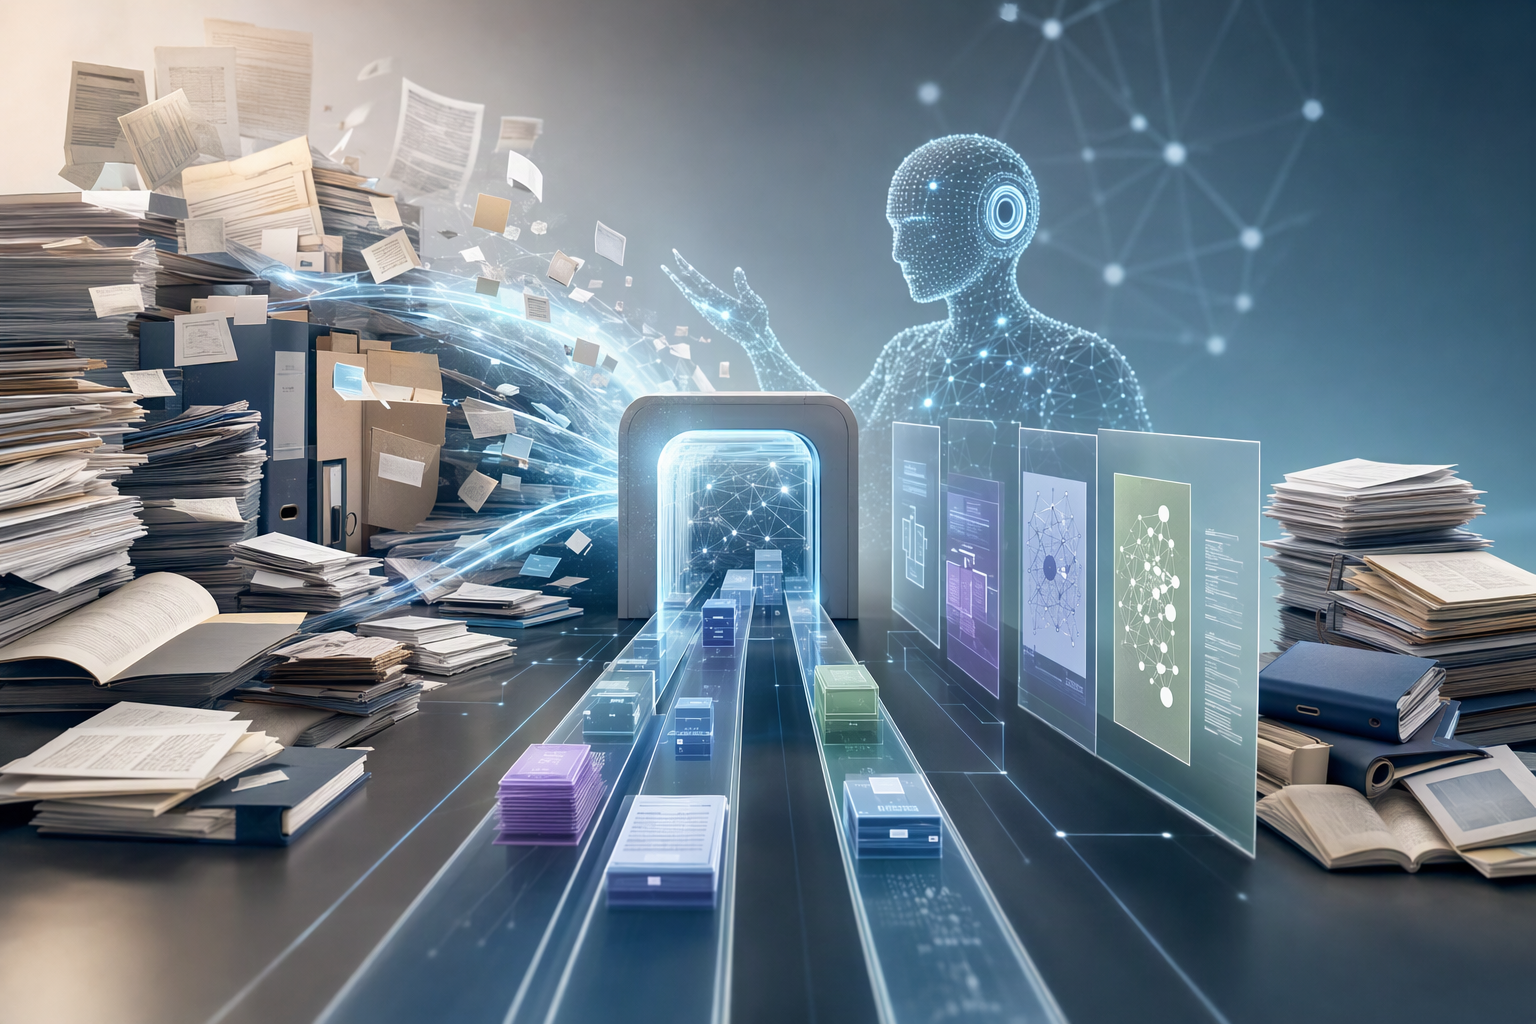
Промпт ИИ
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"需求应从“网关支持复杂附件”调整为“前置侧接收海量材料,并组织可追溯、能持续交付的研究流程”。你可以一次性交给系统全部材料,但不应要求全部材料同时进入一次模型调用;三遍阅读是分析方法,不能代替有限上下文的调度机制。[1][3]\n\n 1.. Topic tags: general web, llm, agents, ai, workflow. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, i
У исследовательской задачи часто есть неудобная формулировка: «Вот все документы — внимательно изучи их и найди решение». Материалы можно передать системе одним пакетом, но не стоит ожидать, что модель целиком удержит их в одном диалоге. Окно контекста — это рабочая область модели, и по мере роста разговора она подходит к своему пределу.1
Поэтому задача не в том, чтобы любой ценой поместить весь архив в запрос. Нужно устроить работу так, чтобы агент мог обращаться к исходникам по мере необходимости, сохранять доказательства и выдавать результат, даже если исследование занимает несколько этапов.
Не бесконечный запрос, а внешний архив
Один из подходов к длинным входным данным описан в работе о Recursive Language Models (RLM). Вместо того чтобы напрямую передавать весь большой материал модели, его рассматривают как внешнюю среду: модель исследует данные, разбивает их на фрагменты и при необходимости рекурсивно обращается к модели для анализа отдельных частей.3
Это близко к тому, что нужно для большого набора источников: оригиналы остаются доступными, а в текущий рабочий контекст попадает только то, что требуется для конкретного вопроса. Но такой подход не означает неограниченную ёмкость или безошибочную работу. В предоставленном описании исследования отдельно отмечены возможный рост расходов на вложенные вызовы и сложность ограничений и управления.
Практический вариант — сочетать внешнее хранилище материалов, загрузку по запросу, изолированные подзадачи и журнал доказательств. Рекомендации по проектированию контекста для агентов также подчёркивают ценность выборочной загрузки нужной информации вместо предварительного включения всего релевантного материала.12
Как может выглядеть «трижды прочитать»
Три прохода полезны как схема исследования, но не обязательно означают, что каждый документ надо три раза целиком скормить модели. Лучше определить, какой результат требуется от каждого этапа.
- Обзор. Система составляет каталог источников, уточняет задачу, выделяет ограничения и вопросы, которые предстоит разрешить. Недоступные или неудачно загруженные материалы отмечаются отдельно.
- Разбор по вопросам. Документы изучаются небольшими группами под конкретные исследовательские задачи. Для каждого вывода сохраняются источник, подтверждающий фрагмент, ограничения и возможные противоречия.
- Проверка ключевых выводов. Агент возвращается к первоисточникам, проверяет предположения, ищет контраргументы и уточняет, изменит ли новая информация предлагаемое решение.
Это инженерная схема, а не гарантия, что любой архив будет исчерпывающе изучен. Если материалы не удалось получить, задача упёрлась в разрешения или закончился выделенный бюджет, системе следует сообщить об этом, а не выдавать видимость завершённого исследования.
Что нужно сохранить между этапами
Долгая работа может проходить через несколько окон контекста или сессий. В таком случае полезны краткие структурированные записи: что уже проверено, на какие источники опирается вывод, что остаётся неизвестным и какой шаг следующий. В материалах Anthropic о долгих агентных задачах описан подход, при котором работа разбивается на выполнимые части, а между сессиями остаются артефакты для продолжения.7
Важно не подменять ими исходники. Вывод должен оставаться связанным с конкретным местом в документе — например, страницей, фрагментом или строкой кода. Если источник недоступен или прочитан лишь частично, это также нужно отразить. Так можно отличить установленный факт от пересказа или предположения.
Отдельная тема — память агента между сессиями. В статье Anthropic, опубликованной 6 ноября 2026 года, рассматривается, как заметки и другие представления могут формироваться из журналов работы агента.4 Такая память помогает организовать опыт и записи, но сама по себе не увеличивает окно контекста текущего запроса.
Как остановиться и всё равно выдать полезный результат
У исследования должны быть промежуточные результаты и условия остановки. Например, после первого прохода можно сообщить предварительные направления; далее — обновлять выводы по мере проверки. Если достигнут лимит времени, стоимости или числа итераций, итогом может стать отчёт с подтверждёнными выводами, разногласиями источников, непрочитанными материалами и открытыми вопросами.
Для реализации RLM-подхода AWS описывает пример с AgentCore Code Interpreter и Strands Agents SDK.
Итоговая идея проста: пусть пользователь передаёт полный набор материалов, но система должна изучать его постепенно. Хороший процесс не обещает бесконечное внимание модели — он делает доступ к источникам управляемым, ход исследования прозрачным, а частичный результат полезным.
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Люди также спрашивают
Каков краткий ответ на вопрос «Как ИИ-агенту работать с большим архивом документов»?
Передать системе весь архив можно, но это не значит, что все материалы должны одновременно попасть в один запрос к модели.
Какие ключевые моменты необходимо проверить в первую очередь?
Передать системе весь архив можно, но это не значит, что все материалы должны одновременно попасть в один запрос к модели. Recursive Language Models предлагают хранить длинный ввод вне окна контекста и разбирать его частями, при необходимости вызывая модель для отдельных фрагментов.[3]
Что мне делать дальше на практике?
Для практической системы важны не только поиск и суммаризация, но и ссылки на источники, фиксация непрочитанного и понятные промежуточные отчёты.[7][12]