Como escolher entre OpenAI, Claude, DeepSeek, Gemini e Grok no marketing de conteúdo
Não há evidência pública suficiente para cravar OpenAI, Claude, DeepSeek, Gemini ou Grok como campeão único do marketing de conteúdo; o caminho mais seguro é dividir os modelos por tipo de tarefa. Custos de API precisam separar tokens de entrada e tokens de saída: briefings longos, transcrições e pesquisas pesam no...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
Não há evidência pública suficiente para cravar OpenAI, Claude, DeepSeek, Gemini ou Grok como campeão único do marketing de conteúdo; o caminho mais seguro é dividir os modelos por tipo de tarefa.
Custos de API precisam separar tokens de entrada e tokens de saída: briefings longos, transcrições e pesquisas pesam no input; anúncios, descrições e variações em massa pesam no output.
Na escolha final, avalie proporção de textos publicáveis, tempo de edição humana, consistência de marca, erros factuais, estabilidade de formato e custo por tarefa — não só a fluidez do primeiro rascunho.
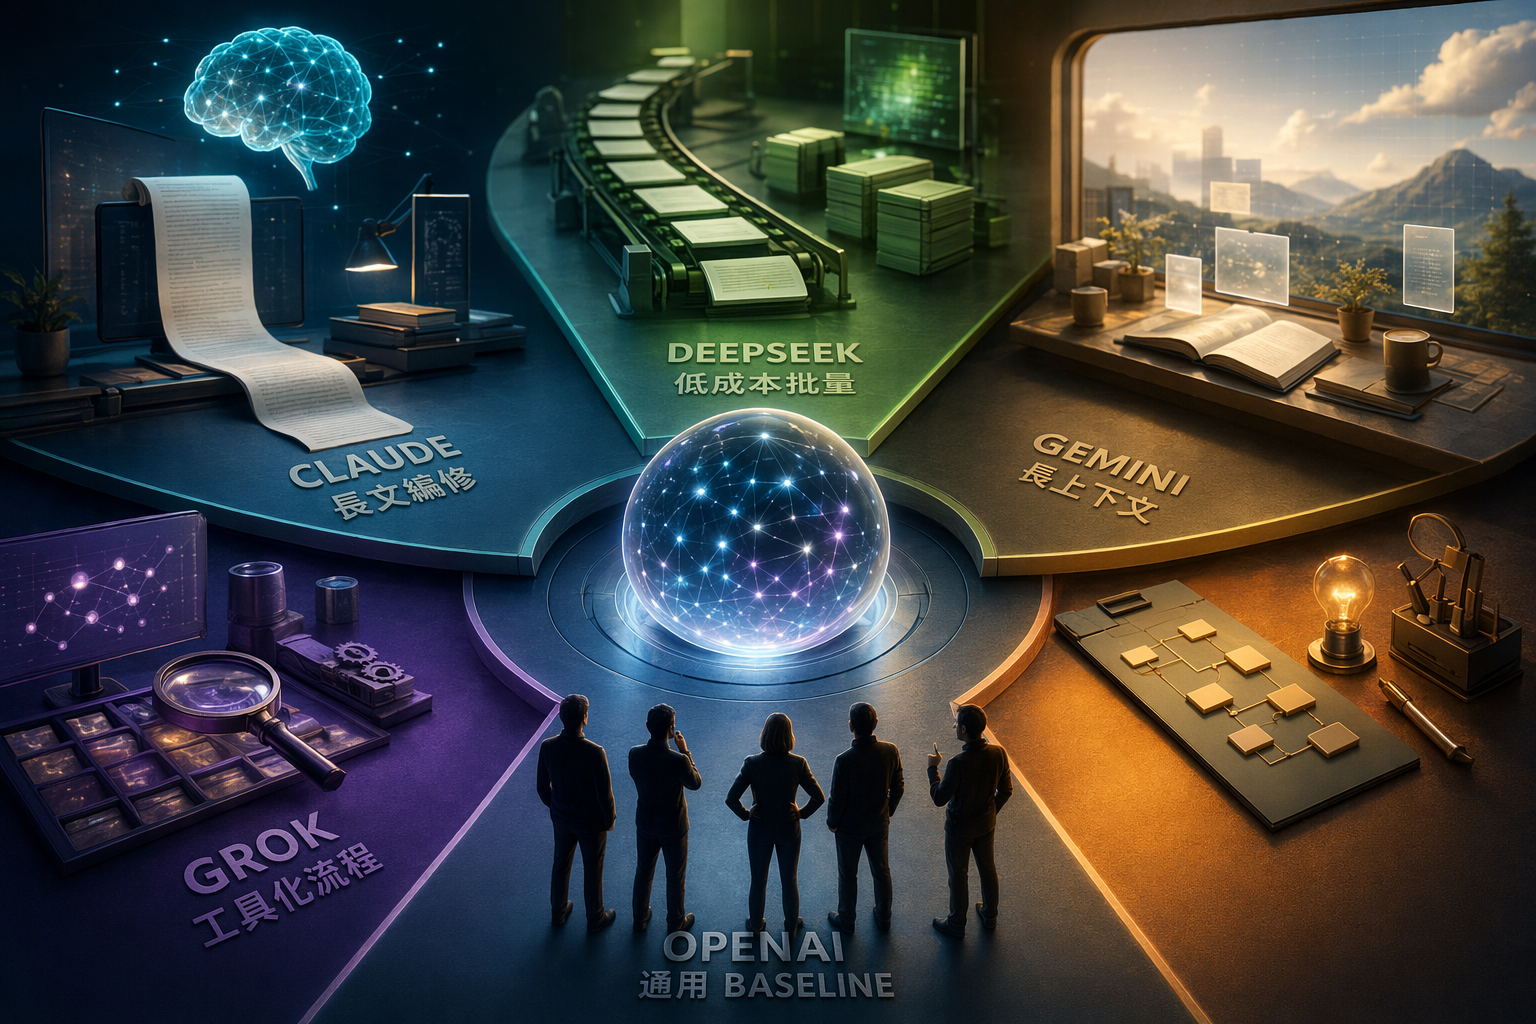
OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南AI 生成示意圖:內容團隊在研究、SEO、長文編修與自動化流程中比較不同 AI 模型。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
openai.com
Escolher IA para conteúdo e marketing fica bem mais difícil quando a decisão começa por rankings genéricos. As fontes públicas ajudam a comparar preço de API, janela de contexto, cache de prompts e ferramentas do lado do servidor, mas não provam, sozinhas, que um modelo vá melhorar SEO, conversão de anúncios ou consistência de marca em qualquer equipe.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Como escolher entre OpenAI, Claude, DeepSeek, Gemini e Grok no marketing de conteúdo"?
Não há evidência pública suficiente para cravar OpenAI, Claude, DeepSeek, Gemini ou Grok como campeão único do marketing de conteúdo; o caminho mais seguro é dividir os modelos por tipo de tarefa.
Quais são os pontos-chave para validar primeiro?
Não há evidência pública suficiente para cravar OpenAI, Claude, DeepSeek, Gemini ou Grok como campeão único do marketing de conteúdo; o caminho mais seguro é dividir os modelos por tipo de tarefa. Custos de API precisam separar tokens de entrada e tokens de saída: briefings longos, transcrições e pesquisas pesam no input; anúncios, descrições e variações em massa pesam no output.
O que devo fazer a seguir na prática?
Na escolha final, avalie proporção de textos publicáveis, tempo de edição humana, consistência de marca, erros factuais, estabilidade de formato e custo por tarefa — não só a fluidez do primeiro rascunho.
A pergunta mais produtiva, portanto, não é qual é o melhor modelo. É: qual modelo encaixa melhor em cada etapa do seu fluxo de trabalho?
A resposta curta: não escolha um campeão, monte uma divisão de tarefas
Necessidade do time
Teste primeiro
Por que faz sentido
Ponto de atenção
Pesquisa geral, briefing de conteúdo, planejamento, primeiro rascunho e versão final
OpenAI
Tabelas de terceiros listam vários níveis de modelos OpenAI, com diferenças de preço para entrada e saída, além de opções de contexto; a TLDL descreve a família GPT-4.1 com contexto de 1M de tokens e preço intermediário.
Bom como baseline, mas isso não significa liderança em toda tarefa de conteúdo.
Edição de textos longos, tom de marca e regras editoriais fixas
Claude
A documentação oficial da Anthropic separa Base Input Tokens, Cache Writes, Cache Hits e Output Tokens, o que ajuda a planejar custos quando guias de marca, modelos e critérios de revisão são reutilizados.
Meça taxa de texto publicável, tempo de edição humana e consistência de marca — não apenas se a primeira versão parece bonita.
Rascunhos SEO em volume, descrições de produto e variações de anúncios
DeepSeek
A DeepSeek tem documentação oficial de Models & Pricing; um guia da DecodesFuture descreve preço unificado de chat e raciocínio em cerca de US$ 0,28 por milhão de tokens de entrada e US$ 0,42 por milhão de tokens de saída, com redução de 94–96% em relação a OpenAI o3 ou GPT-4.1.
Custo baixo é ótimo para volume, mas não substitui checagem factual e revisão de marca.
Briefings enormes, materiais de concorrentes, transcrições e pacotes de palavras-chave
Gemini
A MorphLLM lista o Gemini 2.5 Flash com contexto de 1M, US$ 2,50 por milhão de tokens de saída e camada gratuita; a TLDL coloca o Gemini 2.5 Pro entre os modelos com contexto de 2M de tokens.
As especificações de Gemini citadas aqui vêm principalmente de comparações de terceiros; confirme no fornecedor antes de fechar orçamento.
Chamadas de ferramentas, automações e pipelines de conteúdo
Grok
A documentação oficial da xAI traz Models and Pricing e separa Tools Pricing para server-side tools; a TLDL também afirma que a xAI tem dois modelos com contexto de 2M de tokens.
Vale testar em fluxos com ferramentas e dados conectados; as fontes aqui não bastam para dizer que ele vence em copywriting geral.
Primeiro, entenda a conta: input-heavy e output-heavy são trabalhos diferentes
APIs de geração de texto costumam cobrar por uso de tokens. Cada fornecedor define preços por milhão de tokens, e a conta separa o que você envia ao modelo — tokens de entrada, ou input — do que o modelo devolve — tokens de saída, ou output.
Para marketing de conteúdo, isso muda tudo:
Tarefas input-heavy: análise de páginas de concorrentes, resumo de entrevistas, transcrições de calls de vendas, pacotes de palavras-chave, documentação de produto e briefings longos. O custo tende a crescer conforme você coloca mais material de contexto na chamada.
Tarefas output-heavy: títulos de anúncios, descrições de produto, FAQ, posts sociais, reescritas multilíngues e variações de copy para A/B test. Aqui, a atenção deve ir para o preço dos tokens de saída e para o custo total de gerar muitas versões.
Se o seu time sempre inclui guia de voz da marca, restrições jurídicas, templates de SEO ou regras de formatação, também vale olhar para cache de prompts. A documentação de preços do Claude separa Cache Writes e Cache Hits, sinal de que contexto repetido pode entrar na estratégia de custo — não é só uma escolha de prompt.
OpenAI: o ponto de partida para comparar o resto
A OpenAI funciona bem como baseline de avaliação. Não porque as fontes públicas provem que ela é a melhor em todo cenário de conteúdo, mas porque tabelas de terceiros mostram vários níveis de modelos OpenAI, o que permite separar tarefas: modelos mais fortes para estratégia, síntese de pesquisa e versão final; opções mais baratas para resumo, reescrita e variações em lote.
A TLDL descreve a família GPT-4.1 como uma opção com contexto de 1M de tokens e preço intermediário, o que a torna candidata natural para testes com briefings longos, resumos de pesquisa e integração de planejamento. Ainda assim, há uma ressalva importante: os dados de preço e contexto da OpenAI citados aqui vêm principalmente de agregadores de terceiros, não de uma documentação oficial diretamente citada neste conjunto de fontes.
Na prática, comece testando OpenAI em tarefas como estrutura de página-pilar de SEO, mensagens de campanha, síntese de pesquisa, rascunho longo, variações de título, e-mail marketing e reaproveitamento de posts. Registre qualidade e custo separadamente, porque modelos do mesmo fornecedor podem ter janelas de contexto e preços por milhão de tokens bem diferentes.
Claude: forte candidato para textos longos, revisão e tom de marca
O ponto mais interessante do Claude para equipes de conteúdo é o encaixe em fluxos editoriais repetíveis. A documentação oficial da Anthropic lista Base Input Tokens, Cache Writes, Cache Hits e Output Tokens, o que facilita planejar o uso recorrente de guias de tom, critérios de edição, restrições legais e templates de artigo.
Por isso, é melhor não reduzir Claude à ideia de modelo que escreve bem. O teste mais justo é colocá-lo em tarefas como reescrita de textos longos, resumo de white papers, padronização de voz de marca, checagem de regras editoriais e melhoria de estrutura. A métrica final deve ser operacional: quanto do texto sai publicável, quanto tempo a edição humana economiza e quantos problemas factuais ou de tom ainda aparecem.
DeepSeek: volume barato para rascunhos e variações
O grande atrativo do DeepSeek é custo. A DeepSeek disponibiliza documentação oficial de Models & Pricing; além disso, o guia da DecodesFuture para 2026 descreve preço unificado de chat e raciocínio em cerca de US$ 0,28 por milhão de tokens de entrada e US$ 0,42 por milhão de tokens de saída, com redução de 94–96% em comparação com OpenAI o3 ou GPT-4.1.
Isso coloca o DeepSeek em uma posição interessante para a frente de produção: rascunhos de SEO de cauda longa, descrições de produto, perguntas frequentes, variações de anúncios, primeira versão de localização multilíngue e posts sociais. O cuidado é não confundir baixo custo com conteúdo pronto para publicar. Quanto maior o volume, mais importante fica ter checklist de fatos, revisão de marca e validação de formato.
Gemini: bom candidato quando o problema é contexto longo
A principal razão para testar Gemini é a janela de contexto. A MorphLLM lista o Gemini 2.5 Flash com contexto de 1M, preço de US$ 2,50 por milhão de tokens de saída e camada gratuita; a TLDL coloca o Gemini 2.5 Pro entre os modelos de maior faixa, com contexto de 2M de tokens.
Para times de marketing, contexto longo é útil quando o trabalho começa com muito material: páginas de concorrentes, transcrições de entrevistas, documentos de produto, pacotes de palavras-chave, conversas com clientes e biblioteca de conteúdo existente. Em muitos projetos, o gargalo não é fazer o modelo escrever, mas fazer o modelo entender o cenário antes de escrever.
Aqui, a ressalva também importa: as especificações de Gemini usadas nesta análise vêm principalmente de comparações de terceiros. Antes de decidir fornecedor, valide limites, preços e disponibilidade na documentação ou contrato que você de fato usará.
Grok: teste com automação, ferramentas e dados conectados
O Grok, da xAI, não deve ser avaliado apenas por uma chamada isolada para escrever um anúncio. A documentação oficial da xAI apresenta Models and Pricing e separa Tools Pricing para server-side tools, o que é relevante para equipes que querem conectar modelo, ferramentas, fontes de dados e automações de conteúdo.
A TLDL também afirma que a xAI oferece dois modelos com contexto de 2M de tokens e diferencia Grok 4 de Grok 4.1 Fast por posicionamento. Com as fontes disponíveis aqui, porém, não dá para afirmar que Grok já supera OpenAI ou Claude de forma estável em copywriting geral. A melhor leitura é mais específica: se o seu fluxo depende de chamada de ferramentas, dados conectados ou uma esteira automatizada, coloque Grok na lista de testes.
Como testar sem cair na armadilha do texto bonito
Preço e especificação reduzem a lista de candidatos, mas não escolhem o modelo por você. Monte um teste pequeno, usando o mesmo material de marca, as mesmas restrições e os mesmos critérios para todos os modelos.
Um roteiro simples:
Briefing de SEO: entregue palavra-chave, intenção de busca, resumo de concorrentes e dados do produto. Peça estrutura, pontos por seção e itens que precisam de checagem.
Revisão de texto longo: entregue um rascunho e um guia de tom. Peça reescrita sem mudar fatos e solicite os principais motivos das alterações.
Variações de anúncio: gere headlines, texto principal e chamada para ação, ou CTA. Verifique se respeitam marca e limitações da plataforma.
Reaproveitamento de conteúdo: transforme um artigo em posts para LinkedIn, X, Threads, newsletter e roteiro curto de vídeo.
Checagem de incerteza: peça que o modelo marque frases que precisam de verificação, em vez de completar lacunas com confiança excessiva.
Na pontuação, não olhe só qual texto flui melhor. Registre taxa de versões publicáveis, tempo de edição, consistência com a marca, erros factuais, estabilidade de formato, custo por tarefa e custo em escala. Como a cobrança de API muda conforme tokens de entrada e de saída, tarefas com muito contexto e tarefas de geração em massa devem ser estimadas separadamente.
Um ponto de partida prático
Se você precisa começar rápido, use esta matriz: OpenAI como baseline geral; Claude para texto longo e edição de marca; DeepSeek para volume de baixo custo; Gemini para contexto muito longo; Grok para fluxos com ferramentas e automação.
Isso não é um ranking absoluto de inteligência. É uma forma de testar com menos achismo. O melhor modelo para o seu time vai depender do idioma, do mercado, das regras de marca, do processo de aprovação e dos KPIs de conteúdo que realmente importam.
platform.claude.comPricing - Claude API Docs
pecollective.comCross-Provider LLM API Pricing Comparison (April 2026)
tldl.ioLLM API Pricing 2026 — Compare GPT-5, Claude 4, Gemini 2.5 ...
docs.x.aiModels and Pricing - xAI Docs
aipricingcomparison.comCompare OpenAI & Top LLM API Pricing Instantly - AI Pricing Comparison