Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro ou Grok 4: como escolher sem cair no ranking fácil
Para programação complexa e fluxos com agentes, Claude Opus 4.7 deve entrar na primeira rodada de testes: a Anthropic afirma que ele melhora de 10% a 15% a taxa de sucesso no Factory Droids em relação ao Opus 4.6, com... GPT 5.4 aparece como candidato forte para raciocínio estruturado e computer use; Gemini 3.1 Pro...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
Para programação complexa e fluxos com agentes, Claude Opus 4.7 deve entrar na primeira rodada de testes: a Anthropic afirma que ele melhora de 10% a 15% a taxa de sucesso no Factory Droids em relação ao Opus 4.6, com...
GPT 5.4 aparece como candidato forte para raciocínio estruturado e computer use; Gemini 3.1 Pro se destaca em entradas multimodais, raciocínio abstrato e benchmarks científicos; Grok 4 chama atenção no indicador HLE d...
Antes de comprar, padronizar ou colocar em produção, compare 3 a 5 modelos com tarefas reais do seu time.
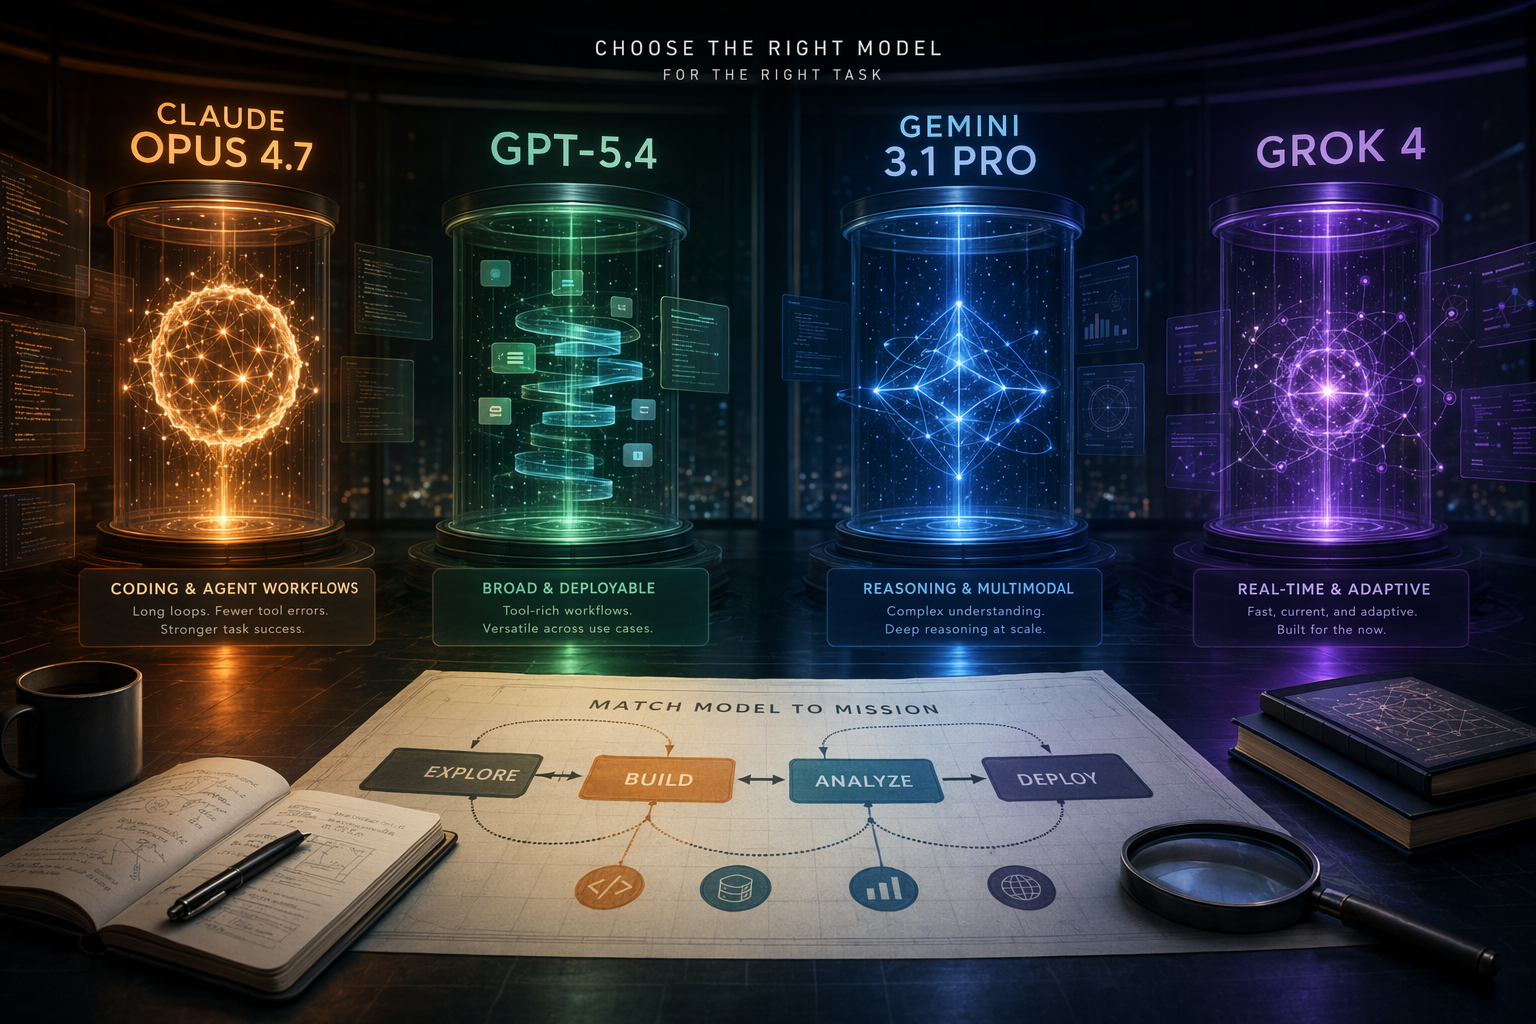
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
Comparar Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro e Grok 4 como se houvesse um único campeão absoluto é tentador — mas pouco útil. A pergunta mais importante é: em que tipo de tarefa o seu fluxo de trabalho mais costuma quebrar? Um guia independente de seleção de LLMs resume bem o cenário: nenhum modelo domina todas as tarefas; cada um tende a ter pontos fortes diferentes em programação, raciocínio estruturado, multimodalidade, benchmarks científicos ou raciocínio de alta dificuldade.
Escolha rápida por tipo de tarefa
Se a sua prioridade é...
Comece testando por...
O que as evidências dizem
Cuidado principal
Programação complexa, agentes, uso estável de ferramentas
Claude Opus 4.7
A Anthropic afirma que o Opus 4.7 supera o Opus 4.6 com ganho de 10% a 15% em sucesso de tarefa no Factory Droids, menos erros de ferramentas e mais confiabilidade; a Axios também o descreve como uma atualização relevante do modelo de ponta da Anthropic, com melhor coding e visão mais apurada.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro ou Grok 4: como escolher sem cair no ranking fácil"?
Para programação complexa e fluxos com agentes, Claude Opus 4.7 deve entrar na primeira rodada de testes: a Anthropic afirma que ele melhora de 10% a 15% a taxa de sucesso no Factory Droids em relação ao Opus 4.6, com...
Quais são os pontos-chave para validar primeiro?
Para programação complexa e fluxos com agentes, Claude Opus 4.7 deve entrar na primeira rodada de testes: a Anthropic afirma que ele melhora de 10% a 15% a taxa de sucesso no Factory Droids em relação ao Opus 4.6, com... GPT 5.4 aparece como candidato forte para raciocínio estruturado e computer use; Gemini 3.1 Pro se destaca em entradas multimodais, raciocínio abstrato e benchmarks científicos; Grok 4 chama atenção no indicador HLE d...
O que devo fazer a seguir na prática?
Antes de comprar, padronizar ou colocar em produção, compare 3 a 5 modelos com tarefas reais do seu time.
A evidência mais direta compara Opus 4.7 com Opus 4.6, não os quatro modelos em um teste simultâneo e idêntico.
Processos rígidos, raciocínio estruturado, computer use
GPT-5.4
Um guia de seleção aponta o GPT-5.4 como forte em structured reasoning e computer use, citando 75% no OSWorld.
Ainda é preciso testar com seus prompts, ferramentas e critérios de erro.
Imagens, gráficos, capturas de tela, documentos visuais, perguntas científicas
Gemini 3.1 Pro
O mesmo guia coloca o Gemini 3.1 Pro à frente em raciocínio abstrato, entrada multimodal e benchmarks científicos, citando GPQA de 94,3%.
Ser forte em multimodalidade e ciência não garante vitória automática em agentes de código ou fluxos longos com ferramentas.
Raciocínio de alta dificuldade em benchmark
Grok 4
O guia diz que o Grok 4 lidera no indicador HLE, com 50,7%.
Um indicador de raciocínio difícil não deve ser extrapolado como superioridade geral em produto, código, conteúdo ou operações.
Diversificação de fornecedores ou alternativas abertas
MiniMax, GLM, Kimi e outros
O guia afirma que MiniMax M2.5/M2.7, GLM-5/5.1 e Kimi K2.5 já se aproximam de modelos proprietários de fronteira em tarefas do tipo SWE-bench.
Aproximar-se em SWE-bench não significa empatar em estabilidade de API, multimodalidade, segurança, escrita ou integração com produto.
Claude Opus 4.7: o caso mais forte está em código e agentes
O principal sinal público sobre o Claude Opus 4.7 não é uma vitória universal contra todos os rivais. É uma melhora oficial em relação à geração anterior. A Anthropic afirma que o Claude Opus 4.7 supera o Opus 4.6 com aumento de 10% a 15% no sucesso de tarefas do Factory Droids, além de menos erros de ferramentas e desempenho mais confiável.
Isso importa especialmente para times de engenharia e produtos que usam IA como agente — por exemplo, para modificar arquivos, chamar ferramentas, seguir uma sequência de etapas ou manter contexto ao longo de uma tarefa. Nesses casos, o problema raramente é só uma resposta errada. Muitas vezes é uma chamada de ferramenta mal feita, uma alteração no arquivo incorreto, perda de contexto ou retrabalho humano em cascata.
A Axios também descreveu o Opus 4.7 como uma atualização significativa do modelo flagship da Anthropic, com avanços em coding e visão. A leitura mais prudente, porém, é esta: há evidência clara de melhora do Opus 4.7 sobre o Opus 4.6; não há, nos dados citados aqui, uma prova definitiva de que ele vença GPT-5.4, Gemini 3.1 Pro e Grok 4 em todos os cenários.
GPT-5.4: priorize quando o fluxo exige disciplina operacional
Se sua tarefa parece mais uma sequência rígida de passos — preencher estruturas, seguir regras, operar ferramentas, tomar decisões condicionais ou interagir com ambientes de computador — o GPT-5.4 deve entrar na comparação desde o início. O guia independente citado afirma que o GPT-5.4 se destaca em raciocínio estruturado e computer use, com 75% no OSWorld.
Isso não significa que ele seja automaticamente melhor que o Claude Opus 4.7 para qualquer coisa. Significa que, quando o maior risco do seu projeto está em controle de processo, execução passo a passo e operação de ferramentas, faz sentido colocar GPT-5.4 e Opus 4.7 lado a lado no mesmo teste.
Gemini 3.1 Pro: leve muito a sério quando há imagem, ciência ou multimodalidade
Se o seu trabalho envolve imagens, gráficos, capturas de tela, documentos visualmente complexos, perguntas científicas ou pesquisa assistida, o Gemini 3.1 Pro merece prioridade. Segundo o guia de seleção, ele aparece à frente em raciocínio abstrato, entrada multimodal e benchmarks científicos, com GPQA de 94,3%.
Aqui, o ponto não é escolher por marca. É escolher pelo formato da tarefa. Se a sua entrada real mistura texto com elementos visuais ou conteúdo técnico-científico, usar apenas benchmarks de programação para tomar a decisão pode esconder justamente a área em que o Gemini 3.1 Pro tende a ser mais competitivo.
Grok 4: bom sinal em raciocínio difícil, mas não extrapole demais
O Grok 4 tem um destaque claro nos dados disponíveis: o guia afirma que ele lidera o indicador HLE, com 50,7%. Para quem acompanha benchmarks de raciocínio de alta dificuldade, isso é relevante.
Mas um bom resultado em HLE não deve ser lido como resposta final para todas as decisões de adoção. Um modelo pode ir bem em um benchmark desafiador e ainda assim não ser o melhor para seu ambiente de desenvolvimento, para o seu produto, para a sua interface ou para o seu custo por iteração. Um artigo de ranking de LLMs faz esse alerta de forma direta: benchmarks ajudam, mas a experiência diária de construção também é dominada por confiabilidade, capacidade da interface e custo.
Por que não basta seguir o ranking da semana?
Há três armadilhas comuns.
Primeiro, rankings frequentemente misturam benchmarks, metodologias e datas diferentes. A comparação de modelos de coding da Failing Fast, por exemplo, informa fontes como SWE-bench de fevereiro de 2026, Aider de outubro de 2025 e Arena Code de fevereiro de 2026. Esse tipo de tabela é útil para orientar a investigação, mas não deve ser lido como se todos os modelos tivessem sido avaliados no mesmo dia, com o mesmo conjunto de tarefas e as mesmas condições.
Segundo, uma comparação oficial dentro de uma mesma família de modelos não é a mesma coisa que um teste independente entre fornecedores. A página da Anthropic sustenta bem a melhora do Opus 4.7 em relação ao Opus 4.6; já o guia de seleção ajuda a mapear pontos fortes entre fornecedores, mas não é uma avaliação oficial conjunta de OpenAI, Google, xAI e Anthropic.
Terceiro, a vida real cobra coisas que o benchmark nem sempre captura. Confiabilidade, interface, latência percebida, custo por tentativa, facilidade de integração e tempo de revisão humana podem pesar tanto quanto a pontuação em um teste público.
Checklist antes de colocar em produção
Para decisão de compra, padronização de equipe ou adoção em produto, evite a pergunta “qual é o modelo mais forte?”. Use uma bateria pequena e realista:
Escolha de 5 a 10 tarefas que realmente aparecem no dia a dia: corrigir bug, criar feature, refatorar código, ler documento longo, analisar imagem, gerar especificação ou chamar ferramentas.
Use o mesmo prompt, os mesmos arquivos de contexto e o mesmo critério de sucesso em todos os modelos.
Meça taxa de acerto na primeira tentativa, número de retrabalhos, erros de ferramenta, alucinações, latência, custo e tempo de correção humana.
Avalie não só a melhor resposta, mas também a pior. Em produção, o modo de falha costuma importar mais do que a demonstração bonita.
Se houver dados sensíveis, requisitos de privacidade ou obrigações de compliance, verifique retenção de dados, controles empresariais, opções de implantação e políticas do fornecedor.
Veredito prático
Claude Opus 4.7 deve ser um dos primeiros candidatos para programação, fluxos com agentes e uso confiável de ferramentas. A Anthropic afirma que ele melhora de forma mensurável sobre o Opus 4.6 no Factory Droids, com menos erros de ferramentas; a Axios também o apresenta como uma atualização de destaque em coding e visão.
Mas a resposta honesta para “qual é o melhor modelo?” continua sendo: depende da tarefa. As evidências disponíveis apontam mais para especialização do que para um vencedor universal. GPT-5.4 merece atenção em raciocínio estruturado e computer use; Gemini 3.1 Pro, em multimodalidade e tarefas científicas; Grok 4, em benchmarks de raciocínio difícil; e modelos como MiniMax, GLM e Kimi também entram na conversa quando a comparação envolve SWE-bench e alternativas ao bloco proprietário tradicional.
A escolha mais segura é tratar o Claude Opus 4.7 como candidato de primeira linha para código e agentes — e testá-lo, no seu próprio fluxo, contra GPT-5.4, Gemini 3.1 Pro e Grok 4 antes de padronizar.
iternal.aiThe Definitive LLM Selection & Benchmarks Guide
anthropic.comClaude Opus 4.7 - Anthropic
axios.comAnthropic releases Claude Opus 4.7, concedes it trails ... - Axios
adam.holter.comAI Labs LLM Rankings 2026: Claude vs GPT-5 vs Gemini 3 vs Grok
failingfast.ioAI coding model comparison - Failing Fast