Tesla P40 24GB usada: o upgrade barato para IA local em servidor antigo
Se o servidor antigo tiver PCIe, espaço, fonte e fluxo de ar, uma Tesla P40 24GB usada costuma ser o upgrade local mais barato para IA, com guias recentes citando faixas de US$ 150–250 ou abaixo de US$ 300 [2][5][9]. O preço só fecha a conta se você resolver refrigeração e energia; para menos dor de cabeça, a RTX 30...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
Se o servidor antigo tiver PCIe, espaço, fonte e fluxo de ar, uma Tesla P40 24GB usada costuma ser o upgrade local mais barato para IA, com guias recentes citando faixas de US$ 150–250 ou abaixo de US$ 300 [2][5][9].
O preço só fecha a conta se você resolver refrigeração e energia; para menos dor de cabeça, a RTX 3090 24GB usada é mais cara, mas mais rápida [5][9].
Cheapest Local AI GPU Upgrade for an Old Server: Used Tesla P40 24GBA budget local-AI server build is a VRAM-first project: the used Tesla P40 24GB is cheap, but cooling and power determine whether it is practical.
Prompt de IA
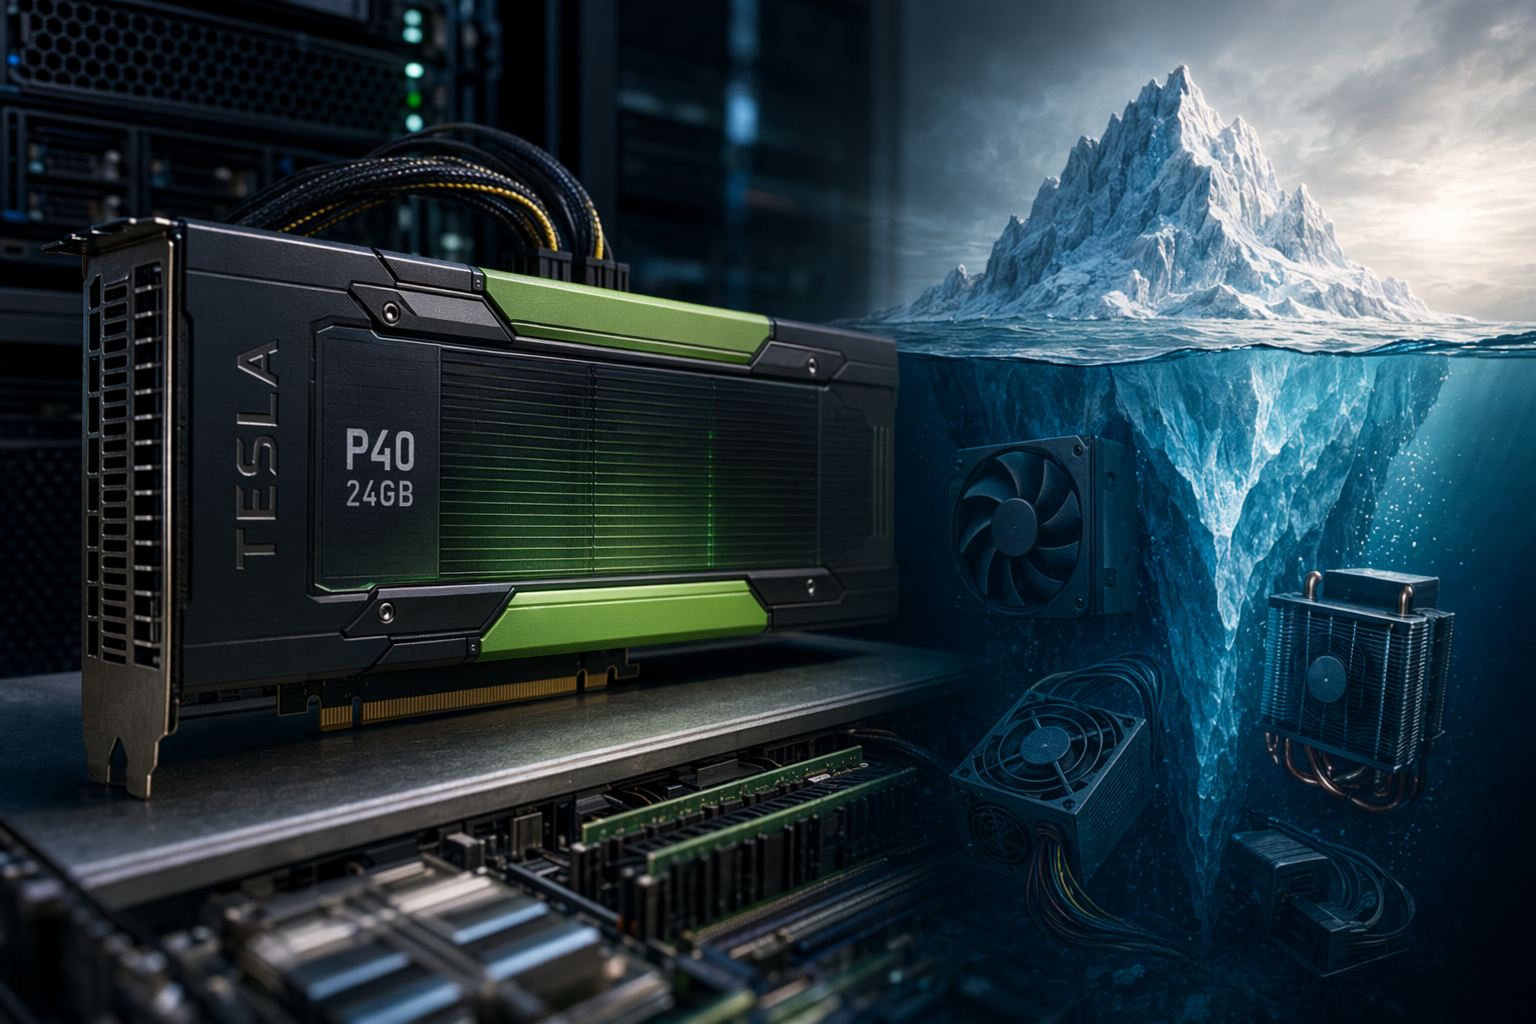
Create a landscape editorial hero image for this Studio Global article: Cheapest Local AI GPU Upgrade for an Old Server: Used Tesla P40 24GB. Article summary: The cheapest viable upgrade is usually a used NVIDIA Tesla P40 24GB: recent sources place it around $150–$200 or under $200 to sub $300, but it is a 2016 era data center inference card that needs serious directed cool.... Topic tags: local ai, llm, gpu, homelab, nvidia. Reference image context from search candidates: Reference image 1: visual subject "A high-impact cinematic close-up of a Tesla P40 GPU integrated into a modern AI workstation, glowing with neural network energy" source context "Tesla P40 for Local LLMs (2026): 24GB VRAM for $200?" Reference image 2: visual subject "A minimalist iceberg sketch illustrating the hidden costs of running a Tesla P40, including power consumption and DIY cooling" source context "Tesla P40
openai.com
Se você já tem um servidor de rack aposentado ou uma workstation antiga, o upgrade mais barato para IA local raramente é trocar tudo. Na prática, costuma valer mais comprar VRAM — a memória da GPU — do que montar uma plataforma nova do zero. Guias recentes sobre LLMs locais apontam repetidamente a NVIDIA Tesla P40 24GB usada como a opção de 24 GB mais barata, com faixas relatadas em torno de US$ 150–200, US$ 200–250, abaixo de US$ 200 ou abaixo de US$ 300, conforme a fonte e o estado do anúncio .
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Tesla P40 24GB usada: o upgrade barato para IA local em servidor antigo"?
Se o servidor antigo tiver PCIe, espaço, fonte e fluxo de ar, uma Tesla P40 24GB usada costuma ser o upgrade local mais barato para IA, com guias recentes citando faixas de US$ 150–250 ou abaixo de US$ 300 [2][5][9].
Quais são os pontos-chave para validar primeiro?
Se o servidor antigo tiver PCIe, espaço, fonte e fluxo de ar, uma Tesla P40 24GB usada costuma ser o upgrade local mais barato para IA, com guias recentes citando faixas de US$ 150–250 ou abaixo de US$ 300 [2][5][9]. O preço só fecha a conta se você resolver refrigeração e energia; para menos dor de cabeça, a RTX 3090 24GB usada é mais cara, mas mais rápida [5][9].
Esse preço é o grande atrativo. A ressalva: a P40 é hardware antigo de data center, pensado para inferência, não uma GPU de desktop moderna para instalar e esquecer .
Veredito rápido
Caminho mais barato e viável: se o servidor antigo tiver slot PCIe utilizável, folga na fonte e espaço físico, uma Tesla P40 24GB usada com refrigeração de ar forçado é a aposta de menor custo. O que faz a placa chamar atenção são os 24 GB de VRAM por preços baixos; o que costuma complicar é a refrigeração .
Melhor se o orçamento permitir: uma RTX 3090 24GB usada custa mais, mas um guia de GPUs usadas de 2026 a lista por cerca de US$ 700–850 e a posiciona como opção mais forte para IA local do que a P40 .
Fora da ideia de upgrade barato: placas A100 jogam a conversa para milhares de dólares; preços usados da A100 80GB aparecem como US$ 4.000–9.000 na JarvisLabs e US$ 4.000–8.000 na CraftRigs .
Por que a P40 funciona: em LLM local, 24 GB contam muito
Para inferência de LLM local, a pergunta prática é: o modelo cabe inteiro na memória da GPU? A InsiderLLM afirma que os 24 GB de VRAM da P40 permitem rodar alguns modelos 14B totalmente na GPU quando eles não caberiam em uma RTX 3060 de 12 GB . Outro guia de GPUs usadas para 2026 reforça a mesma lógica: em cargas de IA, placas usadas com mais VRAM podem ser preferíveis a modelos mais novos com menos memória .
A P40, porém, não é uma placa nova. A Vast.ai lista a Tesla P40 com data de lançamento em 13 de setembro de 2016 e 24 GB de memória . A Accio a descreve como uma GPU de data center da era Pascal, originalmente voltada a inferência e virtualização, que ganhou uma segunda vida entre quem monta IA local pelo volume de memória a baixo custo . A InsiderLLM também a classifica como lenta para padrões atuais e cerca de três vezes mais lenta que uma RTX 3090 em sua comparação .
A conta escondida: refrigeração, energia e encaixe
O valor da P40 pode enganar se o servidor não estiver pronto para ela. Antes de comprar, confirme:
Slot e espaço físico. Veja se há um PCIe x16 livre ou um riser compatível, além de comprimento e folga para fluxo de ar. Em servidores antigos, o layout dos risers pode decidir se a instalação é viável.
Fonte e cabos. A InsiderLLM lista a Tesla P40 com TDP de 250 W, então a fonte precisa ter margem suficiente sob carga .
Fluxo de ar direcionado. A Accio destaca desafios de refrigeração no uso da P40 com LLM local . Na prática, isso costuma exigir soprador, duto, carenagem para ventoinha ou um chassi de servidor que empurre ar diretamente através da placa.
Como você vai acessar vídeo. Não trate a P40 como uma GPU gamer: um guia de GPUs usadas de 2026 lista a Tesla P40 24GB sem saída de vídeo . Use vídeo integrado da placa-mãe, uma GPU simples separada ou acesso remoto.
Software e modelos: pense em inferência local
O uso certo é como caixa de inferência, não como estação para treinar modelos gigantes. A Accio relaciona a segunda vida da P40 à execução local de LLMs e menciona o llama.cpp em cenários de homelab com a P40 . Comece por modelos e quantizações que caibam nos 24 GB, depois ajuste contexto, batch e configuração do servidor em vez de presumir que qualquer lançamento novo vai rodar bem.
Essa expectativa faz diferença. Um relato da RBA diz que a P40 não roda os maiores modelos de ponta e tem limitações arquiteturais, mas ainda pode ser capaz com a configuração correta .
Desempenho: útil, não topo de linha
Se você espera uma placa silenciosa de desktop capaz de rodar confortavelmente todo modelo novo, a P40 vai frustrar. A InsiderLLM a chama de lenta para padrões modernos e aproximadamente três vezes mais lenta que uma RTX 3090 .
Por outro lado, builds reais ajudam a explicar por que ela segue atraente. A RBA relatou um servidor de orçamento rodando Qwen3 Coder 30B a cerca de 50 tokens por segundo em uma P40 usada . Trate isso como experiência pontual, não como benchmark universal: throughput depende do modelo, da quantização, do contexto, da configuração do sistema e da refrigeração.
Tesla P40 vs RTX 3090 vs A100
A melhor placa depende do que você quer economizar: dinheiro inicial, trabalho de montagem ou limite de tamanho dos modelos.
Opção
Quando faz sentido
Preço e capacidade reportados
Principal troca
Tesla P40 24GB usada
Menor custo para chegar a 24 GB de VRAM em inferência local
Fontes citam US$ 150–200, US$ 200–250, abaixo de US$ 200 ou abaixo de US$ 300 no mercado de usados
Placa antiga de data center, sem saída de vídeo, TDP de 250 W e desafios de refrigeração
RTX 3090 24GB usada
Melhor velocidade e instalação mais parecida com PC de mesa
Guia de 2026 lista preço usado em torno de US$ 700–850
Custa muito mais que uma P40; a P40 é descrita como cerca de três vezes mais lenta
A100 40GB ou 80GB
Trabalho com modelos maiores quando o orçamento é sério
A100 existe em versões de 40 GB e 80 GB, e preços usados da A100 80GB aparecem na casa dos milhares de dólares
Roteiro barato recomendado
Se a meta é inferência local capaz pelo menor custo possível, siga esta ordem:
Confirme que o servidor tem slot PCIe ou riser utilizável, espaço físico e capacidade de fonte suficientes.
Orce a refrigeração antes da placa; desafios térmicos são um alerta recorrente para a P40 .
Só compre a Tesla P40 24GB usada se o custo total ainda fizer sentido depois de ventoinhas, dutos, cabos e eventuais adaptadores.
Planeje acesso de vídeo fora da P40, já que a placa é listada sem saída de vídeo .
Instale uma pilha de inferência local e comece por modelos que caibam nos 24 GB; o llama.cpp é uma das ferramentas citadas em coberturas sobre uso local da P40 .
Se o projeto ficar barulhento, quente ou improvisado demais, compare o custo total com uma RTX 3090 24GB usada antes de insistir .
Em resumo
Para gastar o mínimo, a Tesla P40 24GB usada é o destaque para ressuscitar um servidor antigo: entrega muita VRAM por faixas que guias recentes colocam perto de US$ 150–250 ou abaixo de US$ 300 . Mas a fórmula vencedora não é só comprar a placa. É placa, fonte suficiente, fluxo de ar direcionado e expectativa realista.
Se você quer os mesmos 24 GB com menos dor de cabeça, considere uma RTX 3090 24GB usada . Se precisa de memória de classe A100, pare de pensar em upgrade barato e planeje um orçamento bem maior .
accio.comNvidia P40: Best Budget 24GB GPU in 2026?
craftrigs.comUsed Server GPUs for Local LLMs: A100, H100, P40 [2026] | CraftRigs
insiderllm.comUsed Tesla P40 for Local AI: The $200 Budget Beast | InsiderLLM
jarvislabs.aiNVIDIA A100 GPU Price in 2026: Cost Per Hour, Cloud ...