RespostasPublicado24 fontes
O escaneamento destrutivo que transformou livros em dados para a IA
A Anthropic iniciou o Project Panama no começo de 2024 e gastou dezenas de milhões de dólares para comprar, digitalizar e destruir milhões de livros físicos usados no treinamento do Claude. O processo, conhecido como “escaneamento destrutivo”, envolve comprar títulos — inclusive raros e fora de catálogo — por meio d...
Publicado porEditado com DeepSeek-V4-FlashImagens geradas com GPT Image 1.5
Resposta de pesquisa
Principais conclusões
- A Anthropic iniciou o Project Panama no começo de 2024 e gastou dezenas de milhões de dólares para comprar, digitalizar e destruir milhões de livros físicos usados no treinamento do Claude.
- O processo, conhecido como “escaneamento destrutivo”, envolve comprar títulos — inclusive raros e fora de catálogo — por meio de intermediários, cortar suas lombadas, escanear as páginas e triturar o que resta.
- A Justiça dos Estados Unidos considerou legal o treinamento com livros adquiridos legalmente, mas rejeitou o uso de cópias pirateadas; o caso terminou com um acordo coletivo de US$ 1,5 bilhão em julho de 2026.
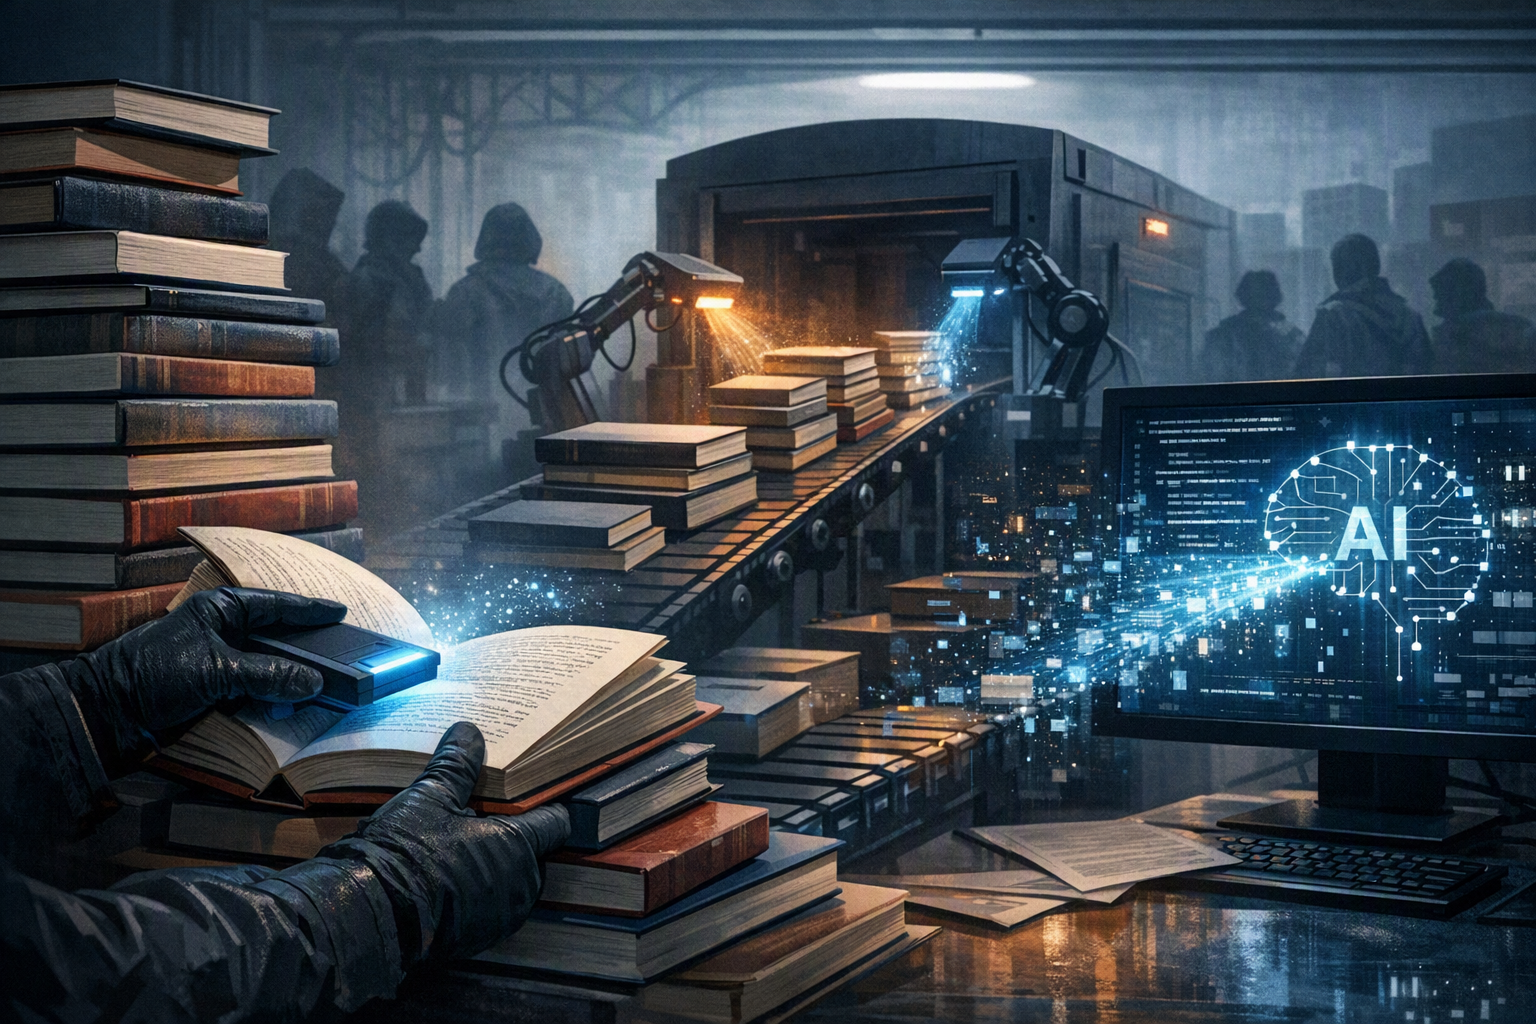
Prompt de IA
openai.comCreate a landscape editorial hero image for this Studio Global article: What are the key details about AI companies' practice of "destructive scanning"—secretly purchasing millions of physical books through anony. Article summary: I'll research each of these claims. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, icons, and tiny thumbnail layouts. Make it useful as an illustrative visual, not as factual evidence.
Na corrida para criar modelos de inteligência artificial cada vez mais capazes, algumas empresas passaram a buscar uma fonte de dados tão tradicional quanto controversa: livros impressos. Em vez de preservá-los, operações em escala industrial compram os volumes, cortam suas lombadas com máquinas hidráulicas, escaneiam as páginas e trituram os exemplares restantes.
A prática ficou conhecida como escaneamento destrutivo (destructive scanning) e veio à tona por meio de documentos judiciais tornados públicos e de reportagens investigativas em 2026. O caso mais detalhado envolve a Anthropic, empresa responsável pelo chatbot Claude, e uma operação sigilosa chamada Project Panama.
O que é o escaneamento destrutivo?
O processo começa com a compra de grandes lotes de livros físicos, incluindo títulos raros, acadêmicos e fora de catálogo. Para reduzir a exposição pública, as encomendas podem ser feitas por intermediários que não revelam claramente quem será o comprador final .
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
As pessoas também perguntam
Qual é a resposta curta para "O escaneamento destrutivo que transformou livros em dados para a IA"?
A Anthropic iniciou o Project Panama no começo de 2024 e gastou dezenas de milhões de dólares para comprar, digitalizar e destruir milhões de livros físicos usados no treinamento do Claude.
Quais são os pontos-chave para validar primeiro?
A Anthropic iniciou o Project Panama no começo de 2024 e gastou dezenas de milhões de dólares para comprar, digitalizar e destruir milhões de livros físicos usados no treinamento do Claude. O processo, conhecido como “escaneamento destrutivo”, envolve comprar títulos — inclusive raros e fora de catálogo — por meio de intermediários, cortar suas lombadas, escanear as páginas e triturar o que resta.
O que devo fazer a seguir na prática?
A Justiça dos Estados Unidos considerou legal o treinamento com livros adquiridos legalmente, mas rejeitou o uso de cópias pirateadas; o caso terminou com um acordo coletivo de US$ 1,5 bilhão em julho de 2026.
Fontes
yahoo.comAI companies are anonymously buying and destroying ...
ground.newsAI Firms Are Quietly Buying and Destroying Millions of ...
christianactivities.comThe Hidden Costs of Destroying Physical Books for AI Training Data | Christian Activities
dallasexpress.comAI Firms Scan Then Destroy Rare Book Editions
