Benchmark do GPT-5.5: o que 84,9% no GDPval realmente significa
O benchmark curto mais sólido para o GPT 5.5 é 84,9% no GDPval: a própria OpenAI cita esse valor e descreve o teste como uma avaliação de trabalho de conhecimento bem especificado em 44 ocupações.[1] Números como 73,1% no Expert SWE e 80,5% no BixBench medem áreas diferentes, como programação e bioinformática, e não...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
O benchmark curto mais sólido para o GPT 5.5 é 84,9% no GDPval: a própria OpenAI cita esse valor e descreve o teste como uma avaliação de trabalho de conhecimento bem especificado em 44 ocupações.[1]
Números como 73,1% no Expert SWE e 80,5% no BixBench medem áreas diferentes, como programação e bioinformática, e não devem ser comparados diretamente com o GDPval.[8][10]
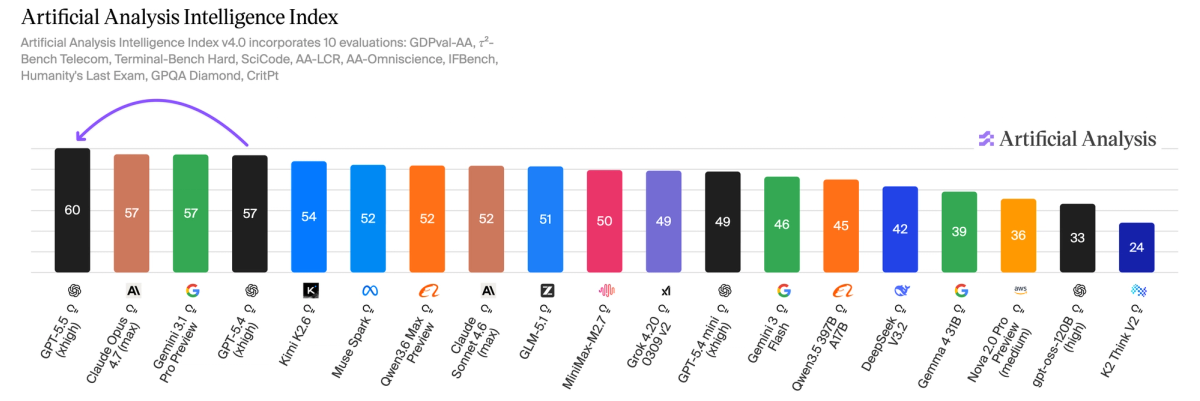
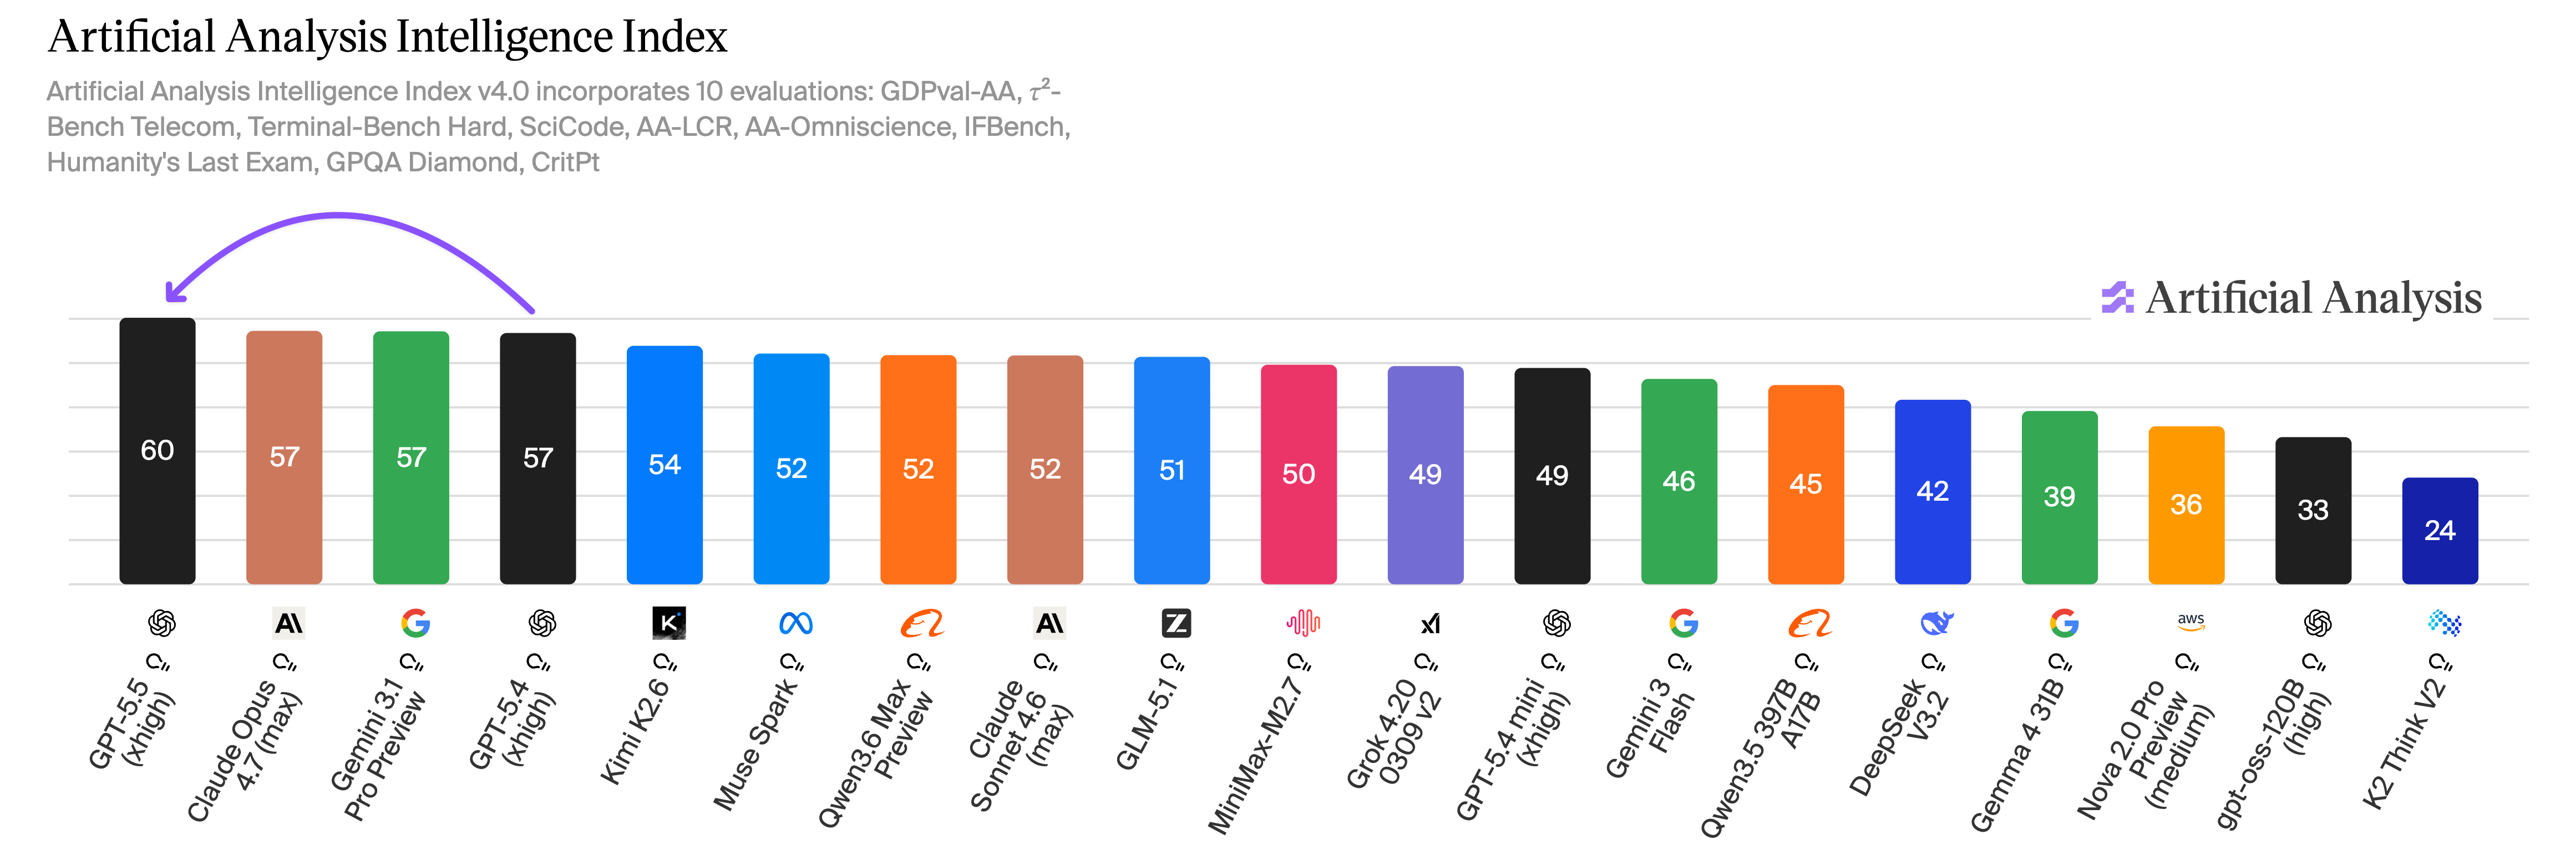
Para comparação externa entre modelos, a Artificial Analysis coloca o GPT 5.5 no topo de seu Intelligence Index com três pontos de vantagem, mas isso não significa vencer todos os testes individuais.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
Para quem quer uma resposta curta, o número mais seguro é este: o GPT-5.5 alcança 84,9% no GDPval, segundo a OpenAI. A empresa descreve o GDPval como um benchmark que testa a capacidade de agentes de produzir trabalho de conhecimento bem especificado em 44 ocupações.
Mas há uma pegadinha importante: esse percentual não é uma nota universal de inteligência, qualidade ou “melhor modelo para tudo”. Ele diz respeito principalmente a tarefas profissionais bem definidas, com foco em entender instruções e entregar resultados de trabalho de conhecimento.
O benchmark mais útil para citar: 84,9% no GDPval
Se a pergunta for “qual é o benchmark do GPT-5.5?”, a formulação mais precisa é:
Segundo a OpenAI, o GPT-5.5 marca 84,9% no GDPval, um benchmark voltado a trabalho de conhecimento bem especificado em 44 ocupações.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Benchmark do GPT-5.5: o que 84,9% no GDPval realmente significa"?
O benchmark curto mais sólido para o GPT 5.5 é 84,9% no GDPval: a própria OpenAI cita esse valor e descreve o teste como uma avaliação de trabalho de conhecimento bem especificado em 44 ocupações.[1]
Quais são os pontos-chave para validar primeiro?
O benchmark curto mais sólido para o GPT 5.5 é 84,9% no GDPval: a própria OpenAI cita esse valor e descreve o teste como uma avaliação de trabalho de conhecimento bem especificado em 44 ocupações.[1] Números como 73,1% no Expert SWE e 80,5% no BixBench medem áreas diferentes, como programação e bioinformática, e não devem ser comparados diretamente com o GDPval.[8][10]
O que devo fazer a seguir na prática?
Para comparação externa entre modelos, a Artificial Analysis coloca o GPT 5.5 no topo de seu Intelligence Index com três pontos de vantagem, mas isso não significa vencer todos os testes individuais.[3]
Esse é o dado mais direto para uma visão geral porque vem da própria apresentação da OpenAI e tem um escopo descrito com clareza. Ainda assim, GDPval não é a mesma coisa que um teste de programação, um benchmark de bioinformática ou um índice externo que combina várias avaliações.
Em outras palavras: o número é relevante, mas só faz sentido quando acompanhado do nome do teste.
Principais números citados publicamente
Benchmark ou comparação
Valor informado
O que mede
Como interpretar
GDPval
84,9%
Trabalho de conhecimento bem especificado em 44 ocupações
É o valor citado diretamente pela OpenAI e, por isso, o melhor benchmark curto para uma resposta geral.
Expert-SWE
73,1%
Tarefas de programação; segundo o relato, uma avaliação interna para tarefas com tempo estimado de 20 horas
É mais relevante para desenvolvimento de software do que o GDPval, mas não é comparável diretamente a ele.
BixBench
80,5%
Benchmark de bioinformática em cenários reais
Faz mais sentido para bioinformática; nas fontes disponíveis aqui, tem base menos forte do que o dado da OpenAI sobre o GDPval.
Artificial Analysis Intelligence Index
1º lugar, com vantagem de 3 pontos
Índice externo de comparação de modelos da Artificial Analysis
Ajuda a comparar modelos de forma ampla, mas não é um benchmark oficial único da OpenAI.
Por que esses percentuais não devem ser colocados na mesma régua
À primeira vista, 84,9%, 73,1% e 80,5% parecem notas da mesma prova. Não são.
84,9% no GDPval se refere a trabalho de conhecimento bem especificado em várias ocupações.
73,1% no Expert-SWE se refere a tarefas de programação em uma avaliação interna.
80,5% no BixBench se refere a tarefas de bioinformática.
Por isso, a pergunta certa não é simplesmente “qual porcentagem é maior?”. A pergunta mais útil é: qual benchmark combina com o uso que você tem em mente?
Para trabalho de conhecimento em geral, GDPval é a referência mais adequada entre os números citados. Para desenvolvimento de software, Expert-SWE está mais perto do problema. Para bioinformática, BixBench é o recorte temático mais apropriado.
O que significa liderar o índice da Artificial Analysis
A Artificial Analysis afirma que o GPT-5.5 lidera seu Intelligence Index com três pontos de vantagem. A mesma análise também diz que a OpenAI lidera cinco das avaliações principais e fica atrás do Gemini 3.1 Pro Preview em outras três.
Essa diferença é importante. Estar em primeiro lugar em um índice externo não quer dizer que o modelo vença todos os testes. Quer dizer que, pela metodologia daquele índice, o GPT-5.5 fica à frente no resultado agregado.
Cuidado com manchetes baseadas em um único número
Também aparecem outros números associados ao GPT-5.5, como 91,7% em contexto de capacidades jurídicas de IA ou 82,7% em programação agentic. Esses dados podem ser úteis em seus recortes específicos, mas são menos indicados para responder, de forma geral, “qual é o benchmark do GPT-5.5?”.
O motivo é simples: sem comparar o desenho do teste, o grupo de modelos avaliados e o objetivo da medição, um percentual isolado pode parecer mais conclusivo do que realmente é. Para uma resposta geral, o dado de 84,9% no GDPval é mais limpo porque vem diretamente da OpenAI e tem uma descrição clara do que está sendo medido.
Então, qual número usar?
Para a maioria das comparações gerais, use esta versão:
O GPT-5.5 alcança 84,9% no GDPval, segundo a OpenAI; o GDPval avalia a capacidade de agentes de produzir trabalho de conhecimento bem especificado em 44 ocupações.
Se o contexto for mais específico, troque a referência:
Trabalho de conhecimento em geral: 84,9% no GDPval.
Programação: 73,1% no Expert-SWE.
Bioinformática: 80,5% no BixBench, com a ressalva de que a base disponível aqui é mais limitada.
Comparação ampla entre modelos: 1º lugar no Artificial Analysis Intelligence Index, com três pontos de vantagem.
Em resumo
O melhor benchmark curto para o GPT-5.5 é 84,9% no GDPval. Ele é o número mais diretamente sustentado pela fonte da OpenAI e mede um tipo específico de desempenho: trabalho de conhecimento bem especificado em 44 ocupações.
Outros valores podem ser importantes, especialmente para programação, bioinformática ou comparações entre modelos. Só não devem ser tratados como se fossem a mesma métrica.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
Esse é o dado mais direto para uma visão geral porque vem da própria apresentação da OpenAI e tem um escopo descrito com clareza. Ainda assim, GDPval não é a mesma coisa que um teste de programação, um benchmark de bioinformática ou um índice externo que combina várias avaliações.
Em outras palavras: o número é relevante, mas só faz sentido quando acompanhado do nome do teste.
Principais números citados publicamente
Benchmark ou comparação
Valor informado
O que mede
Como interpretar
GDPval
84,9%
Trabalho de conhecimento bem especificado em 44 ocupações
É o valor citado diretamente pela OpenAI e, por isso, o melhor benchmark curto para uma resposta geral.
Expert-SWE
73,1%
Tarefas de programação; segundo o relato, uma avaliação interna para tarefas com tempo estimado de 20 horas
É mais relevante para desenvolvimento de software do que o GDPval, mas não é comparável diretamente a ele.
BixBench
80,5%
Benchmark de bioinformática em cenários reais
Faz mais sentido para bioinformática; nas fontes disponíveis aqui, tem base menos forte do que o dado da OpenAI sobre o GDPval.
Artificial Analysis Intelligence Index
1º lugar, com vantagem de 3 pontos
Índice externo de comparação de modelos da Artificial Analysis
Ajuda a comparar modelos de forma ampla, mas não é um benchmark oficial único da OpenAI.
Por que esses percentuais não devem ser colocados na mesma régua
À primeira vista, 84,9%, 73,1% e 80,5% parecem notas da mesma prova. Não são.
84,9% no GDPval se refere a trabalho de conhecimento bem especificado em várias ocupações.
73,1% no Expert-SWE se refere a tarefas de programação em uma avaliação interna.
80,5% no BixBench se refere a tarefas de bioinformática.
Por isso, a pergunta certa não é simplesmente “qual porcentagem é maior?”. A pergunta mais útil é: qual benchmark combina com o uso que você tem em mente?
Para trabalho de conhecimento em geral, GDPval é a referência mais adequada entre os números citados. Para desenvolvimento de software, Expert-SWE está mais perto do problema. Para bioinformática, BixBench é o recorte temático mais apropriado.
O que significa liderar o índice da Artificial Analysis
A Artificial Analysis afirma que o GPT-5.5 lidera seu Intelligence Index com três pontos de vantagem. A mesma análise também diz que a OpenAI lidera cinco das avaliações principais e fica atrás do Gemini 3.1 Pro Preview em outras três.
Essa diferença é importante. Estar em primeiro lugar em um índice externo não quer dizer que o modelo vença todos os testes. Quer dizer que, pela metodologia daquele índice, o GPT-5.5 fica à frente no resultado agregado.
Cuidado com manchetes baseadas em um único número
Também aparecem outros números associados ao GPT-5.5, como 91,7% em contexto de capacidades jurídicas de IA ou 82,7% em programação agentic. Esses dados podem ser úteis em seus recortes específicos, mas são menos indicados para responder, de forma geral, “qual é o benchmark do GPT-5.5?”.
O motivo é simples: sem comparar o desenho do teste, o grupo de modelos avaliados e o objetivo da medição, um percentual isolado pode parecer mais conclusivo do que realmente é. Para uma resposta geral, o dado de 84,9% no GDPval é mais limpo porque vem diretamente da OpenAI e tem uma descrição clara do que está sendo medido.
Então, qual número usar?
Para a maioria das comparações gerais, use esta versão:
O GPT-5.5 alcança 84,9% no GDPval, segundo a OpenAI; o GDPval avalia a capacidade de agentes de produzir trabalho de conhecimento bem especificado em 44 ocupações.
Se o contexto for mais específico, troque a referência:
Trabalho de conhecimento em geral: 84,9% no GDPval.
Programação: 73,1% no Expert-SWE.
Bioinformática: 80,5% no BixBench, com a ressalva de que a base disponível aqui é mais limitada.
Comparação ampla entre modelos: 1º lugar no Artificial Analysis Intelligence Index, com três pontos de vantagem.
Em resumo
O melhor benchmark curto para o GPT-5.5 é 84,9% no GDPval. Ele é o número mais diretamente sustentado pela fonte da OpenAI e mede um tipo específico de desempenho: trabalho de conhecimento bem especificado em 44 ocupações.
Outros valores podem ser importantes, especialmente para programação, bioinformática ou comparações entre modelos. Só não devem ser tratados como se fossem a mesma métrica.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News