RespostasPublicado14 fontes
Wan-Animate-2 leva a animação de personagens em tempo real para o código aberto
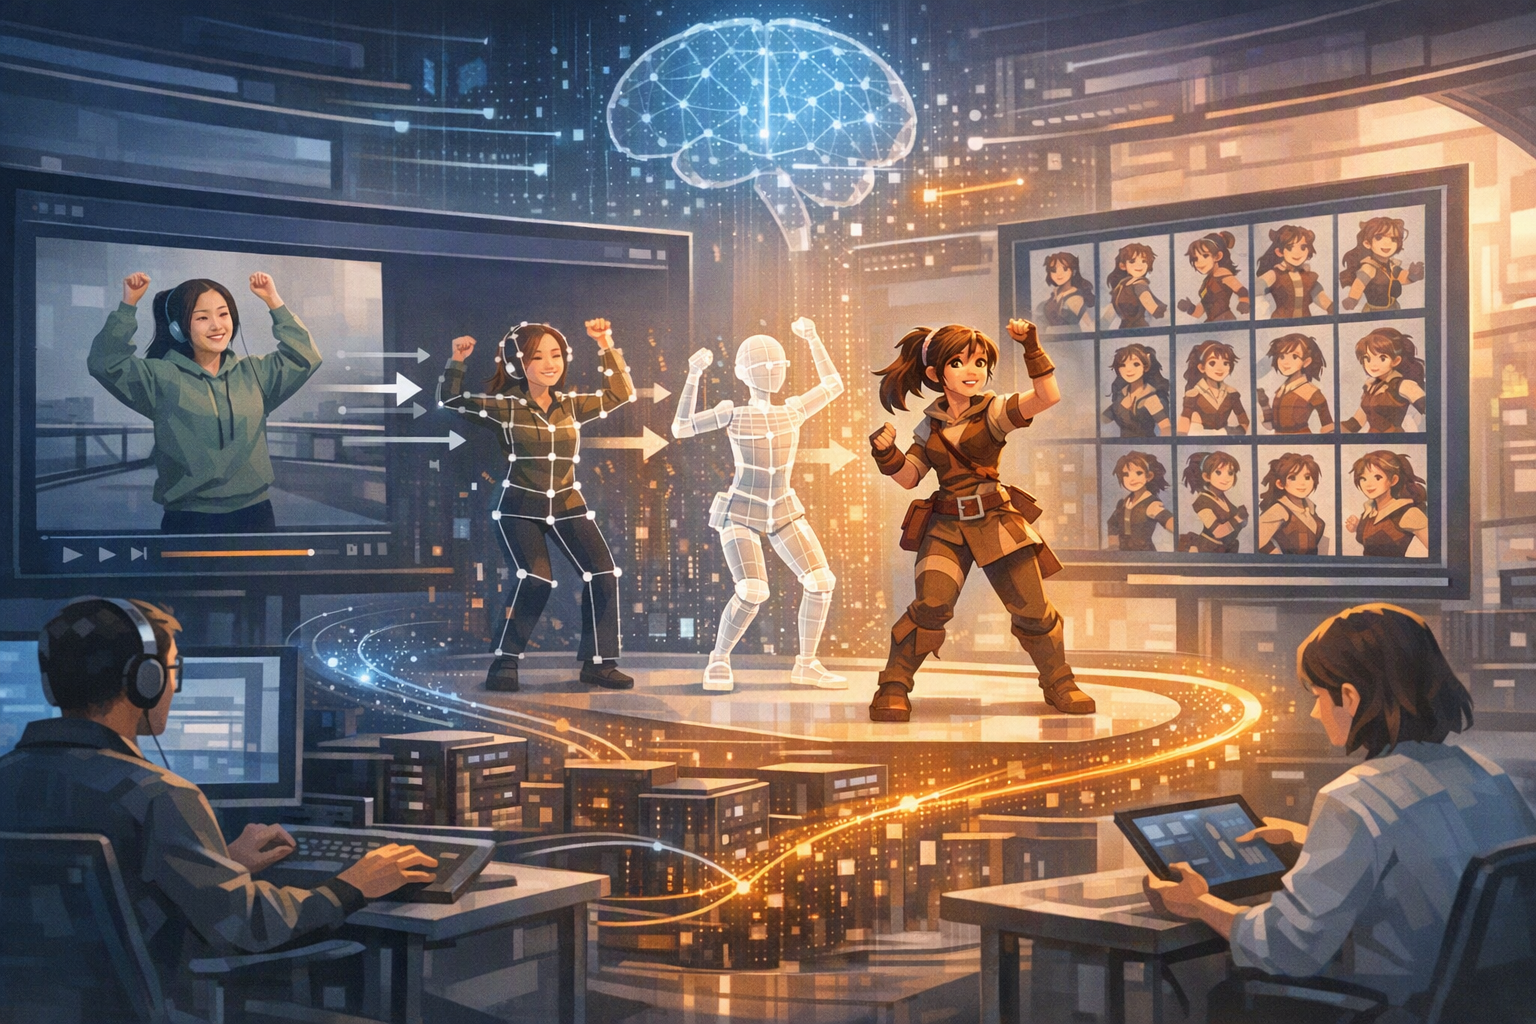
O Wan Animate 2 anima um personagem de referência a partir de um vídeo guia, preservando sua identidade e aprendendo o movimento de ponta a ponta. Em vez de converter o vídeo em um esqueleto de pose ou em recursos comprimidos, o modelo envia os dados visuais diretamente para um Diffusion Transformer.
Publicado porEditado com GPT-5.6 LunaImagens geradas com GPT Image 1.5
Resposta de pesquisa
Principais conclusões
- O Wan Animate 2 anima um personagem de referência a partir de um vídeo guia, preservando sua identidade e aprendendo o movimento de ponta a ponta.
- Em vez de converter o vídeo em um esqueleto de pose ou em recursos comprimidos, o modelo envia os dados visuais diretamente para um Diffusion Transformer.
- A versão Wan Animate 2 Lite chega a 24 quadros por segundo em 400 × 720 usando quatro GPUs H100 — um resultado de infraestrutura profissional, não de hardware doméstico comum.
- O sistema também oferece animação com múltiplos personagens e mudança do ponto de vista da câmera por texto, sem exigir novo treinamento do modelo base.
Prompt de IA
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Alibaba’s open source Wan Animate 2, released by the Tongyi Wanxiang team in August 2026, and how does its end to end diffusion Tran. Article summary: Wan Animate 2 is Alibaba Tongyi Lab’s open character animation system: it animates a reference character from a driving video, while retaining the character’s identity.. Topic tags: general web, prompt engineering, ai, workflow, productivity. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbna
O Wan-Animate-2 é um sistema aberto de animação de personagens desenvolvido pelo Tongyi Lab, da Alibaba. Ele recebe a imagem ou o personagem de referência e um vídeo-guia — no qual alguém realiza os movimentos — para transferir ação, expressão e dinâmica ao personagem, mantendo sua identidade visual. O lançamento público ocorreu em agosto de 2026, com pesos, código e ferramentas de inferência disponibilizados sob a licença Apache 2.0. 1
2
A principal mudança está na forma como o modelo interpreta o movimento. Sistemas tradicionais costumam extrair primeiro pontos do corpo, articulações e um esqueleto de pose. Outros comprimem o movimento em uma representação intermediária antes de gerar o vídeo. O Wan-Animate-2 elimina essas duas etapas: o vídeo-guia entra diretamente em uma arquitetura redesenhada de Diffusion Transformer, ou DiT. 1
Por que dispensar o esqueleto de pose?
Transformar um vídeo em um conjunto de pontos corporais pode introduzir erros de detecção, especialmente em mãos, rosto, membros parcialmente ocultos e interações entre pessoas. A compressão também pode descartar detalhes temporais e espaciais importantes. Segundo os autores, preservar os sinais visuais do vídeo permite que o modelo mantenha melhor a continuidade da identidade e do movimento. 1
A arquitetura usa um DiT de dois ramos: um ramo de referência e movimento, mantido limpo, fornece informações ao ramo responsável pelo processo de remoção de ruído. Esse desenho ajuda o sistema a alinhar aparência e ação sem obrigá-las a passar por uma descrição esquelética simplificada. Na prática, os resultados apresentados destacam articulação mais natural das mãos, menos membros deformados ou ausentes e maior consistência entre os quadros. 1
Isso não significa que qualquer vídeo de entrada terá resultado perfeito. O trabalho, porém, relata testes com diferentes estilos de personagem, formatos corporais, movimentos e cenas com várias pessoas, indicando uma faixa de uso mais ampla do que a normalmente associada a sistemas condicionados por pose. 1
Câmera controlada por texto e cenas com vários personagens
Outra função é o controle textual do ponto de vista. Um Viewpoint LoRA, treinado com dados sintéticos de múltiplas câmeras produzidos na Unreal Engine, foi usado para separar o ângulo da câmera do movimento presente no vídeo-guia. Assim, o usuário pode solicitar outro enquadramento ou ângulo durante a inferência, sem gravar uma nova performance nem retreinar o modelo principal. 1
O framework também foi apresentado com suporte a múltiplos personagens na mesma cena, preservando identidades e movimentos distintos. A combinação de personagens variados, cenas com mais de uma pessoa, proporções corporais diferentes e formatos de imagem não convencionais amplia o uso potencial para avatares, pré-visualização, criação de conteúdo e produção audiovisual. 1
3
De onde vêm os 24 quadros por segundo?
A capacidade de geração em tempo real está principalmente associada ao Wan-Animate-2-Lite, uma versão destilada e mais leve — não ao modelo Base completo. O artigo descreve uma rota de aceleração em três etapas: pré-treinamento com teacher forcing, uso de um buffer de erros e destilação por Self-Forcing com retropropagação em blocos (chunks). Esse processo permite gerar os blocos de vídeo de maneira autorregressiva e transmiti-los enquanto o restante ainda é produzido. 1
O desempenho reportado é de 24 quadros por segundo em 400 × 720 com quatro GPUs H100. É uma demonstração relevante de streaming em tempo real, mas não deve ser interpretada como geração de vídeo a 24 fps em 720p em um computador comum. O custo de memória, a disponibilidade de GPUs e a configuração do pipeline continuam sendo fatores decisivos para quem quiser executar o modelo localmente. 1
8
O modelo realmente iguala Dreamina e KLING?
As comparações qualitativas e os estudos com usuários apresentados no artigo indicam desempenho competitivo com ferramentas proprietárias como o Dreamina, da ByteDance, e o KLING MotionControl, da Kuaishou. Relatos públicos chegaram a descrever o resultado como equivalente ao de líderes comerciais. 1
3
Ainda assim, há uma ressalva importante: essas são avaliações reportadas pelos desenvolvedores e pelo próprio trabalho, não um benchmark independente, padronizado e reproduzível por terceiros. Por isso, a expressão “SOTA comercial” — estado da arte comercial — deve ser lida como uma reivindicação forte, mas ainda provisória. A qualidade fora dos exemplos selecionados, em vídeos com oclusões, iluminação difícil e movimentos incomuns, será um teste mais importante para a adoção.
Por que o lançamento local é importante?
A publicação dos pesos, do código e das ferramentas de inferência muda a natureza do recurso. Em vez de depender exclusivamente de uma plataforma fechada e de uma cobrança por uso, desenvolvedores podem examinar o sistema, hospedá-lo em sua própria infraestrutura, adaptá-lo e incorporá-lo a fluxos de produção sob as condições da licença Apache 2.0. 1
2
Esse ponto é relevante porque a animação controlável de personagens continua sendo uma das partes mais difíceis da produção de vídeo com IA. Gerar um clipe isolado é diferente de manter, ao longo de uma sequência, a mesma identidade, mãos coerentes, interações convincentes, direção de câmera e baixa latência. O Wan-Animate-2 tenta atacar justamente esse gargalo entre uma demonstração visual impressionante e um elemento que possa ser usado em uma cadeia de produção.
O impacto dependerá, porém, do ecossistema. Integrações para ferramentas como ComfyUI, nós mais robustos, inferência com menor consumo de memória, máscaras e composição, fluxos de consistência de personagem e versões capazes de rodar em GPUs de consumo serão determinantes. Também será preciso verificar a reprodutibilidade dos resultados, o custo do hardware e as questões de licenciamento relacionadas aos dados de treinamento.
Como o Wan-Animate-2 se relaciona ao Wan3.0?
Os dois projetos ocupam posições diferentes no fluxo de trabalho. O Wan-Animate-2 se concentra na performance e no controle do personagem: recebe um vídeo de movimento e transforma esse desempenho em uma animação preservando a identidade. Já o Wan3.0 atua na entrada empresarial e multimodal: segundo a Alibaba, consegue gerar vídeos de até 30 segundos a partir de documentos, planilhas, apresentações e páginas da web, além de entradas convencionais como texto, imagens, áudio e vídeo. 2
Juntos, eles apontam para um caminho que vai de materiais de negócio a conteúdo audiovisual animado. Mas isso não prova a existência de uma suíte única e integrada de produção: o Wan3.0 é um produto implantado separadamente, enquanto o Wan-Animate-2 é um lançamento aberto voltado ao controle de personagens.
No fim, a importância do Wan-Animate-2 não está apenas nos 24 fps ou na remoção do esqueleto de pose. O aspecto decisivo é tornar acessível, localmente e de forma adaptável, uma camada de controle que costuma permanecer fechada nas plataformas comerciais. Se a comunidade conseguir transformar o modelo em uma ferramenta eficiente e confiável fora dos exemplos curados, a animação de personagens pode deixar de ser um dos principais gargalos do vídeo gerado por IA.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
As pessoas também perguntam
Qual é a resposta curta para "Wan-Animate-2 leva a animação de personagens em tempo real para o código aberto"?
O Wan Animate 2 anima um personagem de referência a partir de um vídeo guia, preservando sua identidade e aprendendo o movimento de ponta a ponta.
Quais são os pontos-chave para validar primeiro?
O Wan Animate 2 anima um personagem de referência a partir de um vídeo guia, preservando sua identidade e aprendendo o movimento de ponta a ponta. Em vez de converter o vídeo em um esqueleto de pose ou em recursos comprimidos, o modelo envia os dados visuais diretamente para um Diffusion Transformer.
O que devo fazer a seguir na prática?
A versão Wan Animate 2 Lite chega a 24 quadros por segundo em 400 × 720 usando quatro GPUs H100 — um resultado de infraestrutura profissional, não de hardware doméstico comum.
Fontes
arxiv.orgWan-Animate-2: Pushing the Application Boundaries of Character ...
opensourceforu.comAlibaba Open Sources Wan-Animate-2: Real-Time AI Character Animation - Open Source For You
outlookindia.comWan-Animate-2 Goes Open Source for AI Character Animation
alphasignal.aiAlibaba's Wan-Animate-2 Beats Proprietary Platforms Without a ...