ZAYA1‑8B‑Diffusion‑Preview: como a Zyphra acelera a geração de texto com difusão
O ZAYA1‑8B‑Diffusion‑Preview converte o modelo autoregressivo ZAYA1‑8B em um LLM de difusão que gera blocos de 16 tokens em paralelo. A técnica pode acelerar a decodificação entre 4,6× e 7,7× dependendo do método de amostragem utilizado.
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
O ZAYA1‑8B‑Diffusion‑Preview converte o modelo autoregressivo ZAYA1‑8B em um LLM de difusão que gera blocos de 16 tokens em paralelo.
A técnica pode acelerar a decodificação entre 4,6× e 7,7× dependendo do método de amostragem utilizado.
Se os resultados se confirmarem em produção, a abordagem pode reduzir custos de inferência e acelerar treinamentos com reinforcement learning.
What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion lDiffusion-style language models can draft multiple tokens simultaneously instead of generating them sequentially.
Prompt de IA
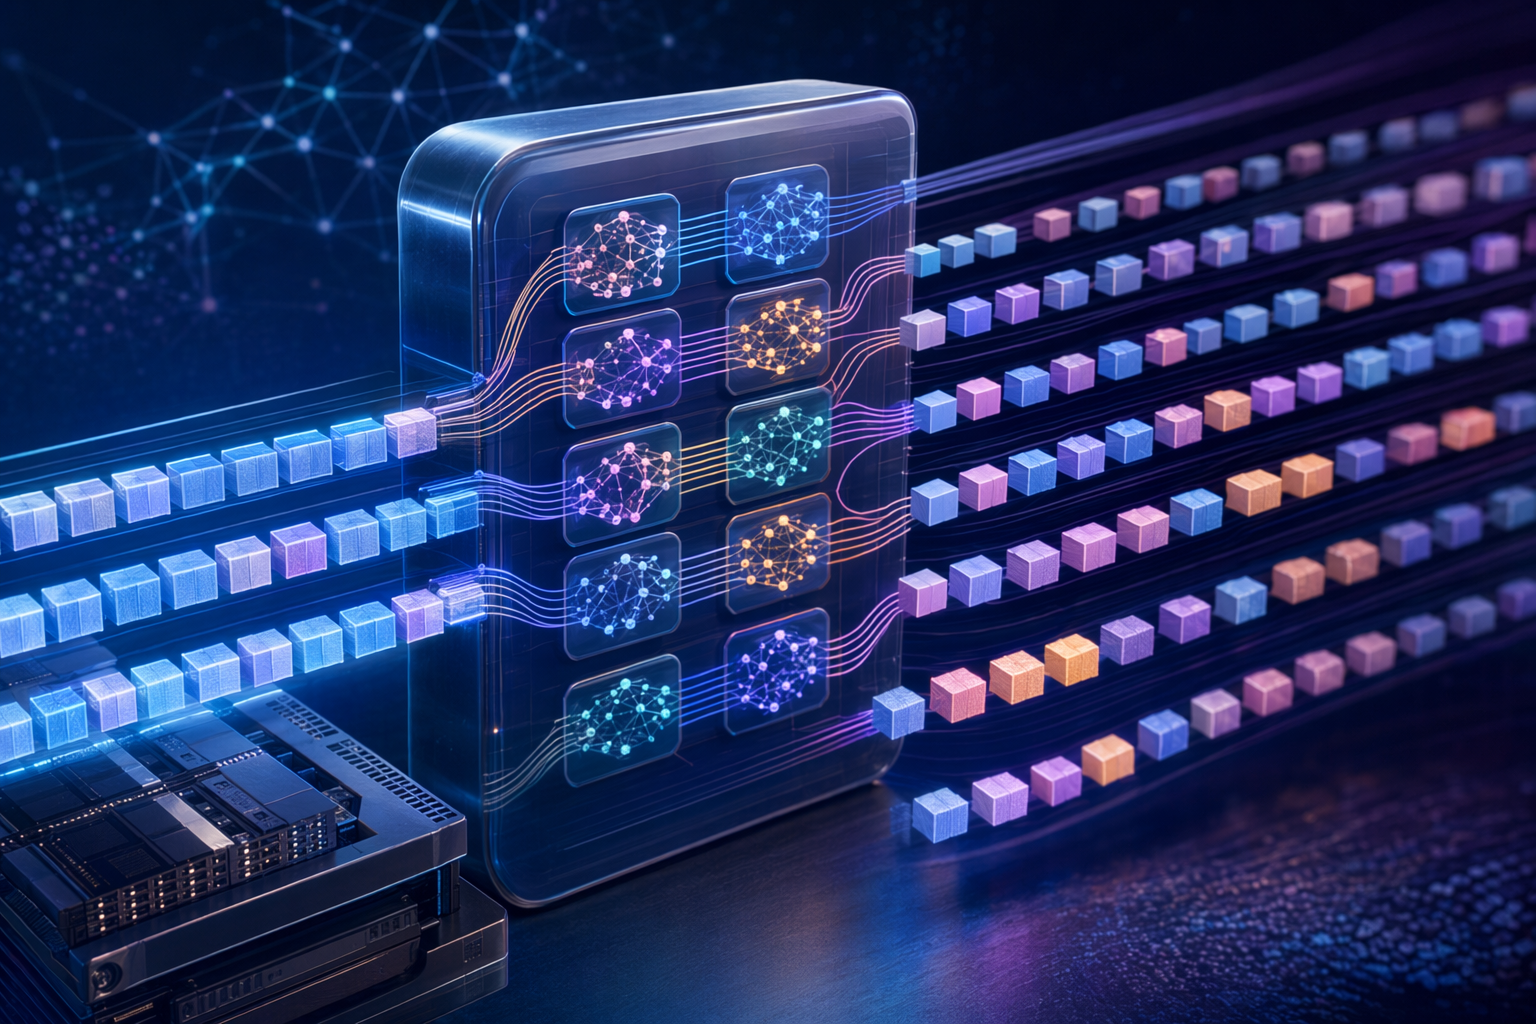
Create a landscape editorial hero image for this Studio Global article: What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion l. Article summary: Zyphra’s ZAYA1-8B-Diffusion-Preview is an experimental diffusion-language version of its ZAYA1-8B MoE model, designed to decode blocks of text in parallel rather than strictly one token at a time. Zyphra claims it can ge. Topic tags: general, academic, general web, user generated. Reference image context from search candidates: Reference image 1: visual subject "# Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class. Zyphra AI has released ZAYA1-8B, a small Mixture of Experts (MoE) langu" source context "Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class
openai.com
Uma abordagem de difusão para acelerar a geração de texto
A startup de IA Zyphra apresentou o ZAYA1‑8B‑Diffusion‑Preview, uma versão experimental de seu modelo de linguagem ZAYA1‑8B que troca o método tradicional de geração por um processo baseado em difusão. Em vez de produzir texto token por token, como fazem a maioria dos LLMs atuais, o sistema cria blocos de 16 tokens de uma só vez.
Segundo a empresa, essa mudança permite acelerar a etapa de geração (decoding) de forma significativa. Os testes indicam ganhos teóricos de cerca de 4,6× usando um sampler “lossless” e até 7,7× com um sampler de mistura de logits, com impacto limitado na qualidade dependendo da configuração escolhida.
Um detalhe importante: o modelo não foi treinado do zero como difusão. Em vez disso, a Zyphra converteu um checkpoint existente do modelo autoregressivo ZAYA1‑8B para esse novo formato, mostrando que LLMs tradicionais podem ser adaptados para esse tipo de geração paralela.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "ZAYA1‑8B‑Diffusion‑Preview: como a Zyphra acelera a geração de texto com difusão"?
O ZAYA1‑8B‑Diffusion‑Preview converte o modelo autoregressivo ZAYA1‑8B em um LLM de difusão que gera blocos de 16 tokens em paralelo.
Quais são os pontos-chave para validar primeiro?
O ZAYA1‑8B‑Diffusion‑Preview converte o modelo autoregressivo ZAYA1‑8B em um LLM de difusão que gera blocos de 16 tokens em paralelo. A técnica pode acelerar a decodificação entre 4,6× e 7,7× dependendo do método de amostragem utilizado.
O que devo fazer a seguir na prática?
Se os resultados se confirmarem em produção, a abordagem pode reduzir custos de inferência e acelerar treinamentos com reinforcement learning.
O Diffusion‑Preview é construído sobre o ZAYA1‑8B, um modelo de raciocínio baseado em mixture‑of‑experts (MoE).
Ele possui pouco mais de 8 bilhões de parâmetros no total, mas durante a inferência ativa apenas cerca de 760 milhões, graças ao mecanismo de roteamento entre especialistas. Isso reduz o custo computacional mantendo desempenho competitivo em benchmarks, segundo análises do setor.
Na prática, arquiteturas MoE funcionam ativando apenas sub‑redes especializadas (“experts”) para cada token gerado. Esse mecanismo pode reduzir o custo de inferência quando comparado a modelos densos com tamanho equivalente.
Por que a geração autoregressiva é lenta
Quase todos os modelos de linguagem atuais utilizam decodificação autoregressiva.
O processo segue sempre a mesma lógica:
gerar o próximo token
atualizar o cache de atenção (KV cache)
repetir o processo
Como cada token depende de todos os anteriores, a geração precisa ocorrer de forma sequencial. Isso dificulta paralelização e frequentemente cria gargalos de largura de banda de memória, já que o sistema acessa constantemente o KV cache durante a geração.
Como o modelo gera 16 tokens ao mesmo tempo
O método de difusão muda essa dinâmica.
Em vez de prever apenas o próximo token, o modelo propõe simultaneamente um bloco de tokens candidatos. No caso do ZAYA1‑8B‑Diffusion‑Preview, cada etapa gera 16 tokens candidatos por vez.
O fluxo geral funciona assim:
O modelo cria múltiplos rascunhos para um bloco de tokens.
Um sampler avalia quais desses tokens podem ser aceitos.
Os tokens aceitos são adicionados à resposta final.
O processo se repete para o próximo bloco.
Como todos os tokens do bloco compartilham o mesmo prefixo e estado do KV cache, o cálculo pode ocorrer em paralelo dentro de uma única passagem do modelo. Isso muda a natureza do gargalo: em vez de depender principalmente da memória, o trabalho passa a ser mais intensivo em computação paralela, algo que GPUs executam com muito mais eficiência.
Dois métodos de amostragem e seus ganhos de velocidade
Os ganhos de desempenho dependem do sampler usado na geração.
Lossless sampler
Usa regras de aceitação parecidas com as do speculative decoding
Aproximadamente 4,6× mais rápido que a geração autoregressiva
Projetado para evitar queda sistemática de qualidade nos benchmarks
Logit‑mixing sampler
Combina logits do modelo de difusão e do modelo autoregressivo
Aumenta a taxa de aceitação de tokens
Pode chegar a 7,7× de aceleração, mas com possível perda de qualidade
Vale notar que esses números vêm principalmente de testes divulgados pela própria Zyphra, então benchmarks independentes ainda serão importantes para confirmar o desempenho em cenários reais.
O papel do treinamento com GPUs AMD
Outro aspecto incomum do projeto é o hardware utilizado. A Zyphra afirma que o modelo é o primeiro modelo de linguagem por difusão treinado em GPUs AMD, em vez da infraestrutura Nvidia que domina a maior parte do treinamento de IA atualmente.
O ZAYA1‑8B e sua versão de difusão foram treinados usando a pilha de IA da AMD, o que demonstra que experimentos avançados com LLMs podem acontecer fora do ecossistema tradicional da Nvidia. Se essa abordagem se mostrar reproduzível em larga escala, pode estimular maior competição no mercado de hardware para IA.
Compressed Convolutional Attention (CCA)
O ZAYA1‑8B também inclui um mecanismo chamado Compressed Convolutional Attention (CCA).
A ideia é reduzir o custo computacional do mecanismo de atenção, especialmente em operações altamente paralelas.
Isso é relevante porque a geração por difusão transforma parte da inferência em algo parecido com uma operação de prefill em larga escala — etapa que se beneficia muito de uma atenção mais eficiente. Reduzir esse custo ajuda a tornar a geração simultânea de múltiplos tokens mais viável.
Impacto potencial no custo de inferência
Se os ganhos de velocidade se confirmarem em produção, as consequências podem ser relevantes para a economia da IA.
Geração mais rápida significa:
mais tokens gerados por GPU por segundo
menor custo por token
respostas mais rápidas em prompts longos
Ainda assim, a própria Zyphra observa que a inferência baseada em difusão ainda não está tão otimizada quanto os sistemas autoregressivos tradicionais, então os ganhos reais podem variar dependendo da implementação.
Por que isso importa para treinamento com reinforcement learning
Modelos de raciocínio modernos frequentemente usam reinforcement learning com rollouts on‑policy — um processo em que o modelo precisa gerar muitas respostas candidatas durante o treinamento.
Como o custo depende diretamente da velocidade de geração, decodificação mais rápida pode:
reduzir o custo total do treinamento
permitir explorar mais caminhos de raciocínio por prompt
ampliar experimentos de test‑time compute
Na prática, a velocidade de inferência costuma ser um dos maiores custos em pipelines de treinamento baseados em RL.
Um novo caminho para IA mais eficiente
O ZAYA1‑8B‑Diffusion‑Preview ilustra uma tendência crescente na indústria: em vez de focar apenas em modelos cada vez maiores, pesquisadores estão buscando aumentar a "inteligência por dólar".
Esse projeto combina várias estratégias de eficiência ao mesmo tempo:
arquitetura mixture‑of‑experts
decodificação por difusão
mecanismos alternativos de atenção
treinamento em infraestrutura AMD
Se essas técnicas se provarem robustas em escala, elas podem mudar a forma como futuros modelos são otimizados — não apenas para capacidade, mas também para custo, velocidade e eficiência de hardware. Por enquanto, o ZAYA1‑8B‑Diffusion‑Preview funciona como uma demonstração inicial de que transformar LLMs autoregressivos em decodificadores de difusão pode ser um caminho promissor para acelerar a geração de IA.
zyphra.comZAYA1-8B-Diffusion-Preview: Efficient Parallel Decoding ...
venturebeat.comMeet ZAYA1-8B, a super efficient, open reasoning model trained on ...
gigazine.netA new spreading language model, 'ZAYA1-8B-Diffusion-Preview,' developed with an AMD AI chip, has emerged, transforming autoregressive models into spreading models.
phemex.comZyphra's AMD-Based Diffusion Model Boosts Speed by 7.7x - Phemex