Colapso de modelos de IA: o risco de treinar algoritmos com dados sintéticos
Pesquisas indicam que treinar repetidamente modelos de IA com dados sintéticos pode causar “model collapse”, um processo em que padrões raros desaparecem e o modelo se afasta da distribuição original de dados. O problema surge porque amostras geradas por modelos reproduzem mais frequentemente padrões comuns, enquant...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
Pesquisas indicam que treinar repetidamente modelos de IA com dados sintéticos pode causar “model collapse”, um processo em que padrões raros desaparecem e o modelo se afasta da distribuição original de dados.
O problema surge porque amostras geradas por modelos reproduzem mais frequentemente padrões comuns, enquanto exemplos raros — que ficam nas “caudas” da distribuição — desaparecem ao longo das gerações.
Estudos sugerem que até uma pequena quantidade de dados reais ou conhecimento prévio incorporado ao modelo pode evitar o colapso, preservando evidências desses padrões raros.
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
Prompt de IA
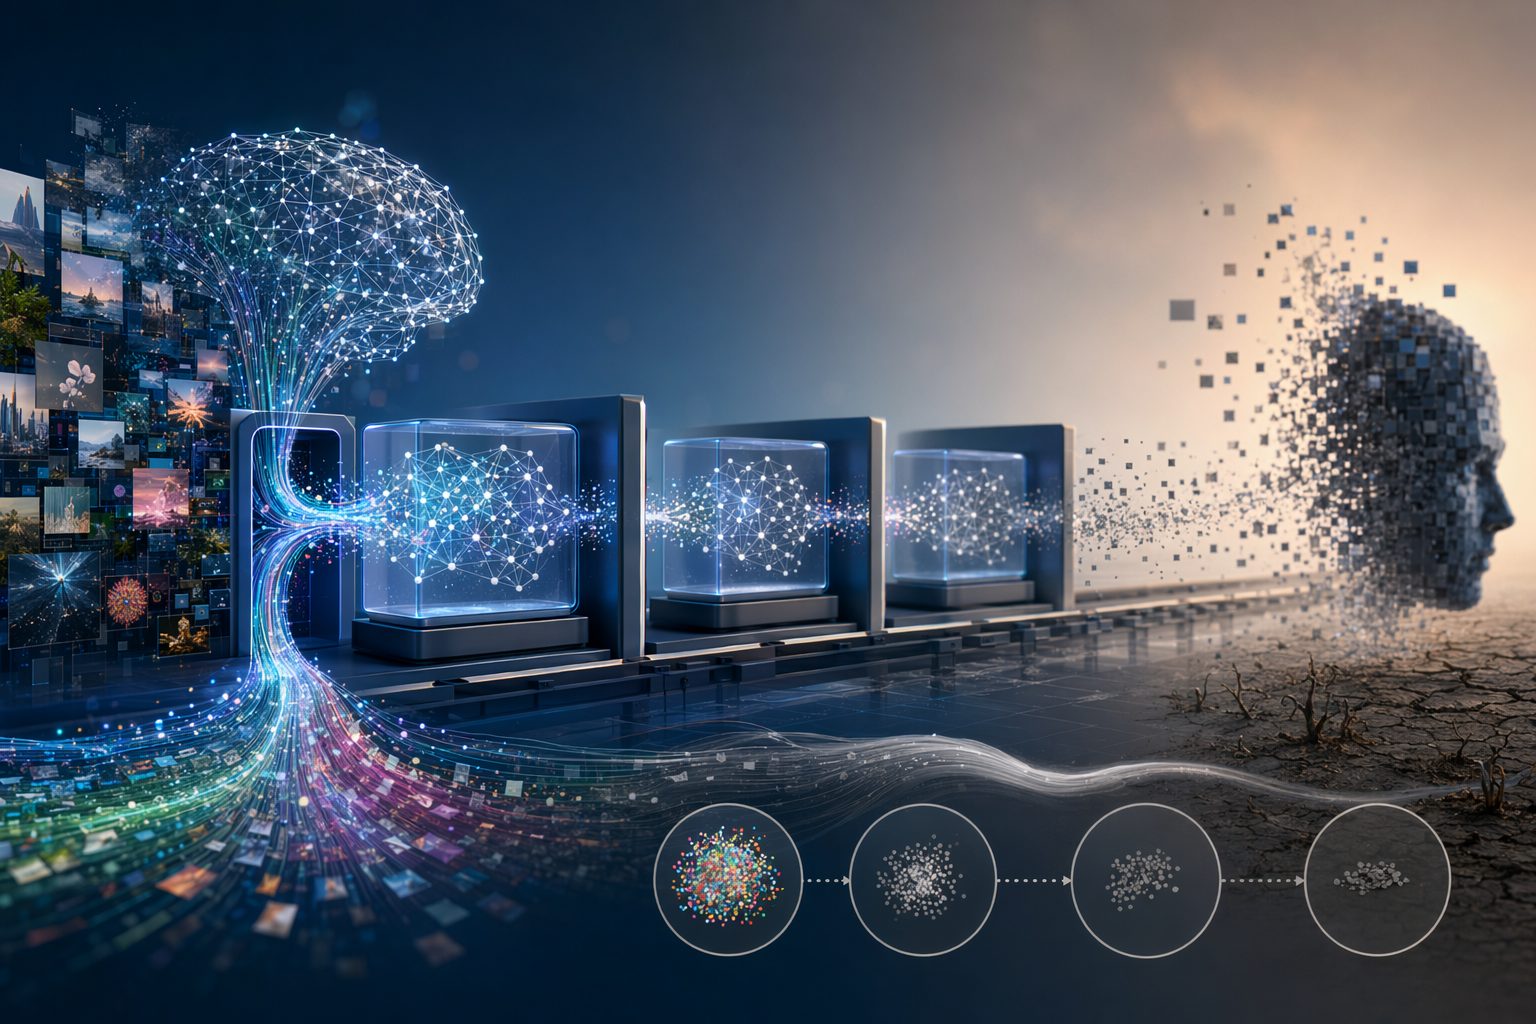
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
Sistemas modernos de IA generativa estão cada vez mais sendo treinados com dados sintéticos — conteúdos produzidos por modelos anteriores. Essa prática ajuda a escalar o treinamento, mas pesquisas recentes apontam um risco importante: o chamado model collapse (colapso de modelo).
Nesse fenômeno, modelos treinados repetidamente com saídas de outras IAs começam a perder a capacidade de representar a diversidade completa dos dados originais. Com o tempo, eles passam a refletir apenas os padrões mais comuns e deixam de capturar casos raros ou incomuns que também fazem parte da realidade.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Colapso de modelos de IA: o risco de treinar algoritmos com dados sintéticos"?
Pesquisas indicam que treinar repetidamente modelos de IA com dados sintéticos pode causar “model collapse”, um processo em que padrões raros desaparecem e o modelo se afasta da distribuição original de dados.
Quais são os pontos-chave para validar primeiro?
Pesquisas indicam que treinar repetidamente modelos de IA com dados sintéticos pode causar “model collapse”, um processo em que padrões raros desaparecem e o modelo se afasta da distribuição original de dados. O problema surge porque amostras geradas por modelos reproduzem mais frequentemente padrões comuns, enquanto exemplos raros — que ficam nas “caudas” da distribuição — desaparecem ao longo das gerações.
O que devo fazer a seguir na prática?
Estudos sugerem que até uma pequena quantidade de dados reais ou conhecimento prévio incorporado ao modelo pode evitar o colapso, preservando evidências desses padrões raros.
À medida que conteúdo gerado por IA se espalha pela internet — e passa a fazer parte dos conjuntos de dados usados para treinar novos sistemas — entender e evitar esse problema se torna cada vez mais importante.
O que é “model collapse”
Model collapse é um modo de falha em que modelos generativos se degradam ao serem treinados com dados produzidos por versões anteriores de modelos, em vez de dados originalmente gerados por humanos.
Pesquisadores mostraram que esse treinamento recursivo pode introduzir defeitos irreversíveis. Em particular, o modelo começa a perder informações sobre as “caudas” da distribuição de dados — ou seja, exemplos raros ou incomuns que aparecem pouco, mas são essenciais para representar corretamente o mundo real.
Com várias gerações de treinamento:
as saídas do modelo ficam menos diversas;
padrões raros desaparecem gradualmente;
o modelo passa a reproduzir apenas os padrões mais comuns.
Esse efeito já foi demonstrado em diferentes tipos de modelos generativos, incluindo:
grandes modelos de linguagem (LLMs);
autoencoders variacionais (VAEs);
modelos de mistura gaussiana (GMMs).
O fato de ocorrer em arquiteturas distintas sugere que o colapso não é um problema específico de um tipo de IA, mas uma propriedade geral do aprendizado generativo quando ele depende demais de dados sintéticos.
Por que o treinamento recursivo apaga padrões raros
O mecanismo por trás do model collapse vem de um princípio estatístico simples.
Quando um modelo gera dados sintéticos, ele tende a reproduzir padrões de alta probabilidade com muito mais frequência do que eventos raros. Esses eventos raros ficam nas “caudas” da distribuição estatística e já são naturalmente pouco representados nas amostras.
Quando um novo modelo é treinado com esse conjunto sintético:
exemplos raros aparecem ainda menos;
o modelo aprende uma distribuição ligeiramente distorcida;
gerações seguintes amplificam essa distorção.
Cada ciclo de treinamento reforça os vieses do modelo anterior. Com o tempo, os exemplos raros desaparecem completamente do conjunto de treinamento — e, sem evidência de que eles existiam, os modelos posteriores não conseguem reconstruí‑los.
Como dados reais ou conhecimento prévio evitam o colapso
Uma descoberta interessante em análises recentes é que uma pequena quantidade de dados reais pode ser suficiente para impedir o colapso.
Estudos com modelos estatísticos conhecidos como famílias exponenciais indicam que até mesmo um único ponto de dados proveniente da distribuição real pode funcionar como uma âncora para o treinamento. Esse ponto preserva a informação de que certos padrões existem, impedindo que o processo recursivo converja para uma distribuição incorreta.
Outra forma de evitar o problema é incorporar conhecimento prévio (priors) no modelo — por exemplo, restrições matemáticas ou suposições estruturais sobre os dados. Essas restrições limitam as distribuições possíveis que o modelo pode aprender e evitam que ele seja guiado apenas pelos vieses presentes nos dados sintéticos.
Na prática, isso significa que:
amostras do mundo real ajudam a preservar padrões raros;
conhecimento prévio pode impedir que o modelo se desvie da distribuição original;
mesmo pequenas quantidades de dados reais podem estabilizar o treinamento.
Por que isso preocupa no treinamento de LLMs
O risco de model collapse ficou mais relevante com a explosão de conteúdo gerado por IA na internet.
Grandes modelos de linguagem (LLMs) são treinados com conjuntos gigantes de texto coletados da web. Se uma parcela crescente desse material for produzida por IAs, os dados usados para treinar modelos futuros podem acabar contaminados por gerações anteriores de modelos.
Se esse conteúdo sintético dominar os conjuntos de treinamento, os modelos podem gradualmente se afastar da diversidade real da linguagem humana e do conhecimento disponível.
Entre os possíveis efeitos estão:
menor diversidade nas respostas geradas;
pior desempenho em casos raros ou incomuns;
uma representação mais limitada da realidade.
Por isso, pesquisadores defendem que o desenvolvimento de IA continue garantindo acesso a dados confiáveis gerados por humanos ou utilize métodos que preservem a distribuição original dos dados durante o treinamento.
O que ainda não está totalmente resolvido
Embora o mecanismo do model collapse tenha forte suporte teórico e experimental, alguns detalhes ainda estão em estudo. Por exemplo, a ideia de que um único ponto de dados real pode impedir o colapso vem principalmente de análises teóricas e modelos estatísticos simplificados, não de experimentos completos em LLMs de escala industrial.
Na prática, a quantidade necessária de dados reais provavelmente depende de fatores como arquitetura do modelo, composição do conjunto de dados e métodos de treinamento.
Mesmo assim, a principal conclusão é clara: treinar IA apenas com dados gerados por outras IAs pode gradualmente apagar partes da realidade, tornando essencial manter uma conexão contínua com dados do mundo real.
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests