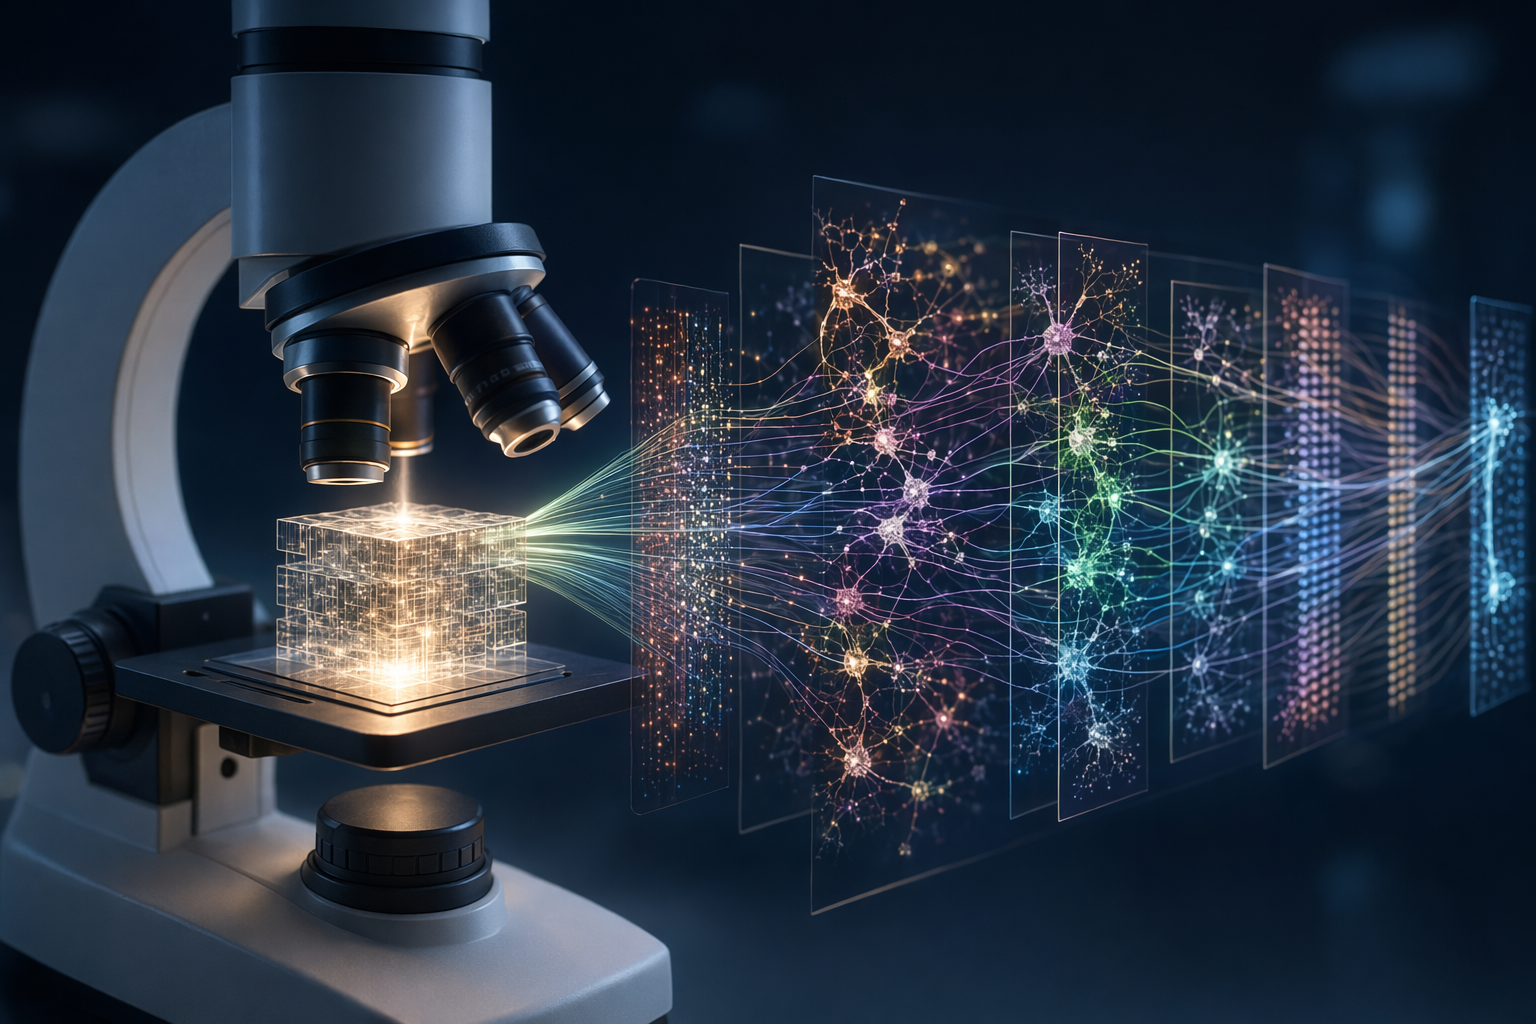
Como a Anthropic está mapeando o raciocínio oculto do Claude
A Anthropic está desenvolvendo ferramentas de interpretabilidade para tornar partes dos cálculos internos do Claude mais visíveis e testáveis [9][10]. O método identifica padrões internos chamados de “features” e tenta conectá los em “circuitos” que ajudam a explicar como entradas viram respostas [9][10].
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
A Anthropic está desenvolvendo ferramentas de interpretabilidade para tornar partes dos cálculos internos do Claude mais visíveis e testáveis [9][10].
O método identifica padrões internos chamados de “features” e tenta conectá los em “circuitos” que ajudam a explicar como entradas viram respostas [9][10].
A abordagem foi aplicada ao Claude 3.5 Haiku, mas a própria Anthropic trata os resultados como um mapa parcial, não como uma transcrição completa do que o modelo “pensa” [9][10].
Anthropic’s AI Microscope: How Claude’s Hidden Reasoning Is Being MappedAnthropic’s interpretability work aims to map parts of Claude’s internal computation into human-legible features and circuits.
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Anthropic’s AI Microscope: How Claude’s Hidden Reasoning Is Being Mapped. Article summary: Anthropic’s 2025 interpretability work tries to make Claude’s hidden reasoning legible by mapping internal activations into “features” and linking them into “circuits”; it is progress toward an AI “microscope,” not a.... Topic tags: ai, anthropic, claude, ai safety, ai transparency. Reference image context from search candidates: Reference image 1: visual subject "### Anthropic Develops AI 'Microscope' to Reveal the Hidden Mechanics of LLM Thought. Anthropic has unveiled new research tools designed to provide a rare glimpse into the hidden r" source context "Anthropic Develops AI 'Microscope' to Reveal the Hidden Mechanics of LLM Thought -- Campus Technology" Reference image 2: visual subject "Late 2024, Anthropic published a p
openai.com
A tentativa da Anthropic de entender melhor o Claude pode ser lida como um projeto de construção de instrumentos. A empresa está desenvolvendo ferramentas de interpretabilidade mecanicista — uma forma de investigar como um modelo de IA processa informação por dentro — e descreve esse avanço como parte de um caminho rumo a um “microscópio” para inteligência artificial .
A ideia é simples de explicar, embora difícil de executar: em vez de olhar apenas para a resposta final do Claude, os pesquisadores querem examinar partes dos cálculos internos que levaram até ela .
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Como a Anthropic está mapeando o raciocínio oculto do Claude"?
A Anthropic está desenvolvendo ferramentas de interpretabilidade para tornar partes dos cálculos internos do Claude mais visíveis e testáveis [9][10].
Quais são os pontos-chave para validar primeiro?
A Anthropic está desenvolvendo ferramentas de interpretabilidade para tornar partes dos cálculos internos do Claude mais visíveis e testáveis [9][10]. O método identifica padrões internos chamados de “features” e tenta conectá los em “circuitos” que ajudam a explicar como entradas viram respostas [9][10].
O que devo fazer a seguir na prática?
A abordagem foi aplicada ao Claude 3.5 Haiku, mas a própria Anthropic trata os resultados como um mapa parcial, não como uma transcrição completa do que o modelo “pensa” [9][10].
Modelos de linguagem como o Claude não vêm acompanhados de um manual legível que mostre, passo a passo, por que escolheram cada palavra. Segundo a Anthropic, as estratégias por trás das respostas ficam codificadas em “bilhões de computações” realizadas a cada palavra gerada — e esses processos são opacos até para os próprios desenvolvedores sem ferramentas específicas .
É aí que entra a metáfora do microscópio. A Anthropic não está dizendo que encontrou um parágrafo secreto com o raciocínio privado do Claude. O objetivo é criar instrumentos que permitam observar pedaços da computação que acontece por baixo das respostas escritas .
Em outras palavras: não é leitura de mente. É uma tentativa de transformar sinais internos difíceis de interpretar em estruturas que pesquisadores consigam nomear, testar e comparar .
Primeiro passo: transformar ativações em “features”
Uma parte do trabalho anterior da Anthropic se concentrou em localizar conceitos interpretáveis dentro do modelo. A empresa chama esses conceitos de features — um termo comum em aprendizado de máquina que, neste contexto, funciona como uma espécie de “alça” para um padrão de atividade interna .
Na prática, uma feature permite que os pesquisadores deixem de tratar o modelo apenas como uma parede de números opacos. Em vez disso, eles conseguem apontar para certos padrões internos, dar nomes provisórios a eles e testar em que situações aparecem .
Esse é o primeiro nível do mapa. A pergunta deixa de ser apenas “o que o Claude respondeu?” e passa a incluir “quais conceitos internos parecem ter sido ativados enquanto ele produzia essa resposta?” .
Segundo passo: conectar features em “circuitos”
O avanço mais recente está em ligar essas features em circuitos computacionais. A Anthropic descreve isso como uma extensão do trabalho de localizar conceitos internos: agora, a meta é rastrear partes do caminho que transforma as palavras de entrada nas palavras de saída do Claude .
Essa diferença importa. Uma feature isolada pode indicar que determinado conceito apareceu em algum ponto do modelo. Um circuito, por sua vez, ajuda a investigar como diferentes componentes internos influenciam uns aos outros durante a geração de uma resposta .
Para comportamentos que parecem envolver raciocínio, o trajeto pode ser tão importante quanto os conceitos individuais. Não basta saber que uma ideia apareceu; é preciso entender como ela se conectou a outras etapas do processamento .
O que a Anthropic estudou no Claude 3.5 Haiku
Em março de 2025, a Anthropic disse que estava compartilhando dois novos artigos: um deles ampliava o trabalho com features para o rastreamento de circuitos; o outro aplicava esse conjunto de ferramentas ao Claude 3.5 Haiku .
No estudo com o Claude 3.5 Haiku, a empresa analisou tarefas simples que representavam dez comportamentos considerados importantes em modelos de IA, dentro de uma abordagem que ela chamou de estudo de “biologia da IA” .
A expressão é chamativa, mas o sentido é específico. Em vez de avaliar o Claude apenas por fora — verificando se a resposta está correta, fluente ou segura — a Anthropic tenta identificar mecanismos internos que ajudem a explicar por que o modelo se comporta de determinada maneira .
Por que isso é diferente de pedir uma explicação ao Claude
Quando o Claude explica sua resposta em texto, essa explicação também é uma resposta gerada pelo próprio modelo. Já o trabalho de interpretabilidade da Anthropic mira os cálculos internos que ajudaram a produzir o texto antes de ele aparecer na tela .
Por isso, o rastreamento de circuitos oferece um tipo diferente de evidência. Não é um prompt pedindo que o modelo conte como raciocinou. É uma tentativa de inspecionar diretamente partes do caminho computacional, usando ferramentas feitas para traduzir atividade neural em estruturas mais compreensíveis para humanos .
Essa distinção é crucial para qualquer discussão sobre confiança em IA. Um modelo pode produzir uma explicação convincente, mas a pergunta científica é outra: quais mecanismos internos realmente contribuíram para aquela resposta? A pesquisa da Anthropic tenta aproximar essa pergunta de algo mensurável .
O que o método mostra — e o que ainda não mostra
O trabalho pode tornar alguns aspectos internos do Claude mais legíveis: quais features parecem relevantes, como elas se conectam e quais caminhos internos parecem participar da produção de uma resposta . Também oferece aos pesquisadores uma forma de comparar o comportamento visível do modelo com mecanismos internos, em vez de depender apenas do resultado final .
Mas a própria formulação da Anthropic é cautelosa. A empresa fala em progresso rumo a um microscópio e em revelar “partes” do caminho entre palavras de entrada e palavras de saída . Isso significa que as ferramentas atuais não devem ser tratadas como um decodificador completo de todos os cálculos do Claude, nem como uma transcrição confiável de tudo o que o modelo “pensa” internamente .
Em resumo
A Anthropic está tentando tornar o raciocínio oculto do Claude mais compreensível ao converter algumas ativações internas em features interpretáveis, rastrear como essas features interagem em circuitos e aplicar esse mapa a comportamentos concretos do modelo .
O resultado é um mapa científico parcial da computação do Claude — útil para enxergar melhor a caixa-preta, mas ainda longe de explicar cada resposta por completo .
hyper.ai
Anthropic Unveils AI's Inner Thoughts Through Model ...