RespostasPublicado25 fontes
SenseNova U1.5-Lite-Preview reúne geração 4K e edição precisa em um modelo aberto
O SenseNova U1.5 Lite Preview é um modelo multimodal aberto de 8B MoT que reúne compreensão visual, geração e edição de imagens, com saída nativa em até 4K. As demonstrações indicam uso em cartazes, infográficos, artes detalhadas, edições localizadas e composições com várias referências, com foco em textos em chinês...
Publicado porEditado com GPT-5.6 TerraImagens geradas com GPT Image 2
Resposta de pesquisa
Principais conclusões
- O SenseNova U1.5 Lite Preview é um modelo multimodal aberto de 8B MoT que reúne compreensão visual, geração e edição de imagens, com saída nativa em até 4K.
- As demonstrações indicam uso em cartazes, infográficos, artes detalhadas, edições localizadas e composições com várias referências, com foco em textos em chinês e inglês e layouts complexos.
- Pesos abertos e licença Apache 2.0 permitem testes e integração local, mas cargas de trabalho em 4K ainda demandam recursos relevantes de GPU.
Prompt de IA
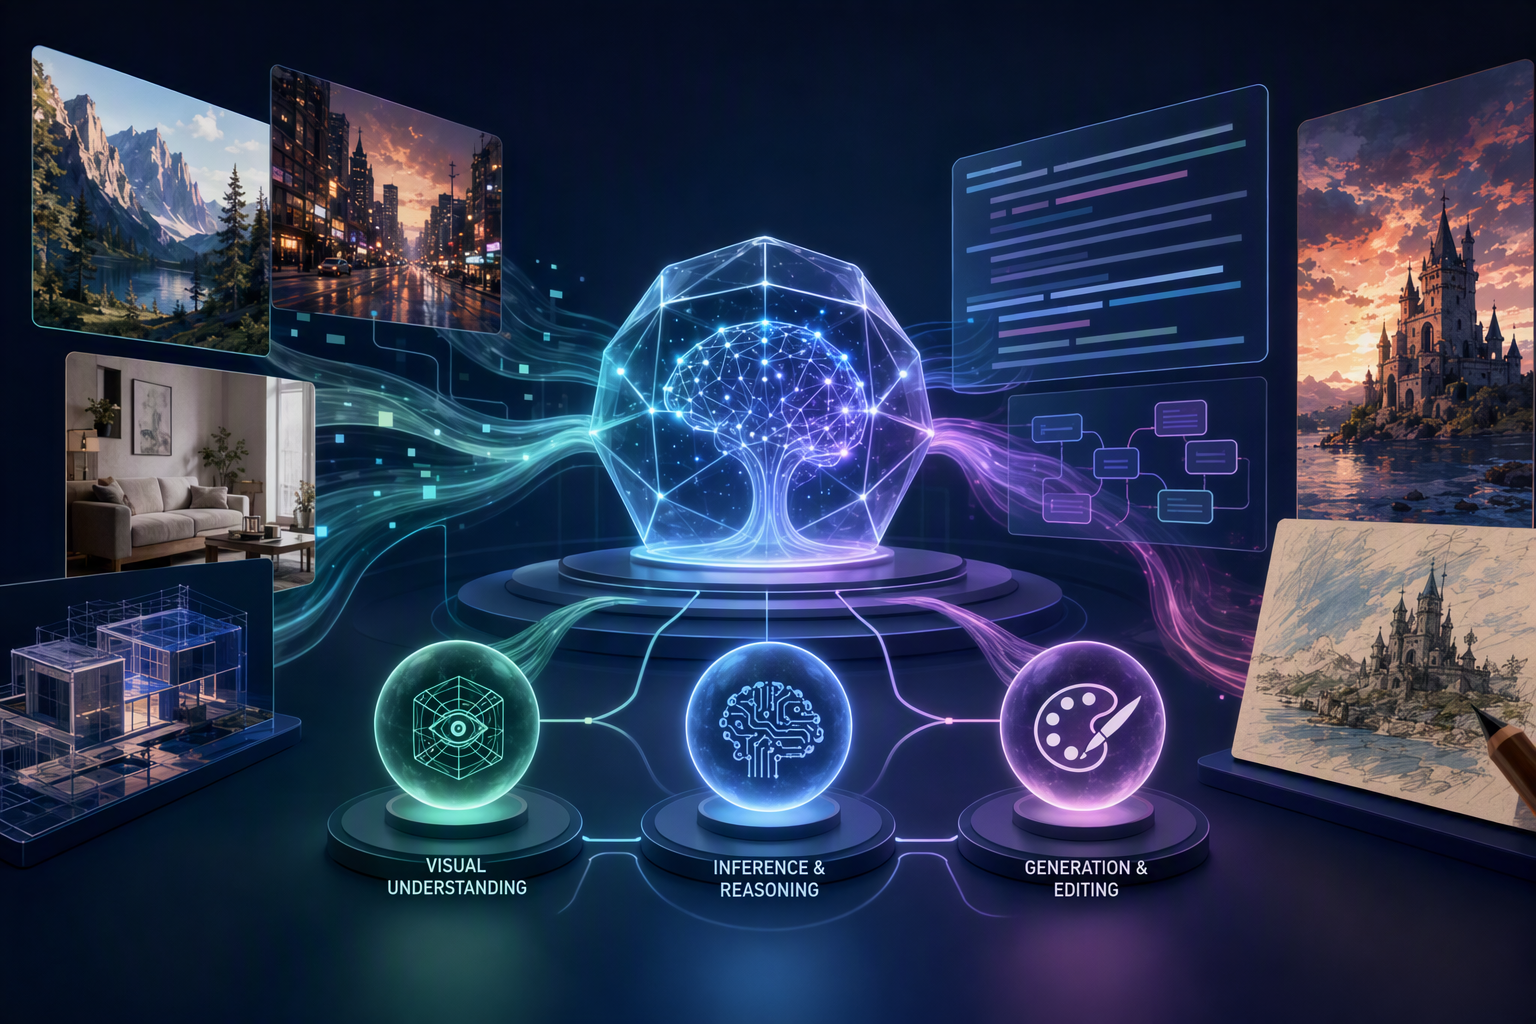
openai.comCreate a landscape editorial hero image for this Studio Global article: How does SenseTime’s open-source SenseNova U1.5-Lite-Preview—an 8B-MoT lightweight unified multimodal model based on NEO-Unify—combine langu. Article summary: SenseNova U1.5-Lite-Preview is best understood as a single, lightweight multimodal system rather than a text-to-image model with separate add-on editing tools: its NEO-Unify design joins visual understanding, inference/r. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fa
O SenseNova U1.5-Lite-Preview é um modelo aberto de imagem multimodal, com escala de 8B-MoT, baseado na arquitetura NEO-Unify da SenseTime. Sua proposta vai além de gerar uma imagem a partir de texto: o mesmo sistema foi concebido para compreender imagens e instruções, raciocinar sobre restrições visuais, gerar imagens em até 4K nativo e fazer edições controladas com uma ou mais imagens de referência. 6
9
10
Isso é especialmente relevante quando uma peça visual precisa passar por muitas revisões. Em vez de recriar todo o material a cada troca de texto, produto, pessoa ou elemento de cena, o modelo é apresentado como capaz de manter partes especificadas da composição enquanto altera a área solicitada. Como as evidências disponíveis vêm principalmente de materiais de lançamento e demonstrações, elas devem ser tratadas como indicação de capacidade pretendida — não como prova independente de qualidade consistente em produção. 2
6
O que significa ser um modelo multimodal unificado
Segundo a SenseTime, a versão preview combina compreensão visual, raciocínio, geração e edição em um único modelo baseado em NEO-Unify, na escala de 8B-MoT. 1
6 Na prática, o fluxo pode começar com um briefing textual, uma imagem existente ou várias referências, sem depender necessariamente de ferramentas separadas para interpretar, gerar, editar e ampliar imagens.
O modelo foi projetado para seguir combinações de restrições envolvendo assuntos, quantidades, relações espaciais, texto, layout e estilo visual. Ele também oferece fluxos com uma ou várias imagens de referência; relatos posteriores sobre a versão U1.5 descrevem controles por região, como caixas delimitadoras (bounding boxes) e marcadores visuais. 2
19
22
Para equipes de criação, essa diferença é importante. Um pedido como “mantenha o produto e a hierarquia da página, troque a chamada principal, mova a oferta e preserve o restante do layout” exige tanto entendimento semântico quanto geração em nível de pixels e preservação de edição. Um modelo voltado a executar isso em um único ciclo tem uma ambição diferente da de um gerador otimizado apenas para criar imagens inéditas.
Por que o 4K nativo importa
A versão preview suporta geração nativa de imagens em 4K, segundo a SenseTime e reportagens sobre o lançamento. 6
10
15 Neste caso, “nativo” quer dizer que o modelo é apresentado como capaz de criar a imagem em alta resolução diretamente, em vez de depender apenas de uma etapa posterior e separada de ampliação.
Para times criativos, o interesse prático não está só no número da resolução. Imagens grandes podem fazer diferença quando a entrega exige texturas finas, limites gráficos definidos, layouts densos ou texto inserido na própria imagem. O modelo também é posicionado em torno de melhor renderização de texto em chinês e inglês e de layouts mais complexos. 6
8
15
Isso não elimina a etapa de revisão. Textos extensos, tipografia de marca e letras miúdas — como avisos legais — ainda precisam ser conferidos contra o briefing e os arquivos aprovados antes da publicação.
O que as demonstrações indicam
As demonstrações sugerem que o SenseNova U1.5-Lite-Preview mira ativos visuais que misturam ilustração, composição, informação e iteração.
Artes detalhadas e infográficos
Os materiais de lançamento destacam texturas mais refinadas, layouts complexos e geração de texto em chinês e inglês. 6
15
36 Isso amplia os casos de uso pretendidos para além de imagens atmosféricas: cartazes, peças de marca, infográficos e materiais para redes sociais em estilo editorial são testes plausíveis para o modelo.
A questão central é se ele consegue manter a composição legível quando há muitas exigências concorrentes — título, texto de apoio, produto, elemento visual, hierarquia e detalhes de fundo. O suporte relatado a prompts com múltiplas restrições é pertinente para esse tipo de tarefa. 2
22
Recriar uma estrutura de design com conteúdo novo
Um fluxo guiado por referência pode ser útil quando uma equipe quer preservar um sistema visual, mas mudar o tema de campanha, o texto ou as imagens. O modelo suporta edição guiada por referência e múltiplas imagens de referência; materiais posteriores sobre o U1.5 também descrevem a preservação de identidade, estrutura espacial, relações de layout e áreas não editadas durante alterações direcionadas. 10
19
20
Se funcionar de forma confiável, isso é mais útil do que uma transferência genérica de estilo. A equipe poderia usar uma referência como modelo composicional, mantendo hierarquia e linguagem visual enquanto adapta o conteúdo para uma promoção, artigo ou público diferente. As fontes disponíveis estabelecem os controles e os objetivos de preservação, mas não oferecem um benchmark independente sobre a confiabilidade desse processo em briefings difíceis.
Revisões frequentes e mudanças locais
A edição controlada é a alegação mais orientada ao fluxo de trabalho. O modelo é descrito como compatível com modificações direcionadas, substituição de elementos, refinamento de texto e edição com múltiplas referências, incluindo controles por máscaras, caixas delimitadoras e marcadores visuais. 19
20
25
Na publicidade e na produção editorial, isso pode reduzir o ciclo comum de regenerar e consertar: trocar uma oferta, substituir um produto, revisar uma legenda ou alterar uma área sem descartar deliberadamente o assunto e a composição já aprovados. O potencial é maior quando o ativo já acumulou decisões de design caras de refazer.
Caracteres chineses e texto como elemento visual
A SenseTime destaca melhorias na renderização de texto em chinês e inglês e na organização de layouts complexos. 6
15 Esse foco é relevante porque, em cartazes e infográficos em chinês, o texto costuma atuar ao mesmo tempo como conteúdo e como composição.
Ainda assim, renderização melhor não equivale a precisão garantida caractere por caractere. Equipes que produzem peças públicas devem testar seus próprios idiomas, tratamentos tipográficos, exigências de densidade e processos de revisão, em vez de presumir que uma demonstração se aplica a qualquer layout.
Combinar várias referências
A edição com múltiplas imagens permite levar diversos insumos visuais ao mesmo processo de saída. O suporte relatado a várias referências e a controles regionais poderia, por exemplo, combinar a referência de um produto, de uma pessoa ou personagem, de um cenário e de uma direção de arte. 2
10
25
Para operações criativas, isso pode ser mais valioso do que usar apenas uma imagem de referência, pois briefings reais normalmente reúnem vários ativos já aprovados. O desafio não é apenas gerar um resultado visualmente coerente, mas reter os atributos corretos de cada entrada — algo que deve fazer parte da avaliação interna de cada equipe.
Por que pesos abertos importam para desenvolvedores e equipes criativas
A versão preview está disponível em canais públicos de modelos, e o projeto no Hugging Face é lançado sob a licença Apache 2.0. 6
13 Isso oferece a desenvolvedores um caminho para inspecionar, implantar, integrar e adaptar o modelo sem depender totalmente de uma API hospedada de geração de imagens.
A execução local pode ser importante para equipes que precisam de mais controle sobre imagens proprietárias de referência, rascunhos ou pipelines repetíveis. Também foi relatado um pacote oficial de nós para ComfyUI, com geração local de texto para imagem, edição com uma ou várias imagens e fluxos com controle por região. 25
Mas “leve” é um termo relativo. A classificação 8B-MoT não significa implantação trivial em um notebook, sobretudo com saída em alta resolução. A documentação oficial descreve o carregamento distribuído do modelo entre GPUs, enquanto estimativas de terceiros apontam necessidade substancial de memória para pesos em precisão total e recomendam quantização ou carregamento limitado em hardwares menores. 31
26 Hardware, latência e qualidade de saída devem, portanto, entrar no planejamento de implantação.
Como ele se posiciona diante de modelos abertos e fechados
O diferencial proposto pelo SenseNova U1.5-Lite-Preview é a combinação de disponibilidade aberta, comportamento unificado de compreender-gerar-editar, saída nativa em 4K, múltiplas referências e controles de edição voltados à preservação. 2
6
10 Para equipes que precisam hospedar o sistema, automatizar fluxos ou trabalhar com referências visuais sensíveis, esse conjunto pode pesar mais do que uma nota isolada em benchmark estético.
Ainda é cedo, porém, para classificá-lo como categoricamente superior às principais alternativas abertas ou fechadas. As evidências fornecidas não estabelecem uma comparação independente e ampla de fidelidade de texto, qualidade artística, confiabilidade de edição, velocidade, custo operacional ou segurança entre modelos. Sistemas fechados podem continuar atraentes por infraestrutura gerenciada e geração mais polida, enquanto outras ferramentas abertas podem se encaixar melhor em pipelines existentes.
Veredito prático
O SenseNova U1.5-Lite-Preview é mais interessante como ferramenta aberta de produção visual em alta resolução para trabalhos que precisam ser compreendidos, gerados e revisados sob restrições. As demonstrações apontam para cartazes, infográficos densos, composições com várias referências e variações controladas de campanha — e não apenas para a criação de imagens únicas. 6
10
15
Antes de padronizá-lo, o ideal é testá-lo com ativos reais: textos em mais de um idioma, layouts de marca consolidados, referências de produtos, edições locais difíceis e sequências de revisão em várias etapas. A medida útil não é se uma demo impressiona, e sim se o modelo preserva de forma confiável os detalhes que sua equipe não pode se dar ao luxo de perder.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
As pessoas também perguntam
Qual é a resposta curta para "SenseNova U1.5-Lite-Preview reúne geração 4K e edição precisa em um modelo aberto"?
O SenseNova U1.5 Lite Preview é um modelo multimodal aberto de 8B MoT que reúne compreensão visual, geração e edição de imagens, com saída nativa em até 4K.
Quais são os pontos-chave para validar primeiro?
O SenseNova U1.5 Lite Preview é um modelo multimodal aberto de 8B MoT que reúne compreensão visual, geração e edição de imagens, com saída nativa em até 4K. As demonstrações indicam uso em cartazes, infográficos, artes detalhadas, edições localizadas e composições com várias referências, com foco em textos em chinês e inglês e layouts complexos.
O que devo fazer a seguir na prática?
Pesos abertos e licença Apache 2.0 permitem testes e integração local, mas cargas de trabalho em 4K ainda demandam recursos relevantes de GPU.
Fontes
news.aibase.comSenseNova U1.5-Lite-Preview by SenseTime - AI NEWS
eu.36kr.comHand-Drawn Sketches to Posters
comfyui-wiki.comSenseNova-U1.5 Preview: 4K Image Generation and ...
technode.comSenseTime open-sources 8B multimodal model with native 4K image output · TechNode
aiboss88.comSenseNova U1.5-Lite-Preview - SenseTime's open-source ...