Claude Opus 4.7 vs. Opus 4.6: vale a pena atualizar agora?
O Claude Opus 4.7 aparece como uma atualização direta do Opus 4.6 no mesmo patamar de preço: segundo o LLM Stats, US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída.[8] Os ganhos públicos mais claros estão em engenharia de software avançada, agentes de IA de longa duração e visão; o LLM Sta...
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
O Claude Opus 4.7 aparece como uma atualização direta do Opus 4.6 no mesmo patamar de preço: segundo o LLM Stats, US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída.[8]
Os ganhos públicos mais claros estão em engenharia de software avançada, agentes de IA de longa duração e visão; o LLM Stats reporta 87,6% no SWE bench Verified, 6,8 pontos percentuais acima do Opus 4.6.[6][8][9]
Mesmo assim, parte dos números vem de benchmarks autorreportados pela Anthropic ou de casos internos de parceiros, então a migração deve passar por teste A/B com tarefas reais antes de ir para produção.[3][6]
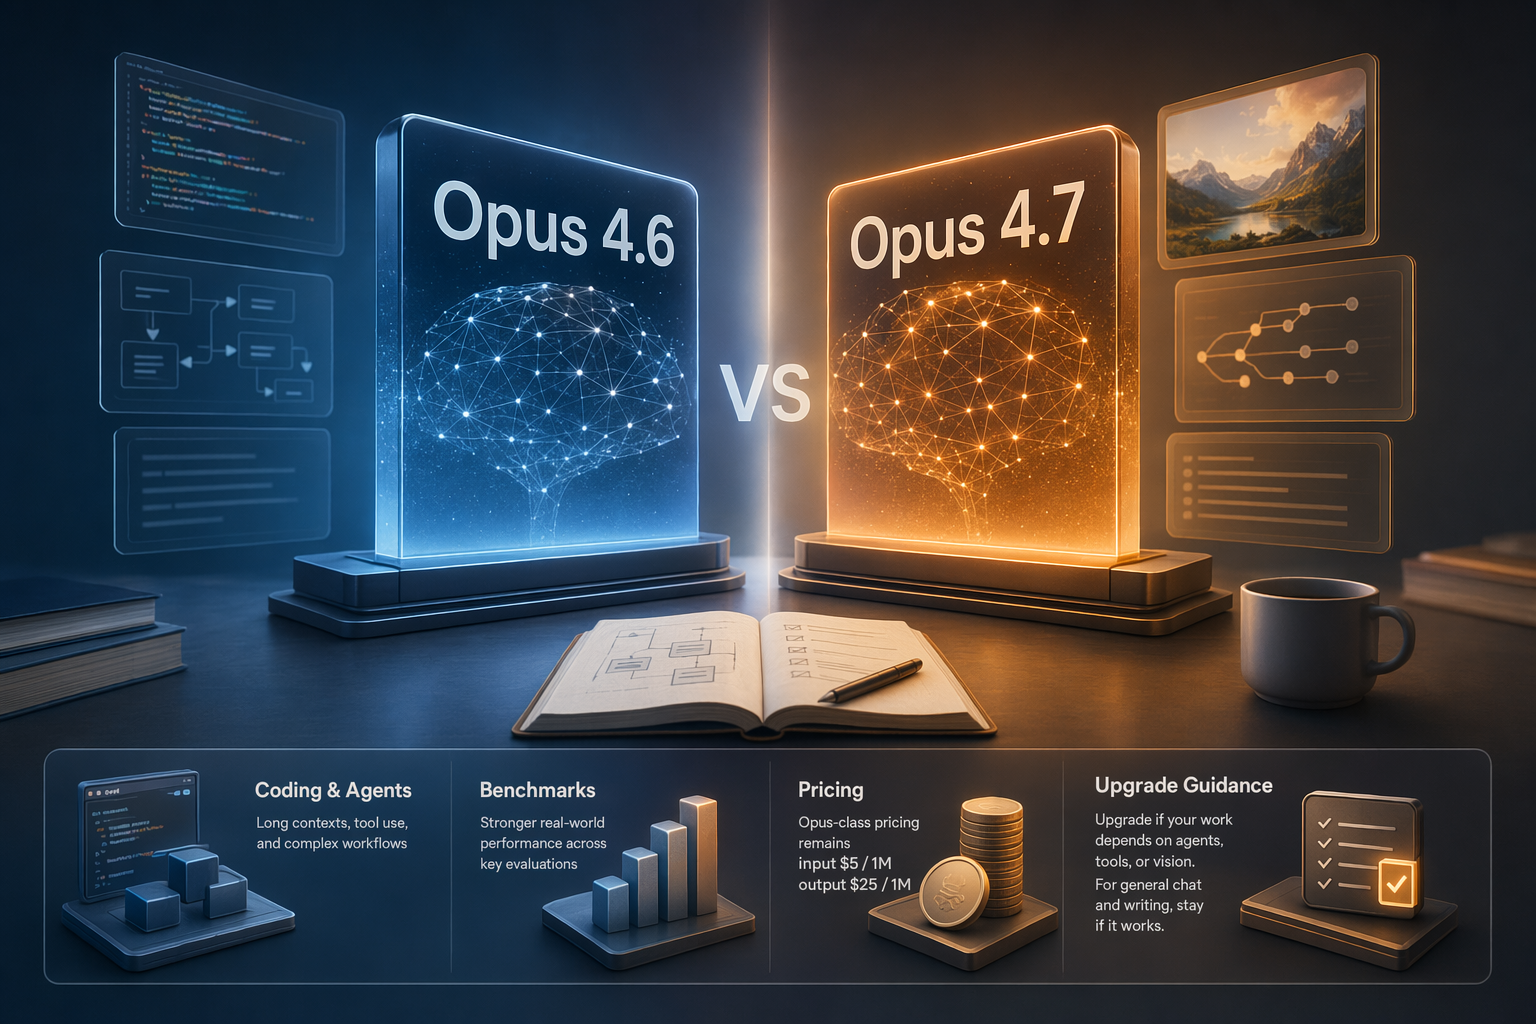
Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議AI 生成的 Claude Opus 4.7 vs Opus 4.6 比較主視覺。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議. Article summary: Claude Opus 4.7 在 2026 04 16 上線,公開資料顯示 Opus 級價格仍是每百萬 input $5、output $25;若你做 coding agent、長流程工具調用或視覺理解,值得優先試升,但一般聊天或文案不必只為版本號遷移。[6][8][9]. Topic tags: ai, anthropic, claude, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade Now? A route-first upgrade guide that compares Claude Opus 4.7 and Claude Opus 4.6 through workflow fit, benchmark" source context "Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade ..." Reference image 2: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source
openai.com
A pergunta certa sobre o Claude Opus 4.7 não é se todo mundo deve abandonar o Opus 4.6 imediatamente. A questão é mais prática: dentro da mesma faixa de modelo Opus, a versão 4.7 parece mirar com mais força fluxos de engenharia, agentes de IA e compreensão visual.
Se você usa o Opus 4.6 para programação, análise de repositórios, chamadas de ferramentas em várias etapas ou interpretação de imagens, o 4.7 merece entrar na sua fila de testes. Se o uso principal é conversa, resumo, tradução ou texto de marketing, os dados públicos ainda não sustentam uma troca automática e sem validação.
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Claude Opus 4.7 vs. Opus 4.6: vale a pena atualizar agora?"?
O Claude Opus 4.7 aparece como uma atualização direta do Opus 4.6 no mesmo patamar de preço: segundo o LLM Stats, US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída.[8]
Quais são os pontos-chave para validar primeiro?
O Claude Opus 4.7 aparece como uma atualização direta do Opus 4.6 no mesmo patamar de preço: segundo o LLM Stats, US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída.[8] Os ganhos públicos mais claros estão em engenharia de software avançada, agentes de IA de longa duração e visão; o LLM Stats reporta 87,6% no SWE bench Verified, 6,8 pontos percentuais acima do Opus 4.6.[6][8][9]
O que devo fazer a seguir na prática?
Mesmo assim, parte dos números vem de benchmarks autorreportados pela Anthropic ou de casos internos de parceiros, então a migração deve passar por teste A/B com tarefas reais antes de ir para produção.[3][6]
O LLM Stats lista o lançamento do Opus 4.7 em 16 de abril de 2026; a página da Anthropic informa que desenvolvedores podem usar claude-opus-4-7 pela Claude API.
Já dá para planejar testes reais, não apenas esperar uma prévia.
Preço
O LLM Stats descreve o Opus 4.7 como upgrade direto do 4.6, mantendo US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída.
A troca não exige aceitar um preço por token mais alto, embora o custo final dependa do uso.
Programação e engenharia de software
A Anthropic posiciona o 4.7 como mais forte em engenharia de software avançada, especialmente nas tarefas difíceis; o LLM Stats reporta 87,6% no SWE-bench Verified, 6,8 pontos percentuais acima do 4.6.
É o caso mais óbvio para testar primeiro: correção de bugs, refatoração, análise de repositório e agentes de coding.
Tarefas longas e agentes
O LLM Stats cita melhorias de autoverificação em trabalho agente de longa duração; a Anthropic também aponta tarefas longas como área de avanço.
Visão
A Anthropic afirma que a visão do 4.7 é significativamente melhor e aceita imagens de resolução mais alta; o LLM Stats fala em suporte a imagens cerca de 3,3× maior.
Novos controles
Levantamentos de terceiros mencionam xhigh effort e Task Budgets, recursos mais voltados a agentes e coding.
Como ler os benchmarks sem exagerar a conclusão
Os benchmarks apontam uma direção clara: o Opus 4.7 foi pensado para melhorar tarefas difíceis de programação, fluxos agentic — isto é, agentes que planejam, chamam ferramentas e executam várias etapas — e uso com imagens. O LLM Stats diz que o modelo chegou a 87,6% no SWE-bench Verified, 6,8 pontos percentuais acima do Opus 4.6, e que venceu o 4.6 em 12 de 14 benchmarks reportados.
Isso é relevante, mas não deve ser lido como garantia universal. O próprio LLM Stats observa que os benchmarks são autorreportados pela Anthropic; a Verdent AI também ressalta que exemplos citados da Notion e da Rakuten envolvem, respectivamente, um cenário interno de parceiro e um benchmark proprietário, não um experimento público e padronizado de controle.
Em outras palavras: os dados sustentam a hipótese de que o Opus 4.7 é melhor para coding difícil, agentes longos e visão em alta resolução. Eles não provam que todos os seus prompts, integrações e fluxos em produção vão melhorar automaticamente. O ganho real depende do seu conjunto de tarefas, formato dos dados, ferramentas conectadas, tolerância a latência e custo de falha.
Preço: o token custa o mesmo, mas a conta final pode mudar
Pelos dados públicos compilados, Opus 4.7 e Opus 4.6 têm o mesmo preço de modelo Opus: US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída. Isso reduz a barreira para experimentar, porque a troca não começa com aumento direto no preço por token.
Mas a conta de produção não é feita só de preço unitário. Se o 4.7 gerar respostas mais longas, fizer menos ou mais tentativas, ou se você passar a usar controles como effort e orçamentos de tarefa, o custo total pode mudar. O inverso também é possível: se ele reduzir retrabalho humano, erros de ferramenta ou reexecuções, o custo por tarefa concluída pode cair.
Por isso, compare o custo para completar a mesma tarefa, não apenas o preço por milhão de tokens.
Quem deve testar o Opus 4.7 primeiro
O upgrade é mais urgente para estes perfis:
Times de engenharia e agentes de coding: se você já usa o 4.6 para analisar repositórios, corrigir bugs, consertar testes, refatorar múltiplos arquivos ou revisar código, os avanços públicos do 4.7 se concentram justamente em engenharia de software avançada e tarefas difíceis de programação.
Fluxos longos com chamada de ferramentas: se o agente precisa planejar, consultar ferramentas, verificar resultados e corrigir rota ao longo de várias etapas, as melhorias em tarefas longas e autoverificação merecem teste.
Produtos que dependem de entrada visual: se o modelo precisa entender screenshots de UI, tabelas, documentos escaneados, diagramas ou especificações visuais, o ganho em visão e resolução pode ser perceptível.
Equipes que já pagam por modelos Opus: como a compilação pública aponta o mesmo preço unitário entre 4.6 e 4.7, o custo de testar a migração tende a ser mais fácil de justificar.
Quem pode esperar
Se o uso principal é conversa geral, resumo, tradução, revisão de texto, copywriting ou perguntas e respostas simples, não há motivo forte para migrar só por causa do número da versão. As evidências públicas mais específicas estão concentradas em coding, agentes e visão; para tarefas de conteúdo mais comuns, ainda falta prova de um salto igualmente claro.
Também vale ir com calma se seus prompts de produção foram ajustados durante muito tempo para o Opus 4.6 e dependem de formato fixo, tom muito consistente ou estabilidade em casos de borda. Mesmo quando um modelo novo é mais capaz, ele pode mudar estilo de resposta, distribuição de erros e comportamento em instruções ambíguas. Nesse caso, o caminho mais seguro é uma migração gradual.
Checklist de teste A/B antes de migrar
Em vez de trocar tudo de uma vez, rode o Opus 4.7 lado a lado com o 4.6 usando tarefas reais:
Monte uma amostra representativa: inclua casos que hoje funcionam bem, casos em que o 4.6 costuma falhar, tarefas longas e tarefas de alto valor.
Mantenha prompt e ferramentas iguais: mude apenas o modelo sempre que possível. Assim você evita atribuir ao 4.7 uma melhoria causada por ajuste de prompt.
Meça resultado por tarefa: acompanhe taxa de sucesso, tempo de correção humana, erros de ferramenta, tokens de entrada e saída, número de retentativas e latência.
Teste xhigh separadamente: o xhigh effort aparece em levantamentos sobre o 4.7, mas não deve ser assumido como melhor para todo caso. Compare com configurações padrão.
Separe os testes de visão: se imagem importa, use screenshots, tabelas, documentos escaneados e diagramas reais, não apenas figuras simples de demonstração.
Mantenha fallback para o 4.6: em produção, comece com uma fatia pequena de tráfego e amplie só depois de validar qualidade, custo e latência.
Veredito
Para engenharia de software, agentes de IA e visão, o Claude Opus 4.7 é um candidato de alta prioridade para upgrade. O fato de manter o mesmo preço unitário reportado para o Opus 4.6 torna o teste ainda mais razoável.
Para conversa geral, resumo e geração de conteúdo, o 4.7 pode até ser melhor, mas os dados públicos disponíveis não bastam para justificar uma migração imediata só pelo nome da versão.
A recomendação mais segura é tratar o Opus 4.7 como um upgrade para testar cedo, não como substituto cego. Rode seus próprios A/B tests com tarefas reais, compare sucesso, estabilidade de formato, custo e latência, e só então decida se vale trocar o Opus 4.6 em produção.
verdent.aiClaude Opus 4.7 vs 4.6: Agentic Coding Comparison - Verdent AI
llm-stats.comClaude Opus 4.7 vs Opus 4.6 - LLM Stats
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
help.apiyi.comClaude Opus 4.7 VS 4.6 Comprehensive Comparison