AnswersPublished26 sources
Samsung zHBM: HBM ułożona bezpośrednio na akceleratorze AI
Samsung twierdzi, że zHBM może zwiększyć szybkość odpowiedzi systemów AI ponad 10 krotnie dzięki ułożeniu pamięci HBM bezpośrednio nad akceleratorem AI. Firma zakłada, że interfejs wykorzystujący zHBM osiągnie około 8 razy wyższą wydajność niż HBM5, ponad 10 razy większą gęstość pamięci, 3 razy lepszą efektywność en...
Opublikowane przezEdytowane za pomocą GPT-5.6 TerraObrazy wygenerowane za pomocą GPT Image 2
Research answer
Key takeaways
- Samsung twierdzi, że zHBM może zwiększyć szybkość odpowiedzi systemów AI ponad 10 krotnie dzięki ułożeniu pamięci HBM bezpośrednio nad akceleratorem AI.
- Firma zakłada, że interfejs wykorzystujący zHBM osiągnie około 8 razy wyższą wydajność niż HBM5, ponad 10 razy większą gęstość pamięci, 3 razy lepszą efektywność energetyczną i ponad 50% niższą rezystancję cieplną.
- Inżynierowie OpenAI i Intela ocenili, że CXL lepiej nadaje się do zwiększania pojemności i przechowywania rzadziej używanych danych niż do zastąpienia HBM podczas aktywnego wykonywania modeli AI.
AI Prompt
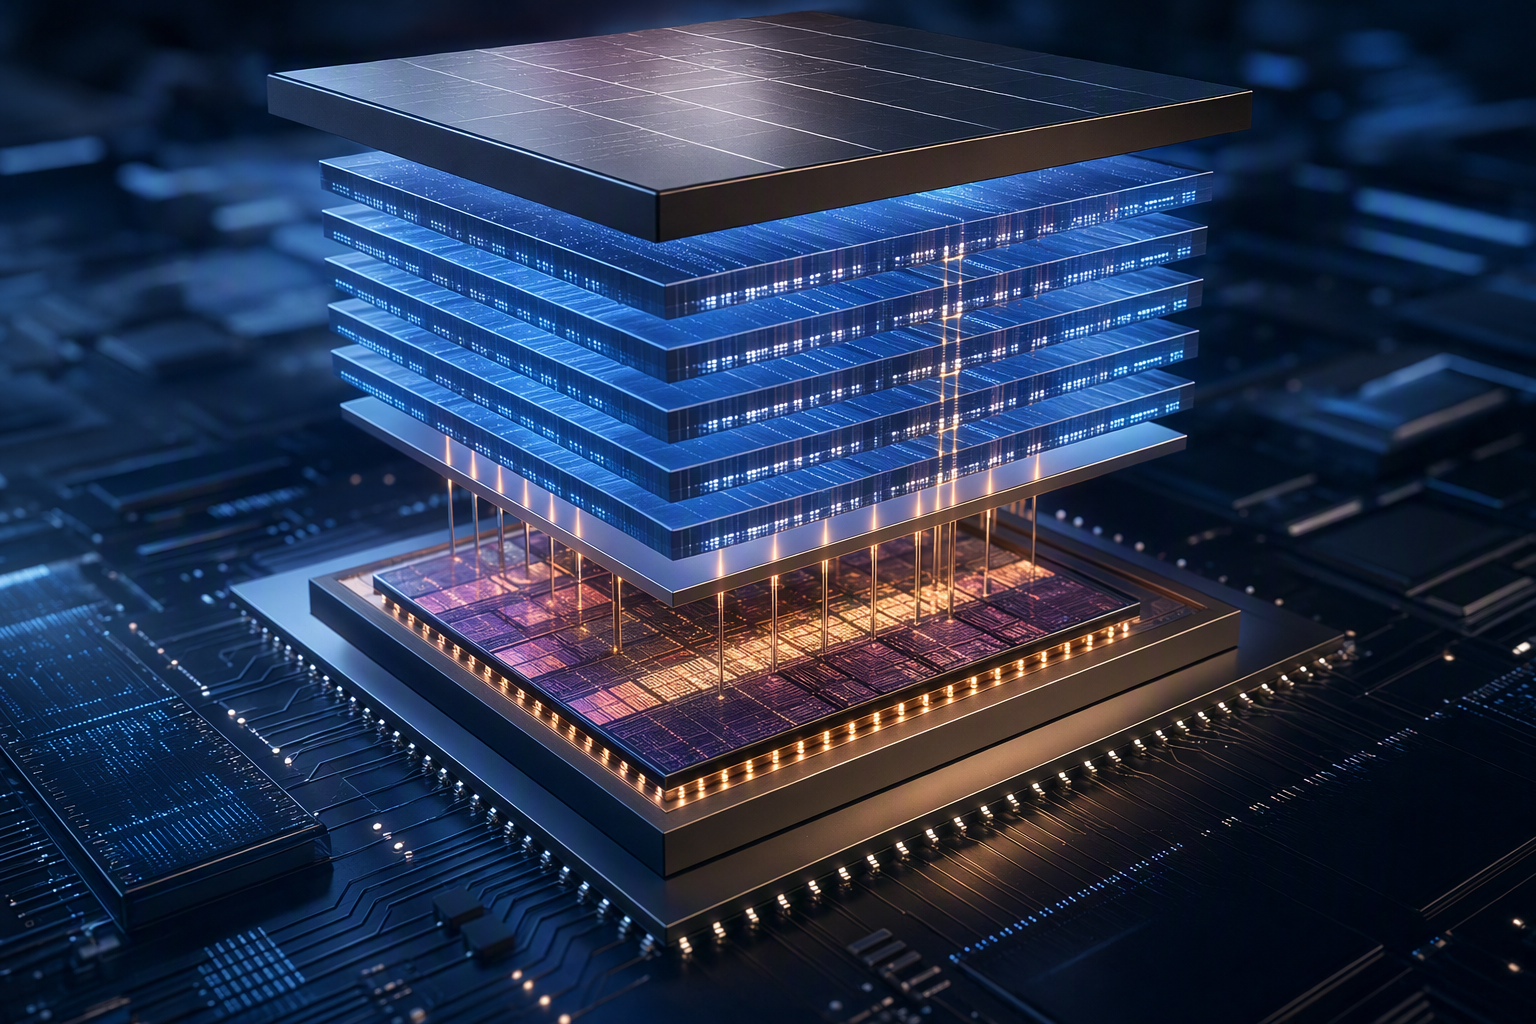
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Samsung proponuje w zHBM istotną zmianę w budowie pamięci dla AI: zamiast umieszczać pamięć HBM (high-bandwidth memory, pamięć o wysokiej przepustowości) obok GPU lub innego akceleratora, chce ułożyć ją pionowo, bezpośrednio nad procesorem. Na AI Infrastructure Summit, który odbył się 16 września w Santa Clara, firma przedstawiła ten kierunek jako sposób na przyspieszenie systemów opartych na agentach AI. 1
9
Czym zHBM różni się od obecnych pakietów 2.5D?
W typowym rozwiązaniu HBM znajduje się obok akceleratora na tej samej płaszczyźnie, a połączenie zapewnia zaawansowane pakowanie układów. W koncepcji zHBM moduły HBM są umieszczone nad akceleratorem AI. Samsung opisuje to jako trójwymiarową integrację logiki i pamięci. 12
13
Najważniejsza korzyść jest intuicyjna: krótsza fizyczna droga danych może zwiększyć przepustowość i efektywność energetyczną, a zarazem pozwolić zmieścić więcej pamięci na tej samej powierzchni. Do wykonania takiej integracji firma zamierza wykorzystać techniki łączenia wafli, w tym hybrydowe łączenie miedzią. 7
48
Nie jest to jednak produkt zastępujący obecne pakiety HBM już dziś. Samsung pokazał zHBM jako model koncepcyjny i nie podał terminu komercjalizacji. 13
14
Deklarowane zyski: duże liczby, ale jeszcze nie niezależne testy
Dla interfejsu nowej generacji z zHBM Samsung wskazuje następujące cele względem konwencjonalnej HBM5:
- około 8 razy wyższa wydajność,
- ponad 10 razy większa gęstość pamięci,
- około 3 razy lepsza efektywność energetyczna,
- ponad 50% niższa rezystancja cieplna.
13
48
Podczas AI Infrastructure Summit firma mówiła także o możliwości przyspieszenia odpowiedzi systemów AI ponad dziesięciokrotnie, z ambicją dojścia do 1000 tokenów na sekundę. 1
9
To są jednak prognozy producenta dotyczące przyszłej architektury, a nie niezależnie potwierdzone wyniki dostępnego na rynku akceleratora. Pamięć ułożona bezpośrednio nad logiką musi jeszcze osiągnąć odpowiednią uzyskiwalność produkcyjną, niezawodność i parametry cieplne, a następnie przejść kwalifikację u partnerów tworzących akceleratory.
Dlaczego ma to znaczenie dla agentów AI?
Samsung prezentował zHBM w kontekście agentów AI. Takie systemy wielokrotnie pobierają kontekst, wykonują wnioskowanie, korzystają z narzędzi i generują kolejne odpowiedzi. Sam wzrost mocy obliczeniowej nie wystarczy, jeśli akcelerator czeka na przesłanie danych.
zHBM ma ograniczać właśnie to wąskie gardło związane z pamięcią i przesyłem danych. Założenie jest takie, że zbliżenie HBM do akceleratora poprawi responsywność systemu i obniży energię potrzebną do przenoszenia danych. 1
7 Osiągnięcie deklarowanych przyspieszeń całego systemu będzie jednak zależeć również od akceleratora, oprogramowania, modelu i projektu pakietu — nie wyłącznie od położenia pamięci.
zNAND-O: pojemniejsza warstwa obok DRAM
Wraz z zHBM Samsung zaprezentował zNAND-O — wysokowydajną architekturę NAND przeznaczoną dla środowisk intensywnie przetwarzających dane oraz AI na urządzeniu brzegowym. Rozwiązanie ma tworzyć warstwę pomiędzy DRAM a klasyczną pamięcią masową NAND: oferować większą gęstość niż DRAM, a jednocześnie poprawiać wydajność wejścia/wyjścia, opóźnienia i efektywność energetyczną względem zwykłej NAND. 49
51
Oba rozwiązania mają inne zadania w hierarchii pamięci:
- zHBM ma być najszybszą warstwą pamięci, umieszczoną tuż przy akceleratorze;
- zNAND-O ma zapewnić pojemniejszą warstwę dla danych i modeli, których trzymanie w całości w DRAM byłoby kosztowne.
49
53
Samsung przytoczył test modelu GPT z 120 mld parametrów, w którym zNAND-O uzyskała taką samą liczbę tokenów na sekundę jak konwencjonalny serwer z DRAM przy koszcie operacyjnym równym jednej szóstej. To zgłoszony przez firmę wynik testu, a nie uniwersalna gwarancja kosztowa dla wdrożeń dużych modeli. 54
55
Firma wiąże zNAND-O także z długofalowym wyzwaniem uruchamiania bardzo dużych modeli bezpośrednio na urządzeniach. Według Samsunga modele lokalne o skali biliona parametrów mogą stać się istotne około 2030 r. 53
CXL raczej nie zastąpi HBM w aktywnym wykonywaniu modeli
Na tym samym szczycie wybrzmiało ważne rozróżnienie: dodatkowa pojemność pamięci jest cenna, lecz nie oznacza, że każdy jej rodzaj jest wymienny.
Daniel Morris, badacz akceleratorów w OpenAI, powiedział, że nie znalazł zastosowania CXL (Compute Express Link) do faktycznego uruchamiania modeli AI. Widział natomiast możliwą rolę tej technologii dla rzadko używanych danych w dużych modelach. Vidia Thiagarajan z Intela podobnie ocenił łączenie pamięci przez CXL jako uzupełnienie pamięci wtórnej, a nie zamiennik HBM, wskazując na różnicę przepustowości między pamięcią podłączoną przez CXL a HBM. 18
22
Nie znaczy to, że CXL nie ma zastosowań. Bardziej prawdopodobna wydaje się architektura warstwowa: HBM blisko akceleratora dla aktywnych obliczeń wrażliwych na przepustowość, a CXL oraz inne warstwy pamięci i magazynowania danych — dla pojemności.
Co to oznacza dla Samsunga i SK hynix?
W krótkim terminie rywalizacja w HBM nadal zależy od zdolności do produkcji, kwalifikacji i dostaw pamięci dla konkretnych platform akceleratorów. zHBM daje Samsungowi wyróżniającą się wizję na dalszą przyszłość, ale nie usuwa potrzeby udowodnienia uzysku, zachowania termicznego, niezawodności i integracji u klientów.
Dla całego rynku HBM sceptycyzm wobec tezy, że CXL może zastąpić lokalną HBM w aktywnym wykonywaniu modeli, wzmacnia znaczenie pamięci o wysokiej przepustowości umieszczonej przy akceleratorze. Kluczowe pytanie brzmi więc nie tylko, kto przedstawi najodważniejszą koncepcję pamięci 3D, lecz także kto pierwszy zamieni zaawansowane pakowanie i projekt pamięci w kwalifikowany produkt dostarczany na dużą skalę. 18
33
36
Wniosek
Przekaz Samsunga jest jasny: wydajność AI coraz częściej ogranicza nie tylko moc obliczeniowa, ale również transfer danych, pojemność pamięci, energia i ciepło. zHBM proponuje bezpośrednie, trójwymiarowe połączenie pamięci z akceleratorem, a zNAND-O ma dodać gęstszą warstwę dla większych obciążeń AI.
Potencjalne korzyści są znaczące, lecz pozostają celami technologii na etapie koncepcji. Dla kupujących infrastrukturę AI ważniejszy od perspektywy szybkiej premiery zHBM jest dziś kierunek rozwoju: systemy AI prawdopodobnie będą korzystać z coraz bardziej wyspecjalizowanych, pionowo integrowanych warstw pamięci, a HBM pozostanie kluczowa na ścieżce najwyższej wydajności. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: HBM ułożona bezpośrednio na akceleratorze AI"?
Samsung twierdzi, że zHBM może zwiększyć szybkość odpowiedzi systemów AI ponad 10 krotnie dzięki ułożeniu pamięci HBM bezpośrednio nad akceleratorem AI.
What are the key points to validate first?
Samsung twierdzi, że zHBM może zwiększyć szybkość odpowiedzi systemów AI ponad 10 krotnie dzięki ułożeniu pamięci HBM bezpośrednio nad akceleratorem AI. Firma zakłada, że interfejs wykorzystujący zHBM osiągnie około 8 razy wyższą wydajność niż HBM5, ponad 10 razy większą gęstość pamięci, 3 razy lepszą efektywność energetyczną i ponad 50% niższą rezystancję cieplną.
What should I do next in practice?
Inżynierowie OpenAI i Intela ocenili, że CXL lepiej nadaje się do zwiększania pojemności i przechowywania rzadziej używanych danych niż do zastąpienia HBM podczas aktywnego wykonywania modeli AI.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push