Dlaczego Hermes uparcie przełącza się na fallback — i jak raz na zawsze pozbyć się tego komunikatu
To nie błąd aplikacji, lecz celowe zachowanie Hermesa. Gdy główny provider napotyka rate limit (HTTP 429), błąd serwera lub awarię autoryzacji, agent automatycznie przełącza się na model zapasowy, np.
Opublikowane przezObrazy wygenerowane za pomocą GPT Image 1.5
To nie błąd aplikacji, lecz celowe zachowanie Hermesa. Gdy główny provider napotyka rate limit (HTTP 429), błąd serwera lub awarię autoryzacji, agent automatycznie przełącza się na model zapasowy, np.
Problem leży zazwyczaj w warstwie gatewaya lub w konfiguracji. Jeśli zarówno primary, jak i fallback korzystają z tego samego dostawcy lub pól kluczy API, które są przeciążone, zmiana modelu nie rozwiąże problemu — ob...
Kluczowe pliki do weryfikacji to config.yaml z listą fallback providers oraz konfiguracja endpointów niestandardowych.
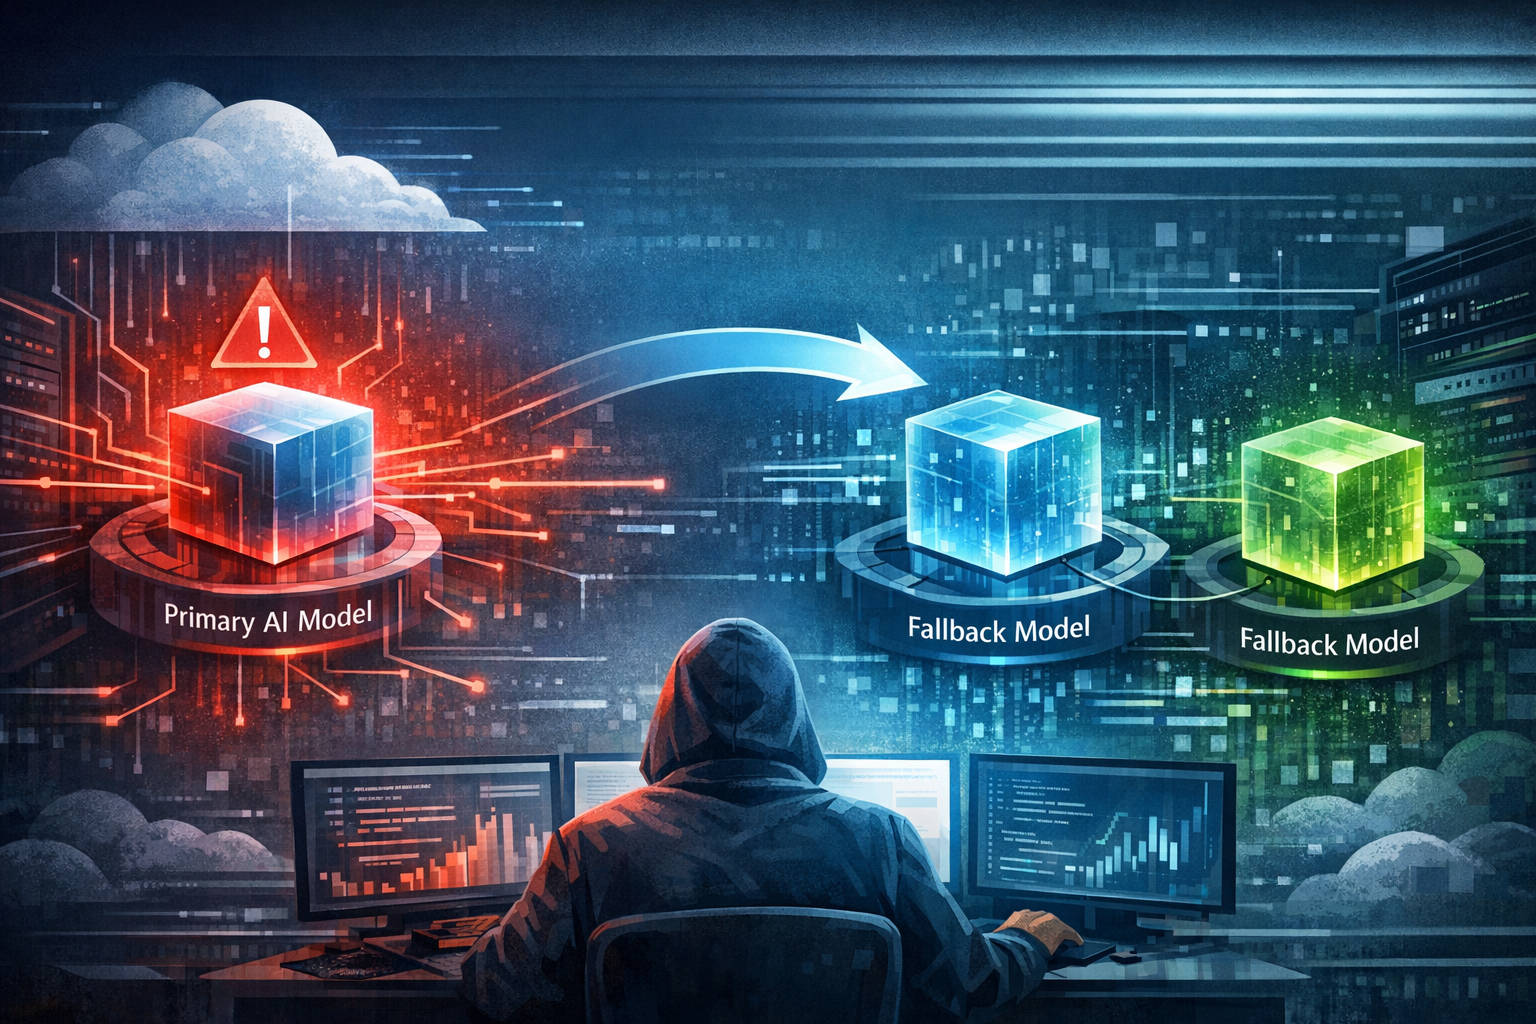
⚠️ Rate limited — switching to fallback providerAI-generated editorial hero image for ⚠️ Rate limited — switching to fallback provider... 🔄 Primary model failed — switching to fallback: sg claude opus 4.7 via custom Sao cứ bị.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: ⚠️ Rate limited — switching to fallback provider... 🔄 Primary model failed — switching to fallback: sg claude opus 4.7 via custom Sao cứ bị. Article summary: Đây không hẳn là “bug fallback”, mà là model chính của Sếp đang bị rate limit nên Hermes tự nhảy sang fallback sg claude opus 4.7 via custom đúng như thiết kế.[8] Vì fallback của Hermes là per turn, nên mỗi tin nhắn mới . Topic tags: general web, openai, llm, ai, workflow. Reference image context from search candidates: Reference image 1: visual subject "# Fallback Providers. ## Primary Model Fallback. When your main LLM provider encounters errors — rate limits, server overload, auth failures, connection drops — Hermes can automat" source context "Fallback Providers | Hermes Agent - nous research" Reference image 2: visual subject "March 18, 2026 - (rate_limit
openai.com
Wielu użytkowników Hermes Agent napotyka irytujący, powtarzający się komunikat: „⚠️ Rate limited — switching to fallback provider... 🔄 Primary model failed — switching to fallback: sg claude opus 4.7 via custom”. Wbrew pozorom, to nie jest awaria systemu fallback — to Hermes działający dokładnie tak, jak został zaprojektowany .
Co naprawdę oznacza ten komunikat?
Gdy główny dostawca LLM (tzw. provider) zwraca błąd — a najczęściej jest to limit żądań HTTP 429, przeciążenie serwera, awaria autoryzacji lub zerwane połączenie — Hermes automatycznie przełącza sesję na zapasową parę provider:model. Dzieje się to bez utraty kontekstu rozmowy .
Mechanizm fallback w Hermesie jest jednak , czyli dotyczy tylko bieżącej wiadomości. Przy następnym zapytaniu agent ponownie próbuje użyć modelu głównego. Jeśli źródłowy limit wciąż obowiązuje, proces się powtarza — i stąd właśnie ta pozorna „pętla” komunikatów .
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "Dlaczego Hermes uparcie przełącza się na fallback — i jak raz na zawsze pozbyć się tego komunikatu"?
To nie błąd aplikacji, lecz celowe zachowanie Hermesa. Gdy główny provider napotyka rate limit (HTTP 429), błąd serwera lub awarię autoryzacji, agent automatycznie przełącza się na model zapasowy, np.
What are the key points to validate first?
To nie błąd aplikacji, lecz celowe zachowanie Hermesa. Gdy główny provider napotyka rate limit (HTTP 429), błąd serwera lub awarię autoryzacji, agent automatycznie przełącza się na model zapasowy, np. Problem leży zazwyczaj w warstwie gatewaya lub w konfiguracji. Jeśli zarówno primary, jak i fallback korzystają z tego samego dostawcy lub pól kluczy API, które są przeciążone, zmiana modelu nie rozwiąże problemu — ob...
What should I do next in practice?
Kluczowe pliki do weryfikacji to config.yaml z listą fallback providers oraz konfiguracja endpointów niestandardowych.
Oznacza to, że dopóki Twój główny provider nie odzyska pełnej przepustowości (albo nie zmienisz jego konfiguracji), będziesz otrzymywać ten alert za każdym razem, gdy wyślesz nową wiadomość.
Dlaczego problem się powtarza — główne przyczyny
1. Rzeczywisty rate limit na poziomie dostawcy
Najprostsza przyczyna: Twój klucz API lub konto u danego dostawcy faktycznie wyczerpało limit żądań. OpenClaw (gateway często współpracujący z Hermesem) wyraźnie klasyfikuje błędy HTTP 429 jako problemy z limitem na poziomie upstream, które trzeba diagnozować po stronie gatewaya, a nie w interfejsie użytkownika .
Dodatkowo, komunikaty 429 mogą dotyczyć tzw. długich kontekstów (ang. long context requests). Jeśli wysyłasz bardzo rozbudowane prompty, upstream może odrzucić zapytanie ze wskazaniem: „Extra usage is required for long context requests” .
2. Wspólna pula kluczy lub ten sam backend
Kluczowe znaczenie ma konfiguracja w pliku config.yaml (zwykle ~/.hermes/config.yaml). Jeśli zarówno primary, jak i fallback — w tym przypadku sg-claude-opus-4.7 via custom — korzystają z tego samego dostawcy, tej samej bramki lub współdzielonych kluczy API, przełączenie na model zapasowy nie ominie blokady. Obie ścieżki będą obciążać ten sam przeciążony zasób .
Według dokumentacji Hermesa, niestandardowe endpointy („custom endpoint”) są zapisywane w config.yaml, a łańcuch fallback definiuje się pod kluczem fallback_providers. Jeśli Twój primary i sg-claude-opus-4.7 via custom wskazują de facto na tę samą infrastrukturę, zmiana modelu niewiele pomoże.
3. Fałszywy alert o limicie — błąd gatewaya
Zdarzają się też sytuacje, gdy API działa poprawnie (testowane poza OpenClaw czy Hermesem), a sam gateway błędnie raportuje limit. Problem ten był zgłaszany m.in. na GitHubie jako fałszywy komunikat o wyczerpaniu limitu API wynikający z mechanizmu cooldown wewnątrz OpenClaw . W takich przypadkach kluczowe jest uruchomienie diagnostyki gatewaya.
Jak skutecznie naprawić problem — lista kontrolna
Krok 1: Zidentyfikuj swój główny model i łańcuch fallback
Otwórz plik config.yaml i sprawdź:
Jaki model jest ustawiony jako primary.
Jakie pary provider:model widnieją na liście fallback_providers.
Gdzie wskazuje niestandardowy endpoint używany przez sg-claude-opus-4.7 via custom.
Jeśli primary i fallback korzystają z tego samego providera (np. oba przez OpenRouter albo oba przez ten sam klucz Anthropic), problem leży właśnie tutaj.
Krok 2: Zweryfikuj, czy dostawca faktycznie odrzuca żądania
Jeśli korzystasz z OpenClaw jako gatewaya, uruchom:
openclaw gateway probe
To polecenie pokaże, czy bramka jest osiągalna i jakie ma uprawnienia. Szukaj konkretnych kodów błędów: HTTP 429, RESOURCE_EXHAUSTED, wzmianek o retry-after.
Przetestuj też ten sam klucz API poza ekosystemem OpenClaw/Hermes — na przykład za pomocą Claude Code lub Qwen Code. Jeśli tam działa, przyczyna leży w gatewayu .
Krok 3: Sprawdź długość kontekstu
Jeśli błąd 429 pojawia się wyłącznie przy dłuższych rozmowach, przyczyną może być polityka dostawcy dotycząca długich kontekstów. OpenClaw w dokumentacji wyraźnie wskazuje, że „Extra usage is required for long context requests” jest częstą przyczyną limitu 429 . Rozważ podzielenie bardzo długich promptów lub użycie modelu z wyższym limitem tokenów.
Krok 4: Popraw konfigurację kluczy i zmiennych środowiskowych
Jeśli gateway działa jako usługa systemowa (systemd/launchd), klucze API najlepiej umieszczać w pliku ~/.openclaw/.env, aby demon mógł je odczytać. Po każdej zmianie kluczy lub konfiguracji zrestartuj gateway:
systemctl restart openclaw-gateway   # dla systemd
# lub
launchctl kickstart -k gui/$(id -u)/com.openclaw.gateway   # dla launchd
Aby fallback faktycznie ratował sytuację, powinien wskazywać na innego dostawcę (np. OpenRouter z modelem Claude) lub na osobny klucz API z oddzielnym limitem. Możesz dodać zapasowy provider przez:
Daje to więcej czasu na odpowiedź przy dużym obciążeniu .
Podsumowanie
Powtarzający się komunikat o przełączeniu na fallback nie jest wadą systemu — to symptom nierozwiązanego problemu z głównym dostawcą. Hermes działa tu dokładnie tak, jak powinien: przy każdym nowym zapytaniu próbuje wrócić do primary, a gdy limit nadal obowiązuje, elegancko przechodzi na model zapasowy .
Dopóki nie usuniesz źródłowej przyczyny (przeciążony klucz, błędna konfiguracja gatewaya, zbyt długie konteksty), alert będzie powracał. Zacznij od sprawdzenia config.yaml, porównania puli kluczy między primary a fallbackiem i diagnostyki gatewaya. W większości przypadków rozwiązaniem jest albo prawdziwie niezależny fallback, albo przerzucenie ruchu na mniej obciążony klucz API.
Jeśli potrzebujesz dokładnej pomocy przy analizie konkretnego pliku konfiguracyjnego — pokaż, który model jest primary, gdzie wskazuje custom endpoint i jakie masz wpisy w fallback_providers. Pomożemy zdiagnozować to raz-dwa.
hermes-agent.nousresearch.comFallback Providers | Hermes Agent - nous research
docs.openclaw.aiGeneral troubleshooting - OpenClaw Docs
github.com[Bug]: False 'API rate limit reached' on all models despite ... - GitHub