AnswersPublished15 sources
Wspólny model dla kodu w ośmiu językach: architektura, która zna swoje ograniczenia
Proponowana architektura obejmuje TypeScript, Javę, C , Pythona, Rusta, Go, C i C++ — bez uruchamiania analizowanego kodu. Adaptery językowe mają przekładać różnice składniowe na wspólny model deklaracji, zależności, warunków i dowodów pochodzenia.
Opublikowane przezObrazy wygenerowane za pomocą GPT Image 2
Research answer
Key takeaways
- Proponowana architektura obejmuje TypeScript, Javę, C , Pythona, Rusta, Go, C i C++ — bez uruchamiania analizowanego kodu.
- Adaptery językowe mają przekładać różnice składniowe na wspólny model deklaracji, zależności, warunków i dowodów pochodzenia.
- Limit 24 576 bajtów dotyczy pojedynczej ramki, a nie gwarancji, że dowolny projekt zmieści się w całości.
- Dane historyczne z projektu pokazują ramkę o rozmiarze 18 869 bajtów, ale nie dowodzą pełnego odtworzenia semantyki ani wyników dla ośmiu języków.
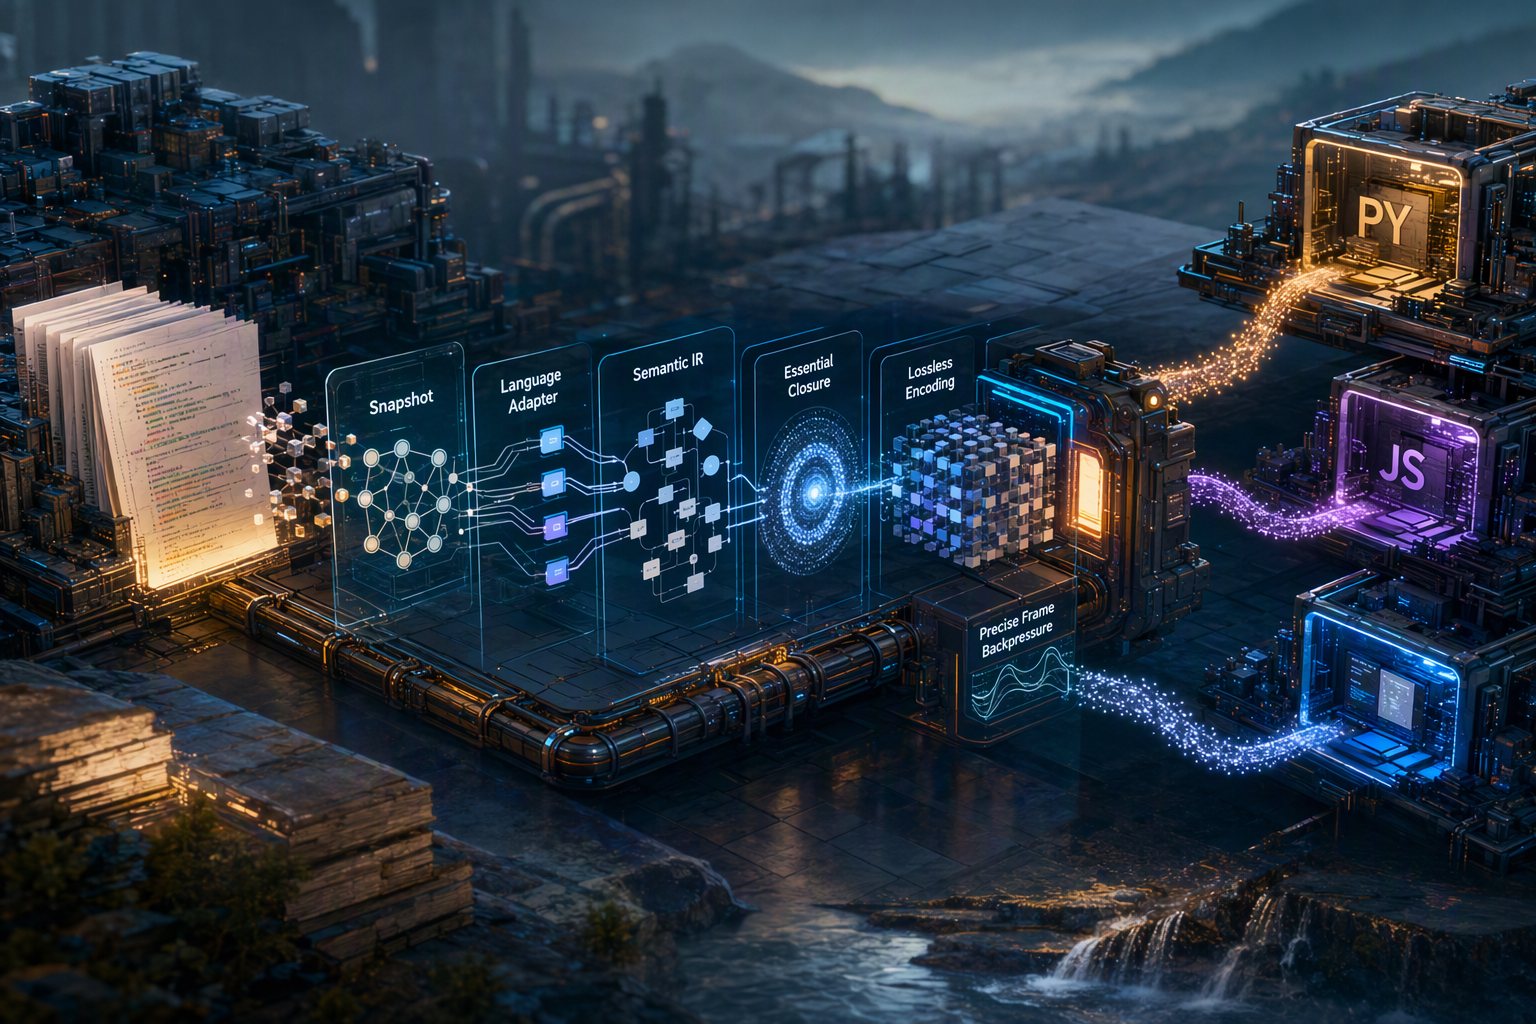
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Najpierw granice, potem kompresja
Projekt zakłada wspólny sposób opisywania kodu w TypeScript, Javie, C#, Pythonie, Ruście, Go, C i C++. Brzmi jak zadanie dla jednego uniwersalnego analizatora, ale propozycja stawia na podział odpowiedzialności: osobny adapter rozpoznaje składnię danego języka, a wspólny mechanizm porządkuje wyniki i pilnuje, by nie zgubić informacji uznanych za niezbędne.
Ważne zastrzeżenie: to propozycja architektury, a nie potwierdzenie, że osiem adapterów już powstało i przeszło testy. Celem jest kompletność określonego zakresu statycznych informacji, nie rekonstrukcja całego zachowania dowolnego programu.
Taki podział ma praktyczne znaczenie. System ma nie uruchamiać analizowanego kodu ani jego skryptów budowania, nie wymagać na maszynie docelowej ciężkich narzędzi, takich jak kompilatory czy SDK, i nie korzystać z trenowania modeli. Jednocześnie jego własne, prekompilowane komponenty parsujące nadal trzeba traktować jako zależności wymagające kontroli wersji, pochodzenia i bezpieczeństwa.
Od składni do wspólnego modelu
Proponowany przepływ zaczyna się od autoryzowanego, tylko do odczytu obrazu plików. Adapter językowy rozpoznaje w nim między innymi deklaracje, importy, widoczność, warunki i miejsca wywołań. Wynik trafia do wspólnego modelu pośredniego, który opisuje cztery główne rodzaje elementów: pakiet lub przestrzeń nazw, moduł lub plik, deklarację kontraktu oraz element wywoływalny, taki jak funkcja czy metoda.
Model ma też zapisywać relacje, na przykład zależności, implementacje i wywołania. Kluczowa jest różnica między tym, co widać w pliku, a tym, czego można dowieść: zapis wywołania nie przesądza, że dana funkcja zostanie uruchomiona, a deklaracja relacji nie gwarantuje, że zaakceptuje ją kompilator. Gdy statyczna analiza nie rozstrzyga celu, system powinien zachować tekst odniesienia i oznaczyć go jako nierozpoznany, zamiast zgadywać.
Jako podstawę parsowania rozważany jest Tree-sitter. Potrafi on budować konkretne drzewo składniowe, czyli strukturalny zapis elementów pliku; nie jest jednak zamiennikiem kompilatora ani pełnej analizy semantycznej. 11 Zapytania Tree-sitter dopasowują konkretne typy węzłów drzewa, dlatego przed wdrożeniem adaptera trzeba zweryfikować gramatykę i jej schemat, a nie zakładać, że jedno zapytanie zadziała w każdym języku.
16
Widoczność nie jest jednym przełącznikiem
„Publiczne” nie znaczy tego samego w każdym języku. W TypeScripcie trzeba odróżniać eksporty typów i wartości, a także sam eksport modułu od tego, czy dana ścieżka jest dostępna jako wejście pakietu. Dokumentacja TypeScript opisuje między innymi eksporty nazwane i eksport domyślny; osobno wyjaśnia też eksporty dotyczące wyłącznie typów. 3
7 Z kolei reguły wejść pakietu wymagają uwzględnienia konfiguracji, takiej jak pole
exports. 8
W innych językach znaczenie mają odmienne reguły: dostępność elementów wewnątrz kontenera, widoczność przez moduły, ograniczenia eksportu albo konwencje nazw. Sama nazwa zaczynająca się od podkreślenia nie powinna być automatycznie traktowana jako twarda kontrola dostępu. Podobnie publiczny członek w niedostępnym kontenerze nie musi być publiczny dla odbiorcy z zewnątrz.
Dlatego model ma rozdzielać zadeklarowany poziom dostępu, potencjalnego odbiorcę, warunki oraz siłę dowodu. Niepewna widoczność powinna pozostać niepewna. Jeśli przez taką ostrożność niezbędny zakres okaże się zbyt duży, system ma zgłosić problem, a nie uznać niewygodny element za prywatny.
Budżet bajtów bez „magicznej” obietnicy
Dane historyczne z projektu pokazują, że w jednym raporcie ramka miała 18 869 bajtów. Ten sam zapis wymieniał 79 importów, 84 definicje i 79 statycznych odniesień do zależności, ale również 751 pominiętych wyrażeń wywołań. Wynik dotyczył więc częściowego przekazania informacji, a nie kompletnej semantyki programu. Historyczny raport wymieniał także 40 zaliczonych testów określonego zestawu regresyjnego; nie oznacza to, że w tej rundzie ponownie wykonano testy ani że była to całość testów projektu.
Proponowany limit fizyczny to 24 576 bajtów na ramkę. W praktyce liczyć trzeba całą wiadomość: nie tylko właściwe rekordy, lecz także opakowanie, ucieczkę znaków, diagnostykę i zakończenie. Istniejące limity wcześniejszego formatu nie znikają automatycznie — w propozycji wskazano między innymi osobny limit 22 016 bajtów dla wariantu V2 A.
Gdy zabraknie miejsca, system powinien zachować nienaruszony zestaw informacji niezbędnych do realizacji zadania, a elementy opcjonalne wyraźnie oznaczyć jako pominięte. Jeżeli sam niezbędny zakres przekracza limit, prawidłowym wynikiem jest blokada i czytelna przyczyna — nie ciche usunięcie deklaracji ani podniesienie limitu.
To nie jest wada kompresji, tylko granica pojemności. Dowolnie duży zbiór różniących się informacji nie może być zawsze bezstratnie zapisany w jednej ramce o stałym rozmiarze. Możliwe są wtedy inne, osobno uzgodnione sposoby dostarczenia, na przykład podział na części, ale nie wolno przedstawiać ich jako pełnej wiedzy zawartej w pojedynczej ramce.
Plan wdrażania i warunki zaufania
Proponowana droga prowadzi od adaptera Pythona i zgodności ze starszymi interfejsami, przez TypeScript i Go, następnie Javę i C#, aż po Rusta, C i C++. Każdy etap ma wymagać niezależnych przykładów kontrolnych, testów przypadków negatywnych, sprawdzenia pochodzenia danych i pomiaru całej ramki. Dla języków, których specyfikacji i gramatyk nie zweryfikowano, produkcyjne wdrożenie pozostaje warunkowe.
Plan zakłada również niezależną ocenę wyniku. Ten sam komponent nie powinien być jedynym źródłem zarówno ekstrakcji, jak i odpowiedzi, czy ekstrakcja była poprawna. Osobny konsument ma odtworzyć zakodowane dane, sprawdzić referencje i porównać je z zamrożonym zestawem oczekiwanych deklaracji.
Najuczciwsza obietnica tej architektury jest więc dość konkretna: zachować uzgodniony zakres statycznych informacji, oznaczać niewiadome i nie przekraczać limitu ramki. Nie obiecywać, że każdy projekt — niezależnie od rozmiaru, konfiguracji i użytych mechanizmów języka — zmieści się bez strat w 24 576 bajtach.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Wspólny model dla kodu w ośmiu językach: architektura, która zna swoje ograniczenia"?
Proponowana architektura obejmuje TypeScript, Javę, C , Pythona, Rusta, Go, C i C++ — bez uruchamiania analizowanego kodu.
What are the key points to validate first?
Proponowana architektura obejmuje TypeScript, Javę, C , Pythona, Rusta, Go, C i C++ — bez uruchamiania analizowanego kodu. Adaptery językowe mają przekładać różnice składniowe na wspólny model deklaracji, zależności, warunków i dowodów pochodzenia.
What should I do next in practice?
Limit 24 576 bajtów dotyczy pojedynczej ramki, a nie gwarancji, że dowolny projekt zmieści się w całości.