AnswersPublished26 sources
Samsung zHBM: Minne rett på AI-brikken kan endre flaskehalsen
Samsung sier zHBM kan øke AI systemers responshastighet med mer enn 10 ganger ved å stable HBM direkte over en AI akselerator, i stedet for ved siden av den. Selskapet anslår rundt 8 ganger HBM5 ytelse, over 10 ganger minnetetthet, 3 ganger energieffektivitet og mer enn 50 prosent lavere termisk motstand enn konvens...
Publisert avRedigert med GPT-5.6 TerraBilder generert med GPT Image 2
Research answer
Key takeaways
- Samsung sier zHBM kan øke AI systemers responshastighet med mer enn 10 ganger ved å stable HBM direkte over en AI akselerator, i stedet for ved siden av den.
- Selskapet anslår rundt 8 ganger HBM5 ytelse, over 10 ganger minnetetthet, 3 ganger energieffektivitet og mer enn 50 prosent lavere termisk motstand enn konvensjonell HBM5.
- Ingeniører fra OpenAI og Intel mener CXL først og fremst kan utfylle HBM med ekstra kapasitet og mindre aktiv data, ikke erstatte HBM under aktiv AI kjøring.
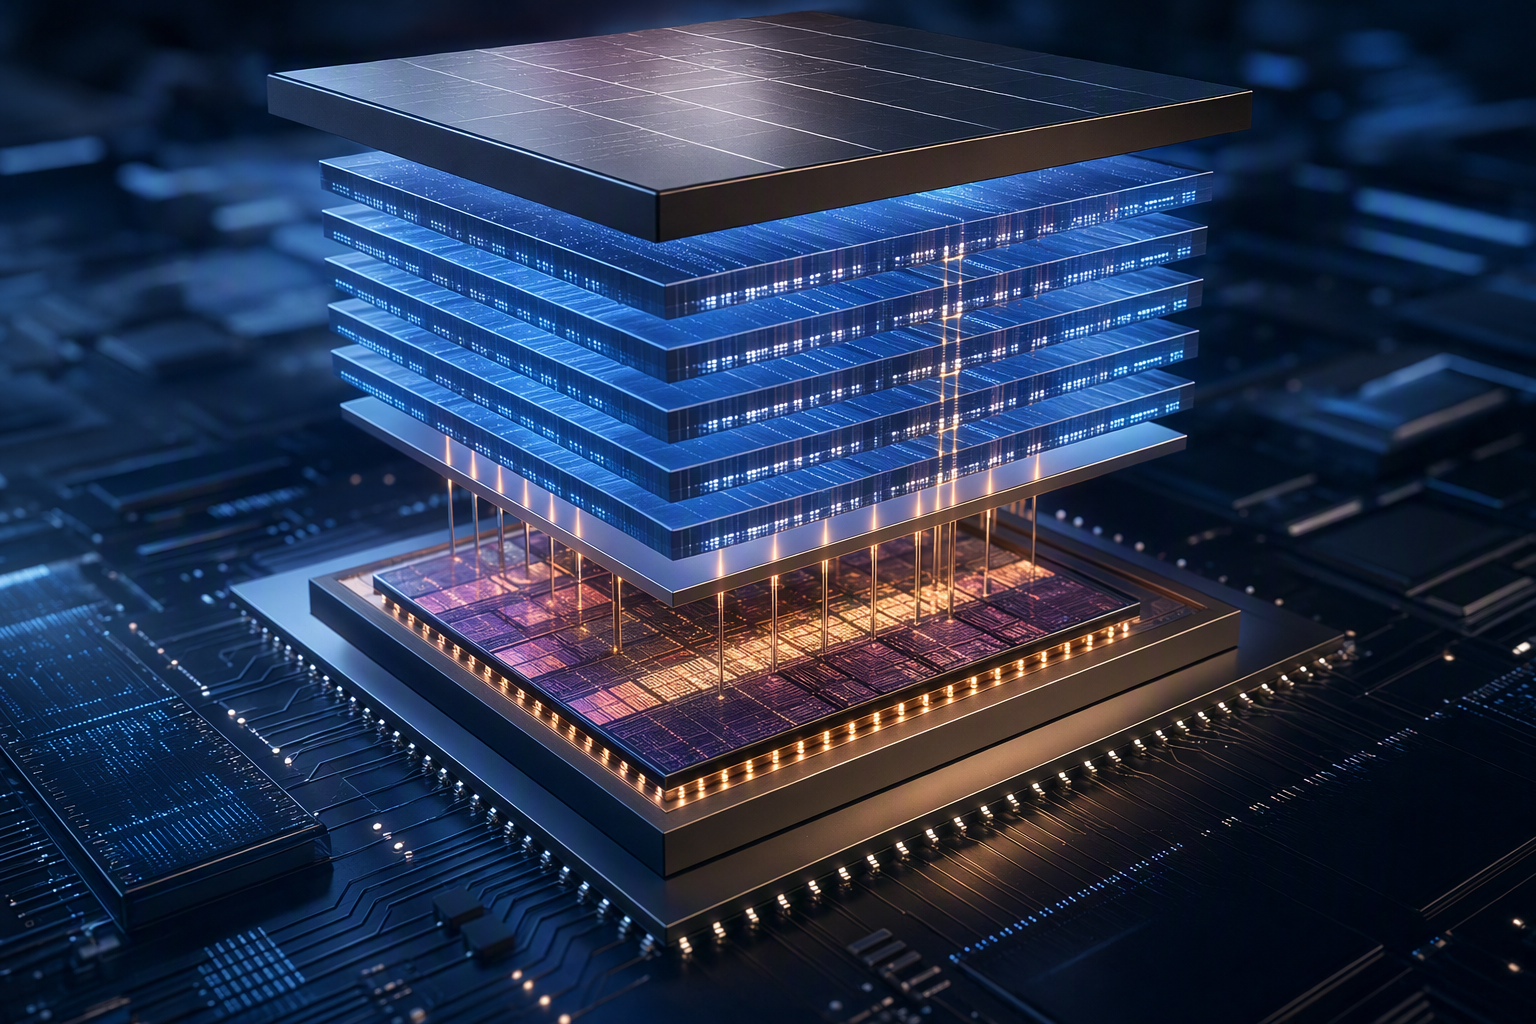
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Samsung vil flytte det raskeste minnet i AI-maskiner helt inntil selve regnekraften – bokstavelig talt. Med konseptet zHBM skal høybåndbreddeminne (HBM) stables direkte over en AI-akselerator i en vertikal 3D-pakke. På AI Infrastructure Summit i Santa Clara 16. september presenterte Samsung dette som en mulig vei mot mer responsive AI-agenter. 1
9
Fra side om side til minne over prosessoren
I dagens vanlige HBM-løsninger ligger minnebrikkene typisk ved siden av GPU-en eller en annen AI-akselerator i samme plan, koblet sammen gjennom avansert pakking. zHBM snur dette til en vertikal konstruksjon: HBM plasseres direkte over prosessoren. 12
13
Hensikten er enkel: Når data skal tilbakelegge kortere avstand, kan båndbredden øke og energibruken til dataflytting reduseres. Samtidig kan mer minne få plass på et gitt areal. Samsung oppgir at løsningen bygger på neste generasjons wafer-bonding, blant annet hybrid kobberbinding, for å få til den tette 3D-integrasjonen. 7
48
Dette er foreløpig ikke et produkt som erstatter dagens HBM-pakker. Samsung har vist zHBM som en konseptmodell og har ikke oppgitt noen kommersialiseringsplan. 13
14
Store tall – men foreløpig målsettinger
Samsung oppgir følgende mål for et framtidig grensesnittsystem med zHBM:
- Omtrent 8 ganger ytelsen til HBM5
- Over 10 ganger minnetettheten til konvensjonell HBM5
- Omtrent 3 ganger energieffektiviteten
- Over 50 prosent lavere termisk motstand
13
48
På toppmøtet sa Samsung også at zHBM kan løfte AI-systemers responshastighet med mer enn ti ganger, med en uttalt ambisjon om 1 000 token per sekund. Et token er en liten tekst- eller dataenhet som språkmodeller behandler når de genererer svar. 1
9
Tallene er selskapets egne anslag for en framtidig arkitektur, ikke uavhengig verifiserte resultater fra en kommersiell akselerator. Å legge minnet direkte over logikken skaper dessuten krevende spørsmål om produksjonsutbytte, varmehåndtering, driftssikkerhet og samspill med kundenes akseleratorer.
Hvorfor Samsung knytter zHBM til AI-agenter
Samsung presenterte zHBM i sammenheng med AI-agenter: systemer som gjentatte ganger må hente kontekst, kjøre inferens, bruke verktøy og generere nye svar. Mer regnekraft alene hjelper ikke fullt ut dersom akseleratoren stadig må vente på data fra minnet.
zHBM er ment å angripe nettopp denne flaskehalsen i minne og dataflytting. Tanken er at HBM tettere på akseleratoren kan gjøre AI-systemer mer responsive og samtidig bruke mindre strøm på å flytte data. 1
7 Om det faktisk gir de varslede gevinstene for hele systemet, avhenger imidlertid også av akseleratoren, programvaren, modellen og resten av pakkedesignet – ikke bare av hvor minnet ligger.
zNAND-O skal gi en tettere minneklasse
Samsung viste også zNAND-O, en høyytelses NAND-arkitektur rettet mot datatunge miljøer og edge-AI. Den er plassert mellom DRAM og vanlig NAND-lagring i minnehierarkiet: Målet er høyere tetthet enn DRAM, men bedre I/O-ytelse, lavere forsinkelse og bedre energieffektivitet enn konvensjonell NAND. 49
51
De to teknologiene har ulike roller:
- zHBM er tenkt som det aller raskeste minnelaget, tett på AI-akseleratoren.
- zNAND-O er tenkt som et tettere lag for data og modellkapasitet som ville vært kostbar å ha fullt ut i DRAM.
49
53
Samsung viste til en test med en GPT-modell med 120 milliarder parametere, der zNAND-O skal ha nådd samme tokenhastighet som en tradisjonell DRAM-server til en sjettedel av driftskostnaden. Det er et Samsung-rapportert testresultat, ikke en generell kostnadsgaranti for store AI-installasjoner. 54
55
Selskapet har også koblet zNAND-O til en langsiktig utfordring: svært store AI-modeller som kjører lokalt på enheten. Samsung har sagt at AI på enheter med modeller i størrelsesorden én billion parametere kan bli aktuelt innen 2030. 53
CXL ser ikke ut til å overta rollen til HBM
På samme konferanse ble et viktig skille i AI-minnemarkedet tydelig: Mer minnekapasitet er nyttig, men det betyr ikke at alle minnetyper kan brukes om hverandre.
Daniel Morris, som arbeider med AI-akseleratorer i OpenAI, sa at han ikke hadde funnet et CXL-bruksområde for å kjøre AI-modeller direkte. Han pekte likevel på mulig nytte for data som sjelden brukes i store modeller. Vidia Thiagarajan i Intel beskrev på sin side CXL-basert minnepooling som et supplement til sekundærlagring, ikke som en HBM-erstatter, fordi CXL-tilkoblet minne har klart lavere båndbredde enn HBM. 18
22
CXL, eller Compute Express Link, er en standard for å koble og dele ressurser som minne mellom komponenter. Den kan fortsatt få en rolle, men mest sannsynlig i et lagdelt oppsett: HBM nær akseleratoren for aktiv, båndbreddekrevende beregning, og CXL eller andre minne- og lagringslag for kapasitet og data som ikke brukes kontinuerlig.
Hva dette betyr for Samsung, SK hynix og HBM-racet
På kort sikt avgjøres HBM-konkurransen fortsatt av hvem som kan produsere, kvalifisere og levere minne til konkrete akseleratorplattformer. zHBM gir Samsung et særpreget langsiktig arkitekturspor, men fritar ikke selskapet fra å dokumentere utbytte, temperaturkontroll, pålitelighet og integrasjon hos kundene.
Skepsisen til at CXL kan erstatte lokal HBM når modellen kjører aktivt, styrker samtidig betydningen av høybåndbreddeminne tett på akseleratoren. For Samsung, SK hynix og øvrige aktører blir spørsmålet derfor ikke bare hvem som presenterer det mest ambisiøse 3D-konseptet, men hvem som først kan gjøre avansert minne og pakking om til kvalifiserte produkter i stort volum. 18
33
36
Kort oppsummert
Samsungs budskap er at AI-ytelse i stadig større grad begrenses av minneflytting, kapasitet, strømforbruk og varme – ikke bare av rå regnekraft. zHBM er et forslag til å møte disse begrensningene med minne direkte over akseleratoren, mens zNAND-O skal gi et tettere lag for større AI-arbeidslaster.
Potensialet i Samsungs tall er stort, men teknologien er fortsatt på konseptstadiet. Den viktigste konklusjonen for dem som planlegger AI-infrastruktur, er derfor retningen: AI-maskiner vil trolig få stadig mer spesialiserte og vertikalt integrerte minnelag, og HBM ser ut til å beholde en nøkkelrolle i den mest ytelseskritiske delen av systemet. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: Minne rett på AI-brikken kan endre flaskehalsen"?
Samsung sier zHBM kan øke AI systemers responshastighet med mer enn 10 ganger ved å stable HBM direkte over en AI akselerator, i stedet for ved siden av den.
What are the key points to validate first?
Samsung sier zHBM kan øke AI systemers responshastighet med mer enn 10 ganger ved å stable HBM direkte over en AI akselerator, i stedet for ved siden av den. Selskapet anslår rundt 8 ganger HBM5 ytelse, over 10 ganger minnetetthet, 3 ganger energieffektivitet og mer enn 50 prosent lavere termisk motstand enn konvensjonell HBM5.
What should I do next in practice?
Ingeniører fra OpenAI og Intel mener CXL først og fremst kan utfylle HBM med ekstra kapasitet og mindre aktiv data, ikke erstatte HBM under aktiv AI kjøring.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push