Google DeepMind SL2T: Slik gjør Pixel 11 tegnspråk om til tekst
Google DeepMinds SL2T (sign language to text) er den første AI modellen for tegnspråktolking som lanseres i et forbrukerprodukt – på Pixel 11 familien via Gboard og Live Transcribe.
Publisert avRedigert med DeepSeek-V4-FlashBilder generert med GPT Image 1.5
Google DeepMinds SL2T (sign language to text) er den første AI modellen for tegnspråktolking som lanseres i et forbrukerprodukt – på Pixel 11 familien via Gboard og Live Transcribe.
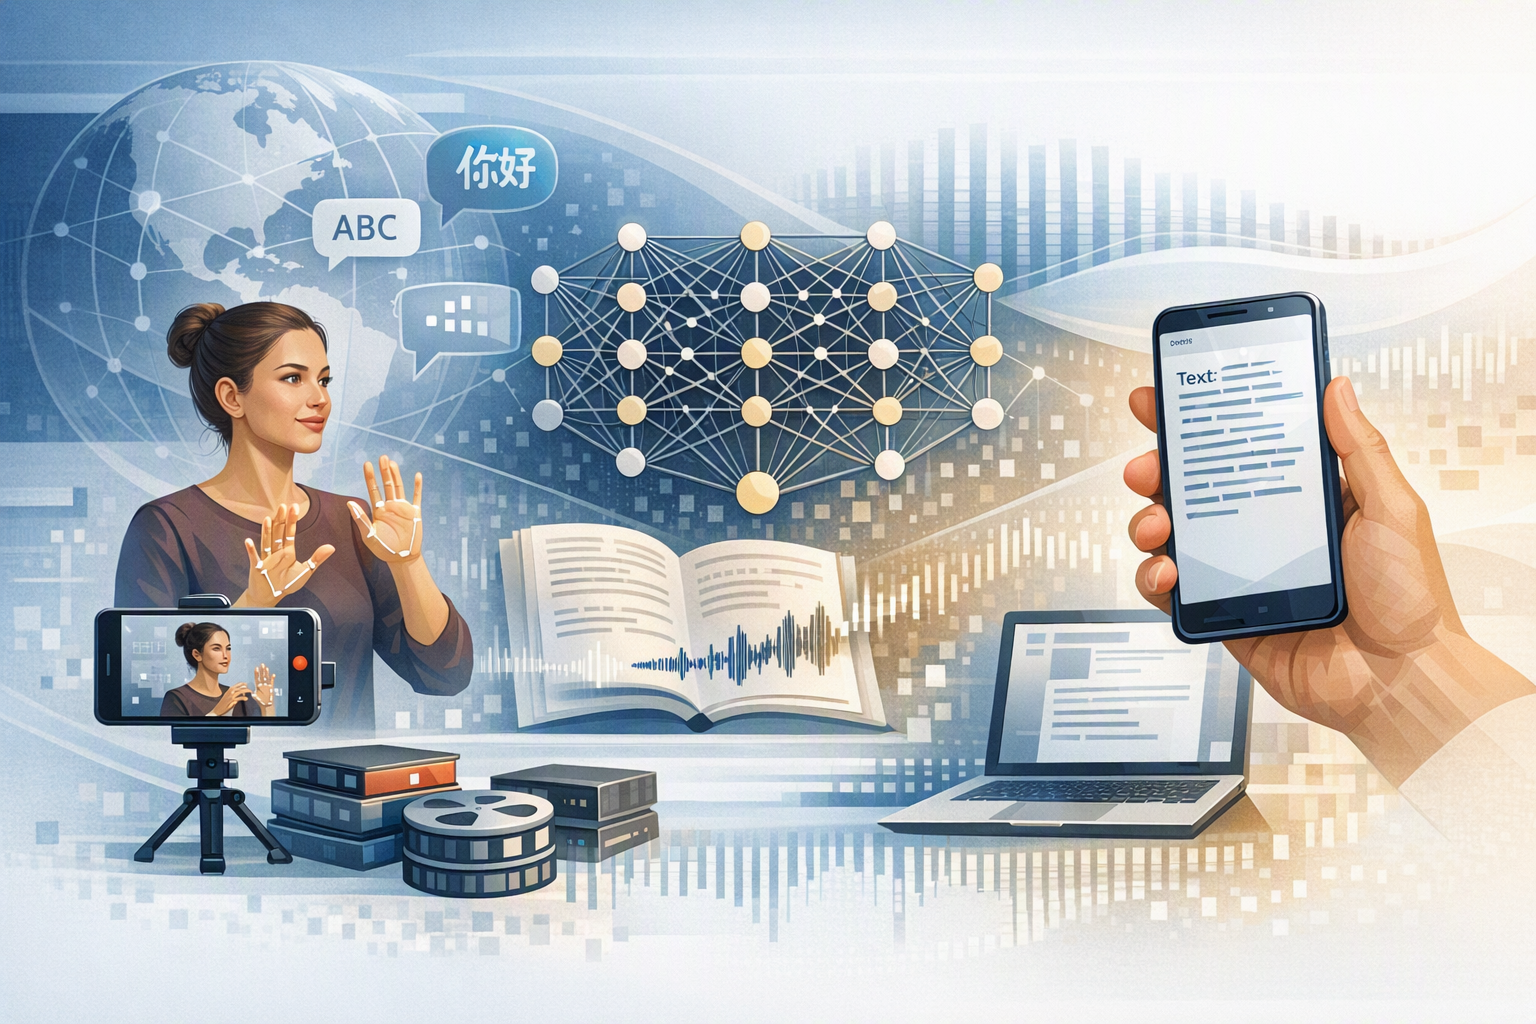
What is Google DeepMind's new SL2T sign-language-to-text AI model, how does it work (including its training data, on-device landmark trackinAn AI-generated conceptual illustration of sign language translation via smartphone.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What is Google DeepMind's new SL2T sign-language-to-text AI model, how does it work (including its training data, on-device landmark trackin. Article summary: Google DeepMind's **SL2T (sign-language-to-text)** is a massively multilingual transformer model that translates sign language video directly into written text, shipping for the first time in consumer devices on the Pixe. Topic tags: general, general web, user generated, academic. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, char
openai.com
Den 12. august 2026 sendte Google DeepMind SL2T (sign-language-to-text) ut i verden – en massiv, flerspråklig transformatormodell som oversetter tegnspråksvideo direkte til skriftlig tekst. Det er første gang en slik tegnspråk-AI når en vanlig mobiltelefon . I første omgang støttes amerikansk tegnspråk (ASL) til engelsk, og funksjonen er integrert i (for skriving, søk og meldinger) og (for uformelle en-til-en-samtaler) på Pixel 11 . Lanseringen markerer et skifte fra ren forskning til et faktisk produkt, men kommer med tydelig definerte rammer og kjente begrensninger.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "Google DeepMind SL2T: Slik gjør Pixel 11 tegnspråk om til tekst"?
Google DeepMinds SL2T (sign language to text) er den første AI modellen for tegnspråktolking som lanseres i et forbrukerprodukt – på Pixel 11 familien via Gboard og Live Transcribe.
Treningsdata: Over 100 000 timer med mer enn 50 tegnspråk
SL2T er trent på mer enn 100 000 timer med tegnspråksvideo som dekker over 50 tegnspråk, hvorav omtrent en fjerdedel av dataene er på ASL . Ved å trene på flere tegnspråk, dialekter og ferdighetsnivåer samtidig, fant Googles forskere at modellen presterer bedre enn systemer som bare kan ett språk – den lærer felles strukturelle mønstre som forbedrer generaliseringen . Treningsdataene utelukker bevisst tegnspråkbrukere under 18 år, noe som kan gjøre modellen mindre nøyaktig for yngre brukere .
Landemerkesporing på enheten: Kun koordinater forlater mobilen
Systemet er designet med personvern i fokus. Telefonens kamera kjører MediaPipe Holistic som trekker ut 2D-landmerkekoordinater for 130 nøkkelpunkter (ansikt, kropp, hender) bilde for bilde. Råvideoen forkastes umiddelbart og forlater aldri enheten . Kun disse abstrakte geometriske koordinatene sendes til Googles servere for oversettelse, og ingen logger over brukerens inn- eller utdata lagres uten uttrykkelig samtykke . 2D-representasjonen fanger ikke opp tungebevegelser eller gir dybdeinformasjon, noe som gjør det vanskeligere å skille mellom håndkontakt og svevende bevegelser – begge deler er viktige i ASL .
Direkte stilling-til-tekst: Gloss-fri, autoregressiv oversettelse
SL2T bruker en transformator som tar utgangspunkt i landmerkekoordinatsekvensen og genererer engelsk tekst autoregressivt. I motsetning til tidligere tilnærminger, lager den ikke først mellomliggende glossnotasjoner eller manuelt kodede lingvistiske representasjoner . Modellen oversetter snarere enn å transkribere – den produserer naturlig engelsk tekst, ikke en ord-for-ord-gjengivelse av ASL-tegn.
Benchmark-resultater: State-of-the-art, men leverandørrapporterte
På FLEURS-ASL, et nullskudd-evalueringsdatasett med komplekst, abstrakt språk tatt opp under studiobetingelser av sertifiserte døve tolker, oppnår SL2T 70 BLEURT, noe Google sier er langt over tidligere rapporterte resultater . Ytterligere benchmark-resultater inkluderer:
74 BLEURT på en enhåndsvariant av FLEURS-ASL
85 BLEURT på PRESTO-ASL, et datasett med setninger tiltenkt en AI-assistent
64% nøyaktighet på FSboard, et fingerskriftsdatasett samlet inn fra døve tegnspråkbrukere på mobil
Det er viktig å merke seg at dette er tall oppgitt av leverandøren; ingen uavhengig evaluering er publisert per lanseringsdato.
Styring og begrensninger: Bygget med sikkerhetstiltak
Rådgivende komité for AI-tegnspråk
Google opprettet en ekstern AI Sign Language Advisory Committee (AISLAC), som inkluderer representanter fra National Association of the Deaf (NAD), RIT/NTID, DPAN og World Federation of the Deaf (WFD). AISLAC var medforfatter av felles konsekvensrapport som definerer modellens operative rammer og begrensninger .
Forbudte bruksområder
SL2T er uttrykkelig designet og evaluert kun for lavrisiko-situasjoner som tekstinntasting, meldinger, søk og en-til-en-samtaler (for eksempel på en kafé eller i en butikk). Høyrisiko- eller flerpersonssamtaler i medisinske, juridiske og akademiske sammenhenger er utenfor modellens bruksområde .
ADA-ansvarsfraskrivelse
Google understreker i sin dokumentasjon at SL2T ikke er en erstatning for profesjonelle tolketjenester og bør ikke brukes i situasjoner hvor kommunikasjonsfeil kan føre til skade .
Kjente tekniske begrensninger
Redusert ytelse i dårlig lys: Ytelsen faller under dårlige lysforhold fordi MediaPipe Holistic-landmerker blir mindre pålitelige .
Støtter kun én tegnspråkbruker: Modellen håndterer bare én person om gangen; den kan ikke tolke samtaler med flere tegnspråkbrukere .
60-sekunders klippgrense: Enkeltoversettelser er begrenset til omtrent 60 sekunder med tegnspråk .
Ingen treningsdata for under 18 år: Modellen kan være mindre nøyaktig for yngre brukere, siden treningsdataene utelukker tegnspråkbrukere under 18 år .
Begrensninger med 2D-representasjon: Landmerkesystemet fanger ikke opp tungeartikulasjon eller gir dybdeinformasjon, noe som gjør det vanskelig å skille kontakt fra svevende bevegelser – begge språklig betydningsfulle i ASL .
Rollen til Sam Sepah
Sam Sepah, en døv Google-ansatt og medlem av tegnspråkteamet, spilte en sentral rolle i utviklingen av SL2T. Han er medforfatter på publikasjonen av FSboard-datasettet som ble brukt i modellens evaluering . Googles blogg og felles konsekvensrapport understreker at teamet jobbet tett med døve Google-ansatte – inkludert Sepah – gjennom testing før lansering for å avdekke modellatferd og grensesnittproblemer som målinger alene ikke kunne fange opp .
cnbctv18.comGoogle introduces sign-language-to-text AI model in Pixel 11: How it works and what are the challenges