AnswersPublished25 sources
SenseNova U1.5-Lite-Preview samler 4K-generering og presis bilderedigering i én åpen modell
SenseNova U1.5 Lite Preview er en åpen 8B MoT modell som samler visuell forståelse, generering og bilderedigering, med native 4K utdata. Demonstrasjonene peker mot plakater, infografikk, detaljerte illustrasjoner, lokale endringer og komposisjoner basert på flere referansebilder – med særlig vekt på kinesisk og enge...
Publisert avRedigert med GPT-5.6 TerraBilder generert med GPT Image 2
Research answer
Key takeaways
- SenseNova U1.5 Lite Preview er en åpen 8B MoT modell som samler visuell forståelse, generering og bilderedigering, med native 4K utdata.
- Demonstrasjonene peker mot plakater, infografikk, detaljerte illustrasjoner, lokale endringer og komposisjoner basert på flere referansebilder – med særlig vekt på kinesisk og engelsk tekst samt komplekse oppsett.
- Åpne vekter og Apache 2.0 lisens muliggjør lokal testing og integrasjon i egne arbeidsflyter, men 4K produksjon krever fortsatt betydelige GPU ressurser.
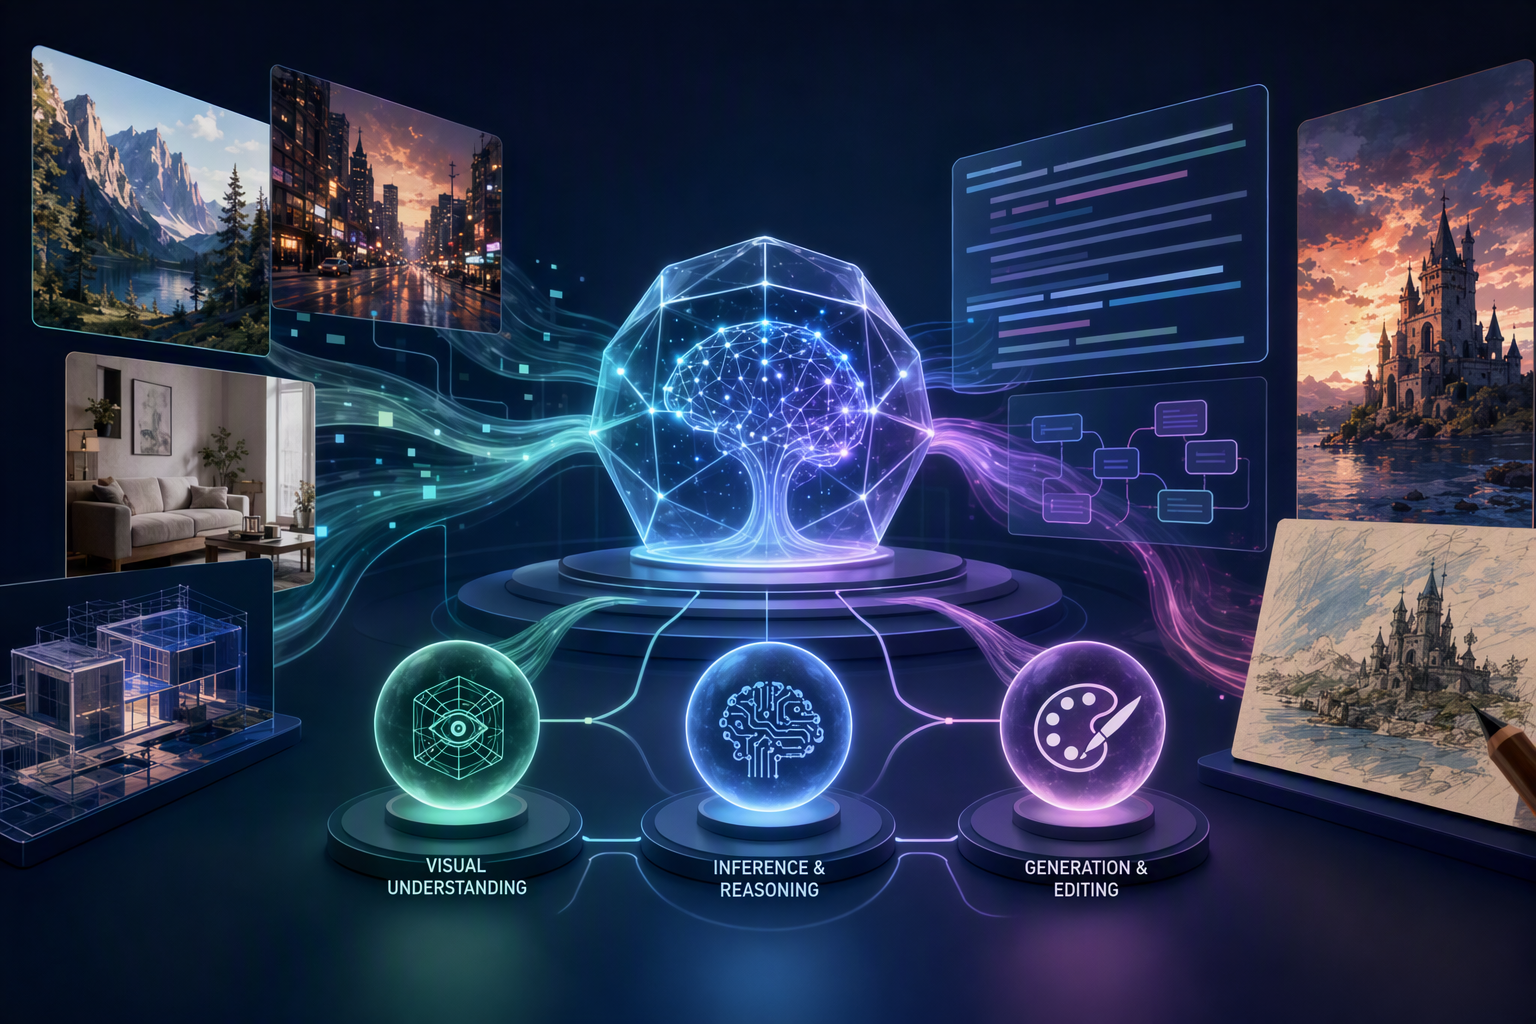
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: How does SenseTime’s open-source SenseNova U1.5-Lite-Preview—an 8B-MoT lightweight unified multimodal model based on NEO-Unify—combine langu. Article summary: SenseNova U1.5-Lite-Preview is best understood as a single, lightweight multimodal system rather than a text-to-image model with separate add-on editing tools: its NEO-Unify design joins visual understanding, inference/r. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fa
SenseNova U1.5-Lite-Preview er en åpen multimodal bildemodell med 8B-MoT-skala, bygget på SenseTimes NEO-Unify-arkitektur. Hovedideen er ikke bare tekst-til-bilde: Én modell skal kunne forstå bilder og instrukser, resonnere over visuelle krav, generere bilder i opptil native 4K og gjøre kontrollerte endringer med ett eller flere referansebilder. 6
9
10
Det er særlig interessant når et visuelt uttrykk må tåle mange revisjoner. I stedet for å generere hele motivet på nytt når tekst, produkt, person eller en mindre del av scenen endres, er modellen ment å bevare angitte deler av komposisjonen mens den endrer området brukeren ber om. Kildematerialet består i stor grad av produktinformasjon og demonstrasjoner. Det bør derfor leses som dokumentasjon av tiltenkte funksjoner, ikke som uavhengig bevis på jevn kvalitet i faktisk produksjon. 2
6
Hva «samlet multimodalitet» innebærer
SenseTime beskriver preview-modellen som en modell som kobler visuell forståelse, resonnering, generering og redigering i én NEO-Unify-basert arkitektur på 8B-MoT-skala. 1
6 I praksis kan arbeidsflyten starte med en tekstbrief, et eksisterende bilde eller flere referanser, fremfor at man må bruke ulike systemer for bildeanalyse, generering, redigering og oppskalering.
Modellen er laget for å følge kombinasjoner av krav knyttet til motiv, antall, romlige relasjoner, tekst, layout og visuell stil. Den støtter arbeidsflyter med ett eller flere referansebilder, mens senere omtale av U1.5-utgaven beskriver områdestyring med blant annet avgrensningsbokser og visuelle markører. 2
19
22
For designarbeid er dette en vesentlig forskjell. En beskjed som «behold produktet og sidehierarkiet, bytt overskrift, flytt tilbudet og behold resten av oppsettet» krever både semantisk forståelse, pikselbasert generering og evne til å bevare godkjente elementer. Modellen sikter dermed mot en annen arbeidsflyt enn en ren bildegenerator som først og fremst lager nye enkeltbilder.
Hvorfor native 4K har praktisk betydning
Preview-modellen støtter native 4K-bildegenerering, ifølge SenseTime og omtale av lanseringen. 6
10
15 «Native» betyr her at modellen presenteres som i stand til å lage høyoppløselige bilder direkte, ikke bare gjennom et separat oppskaleringsledd etter genereringen.
For kreative team er ikke oppløsning viktig bare som markedsføringstall. Store formater kan være avgjørende når leveransen trenger fine teksturer, tydelige grafiske kanter, tette layoutflater eller tekst som er del av selve bildet. Modellen er dessuten særskilt posisjonert for bedre gjengivelse av kinesisk og engelsk tekst og mer kompliserte layoutstrukturer. 6
8
15
Det fjerner likevel ikke behovet for kvalitetssikring. Tett brødtekst, merkevaretypografi og liten juridisk tekst bør alltid kontrolleres mot originalbriefen før publisering.
Hva demonstrasjonene sier om bruken
Demonstrasjonene tyder på at SenseNova U1.5-Lite-Preview er rettet mot visuelle leveranser som kombinerer illustrasjon, komposisjon, informasjon og iterasjon.
Detaljert kunst og informasjonsgrafikk
Lanseringsmaterialet fremhever finere teksturer, komplekse layoutformer og kinesisk og engelsk tekstgenerering. 6
15
36 Det peker mot mer enn stemningsbilder: Plakater, merkevaregrafikk, infografikk og redaksjonelle bilder for sosiale medier er naturlige scenarioer å teste modellen på.
Det avgjørende er om modellen klarer å holde komposisjonen forståelig når mange krav konkurrerer om plassen – overskrift, støttetekst, produkt, visuelt motiv, hierarki og bakgrunnsdetaljer. Den rapporterte støtten for prompt med mange samtidige krav er relevant nettopp her. 2
22
Bevare designrammen mens innholdet endres
En referansestyrt arbeidsflyt kan være nyttig når et team vil beholde et visuelt system, men endre kampanjemotiv, tekst eller illustrasjon. Modellen støtter referansebasert redigering og flere referansebilder. Senere U1.5-materiale beskriver også bevaring av identitet, romlig struktur, layoutrelasjoner og områder som ikke redigeres, samtidig som målrettede endringer utføres. 10
19
20
Dersom dette fungerer stabilt i praksis, er det mer anvendelig enn generell stiloverføring. Et referansebilde kan da brukes som en komposisjonsmal: Hierarki og visuelt språk beholdes, mens innholdet tilpasses en ny kampanje, artikkel eller målgruppe. Kildene dokumenterer kontrollene og målene for bevaring, men ikke en uavhengig benchmark for hvor pålitelig dette er i krevende brief-er.
Revisjonstunge, lokale endringer
Kontrollert redigering er modellens tydeligste arbeidsflytpåstand. Den beskrives som støttende for målrettede endringer, utskifting av elementer, tekstforbedring og redigering med flere referanser, med kontroller som masker, avgrensningsbokser og visuelle markører. 19
20
25
For reklame- og redaksjonell produksjon kan dette redusere den velkjente syklusen med å generere på nytt og reparere: Endre ett tilbud, bytt produkt, revider en bildetekst eller juster en avgrenset del uten bevisst å forkaste det godkjente motivet og komposisjonen. Verdien er størst når en ressurs allerede inneholder mange designvalg som er kostbare å gjenskape.
Kinesiske tegn og tekst som visuelt materiale
SenseTime fremhever bedre gjengivelse av kinesisk og engelsk tekst, samt organisering av komplekse layouter. 6
15 Det er relevant fordi plakater og infografikk på kinesisk ofte bruker tekst både som informasjon og som et bærende komposisjonselement.
Bedre gjengivelse er likevel ikke det samme som garantert tegn-for-tegn-korrekthet. Team som produserer materiale for publisering, bør teste egne skriftsystemer, teksttetthet, typografiske uttrykk og korrekturrutiner fremfor å anta at en demonstrasjon gjelder alle layouttyper.
Flere referanser i samme bildeprosess
Redigering med flere bilder gjør det mulig å hente flere visuelle innganger inn i én prosess. Modellens rapporterte støtte for flere referansebilder og områdestyring kan for eksempel kombinere et produktbilde, en person- eller karakterreferanse, et miljø og en referanse for art direction. 2
10
25
For kreative produksjonsteam er dette potensielt mer nyttig enn ett enkelt referansebilde, fordi reelle brief-er ofte bygger på flere godkjente ressurser. Utfordringen er ikke bare å få et helhetlig resultat, men å beholde de riktige egenskapene fra hver inngang. Det bør være en del av teamets egen testpakke.
Hvorfor åpne vekter betyr noe
Preview-modellen er tilgjengelig via offentlige modellkanaler, og Hugging Face-prosjektet er utgitt under Apache 2.0-lisensen. 6
13 Det gir utviklere mulighet til å undersøke, distribuere, integrere og tilpasse modellen uten å være helt avhengig av et driftet API for bildegenerering.
Lokal bruk kan være viktig for team som trenger tettere kontroll over proprietære referansebilder, utkast eller repeterbare arbeidsflyter. En offisiell nodepakke for ComfyUI er omtalt for lokal tekst-til-bilde-generering, redigering med ett eller flere bilder og områdestyrte arbeidsflyter. 25
Men «lettvekts» er relativt. Betegnelsen 8B-MoT betyr ikke at modellen er enkel å kjøre på en vanlig bærbar PC, særlig ikke med høy oppløsning. Det offisielle prosjektet dokumenterer innlasting som kan fordele modellen over flere GPU-er, mens tredjeparts omtale anslår betydelig minnebehov for vekter i full presisjon og peker på kvantisering eller mer begrenset innlasting for mindre maskinvare. 31
26 Maskinvare, ventetid og kvalitetstesting bør derfor inngå i planleggingen før utrulling.
Sammenlignet med åpne og lukkede bildemodeller
SenseNova U1.5-Lite-Preview skiller seg ut med den foreslåtte kombinasjonen av åpen tilgjengelighet, samlet forståelse–generering–redigering, native 4K, flere referanseinnganger og eksplisitte redigeringskontroller som skal bevare eksisterende innhold. 2
6
10 For team som må selvhoste, automatisere arbeidsflyter eller arbeide med sensitive visuelle referanser, kan denne pakken være viktigere enn en enkelt poengsum for estetisk kvalitet.
Det ville likevel være for tidlig å erklære modellen kategorisk bedre enn ledende åpne eller lukkede alternativer. Kildene som er tilgjengelige her, dokumenterer ikke en bred, uavhengig sammenligning av tekstnøyaktighet, kunstnerisk kvalitet, redigeringspålitelighet, hastighet, driftskostnad eller sikkerhet mellom modellene. Lukkede systemer kan fortsatt være attraktive for driftet infrastruktur og mer ferdigpolert generering, mens andre åpne verktøy kan passe bedre inn i etablerte produksjonsløp.
Praktisk vurdering
SenseNova U1.5-Lite-Preview fremstår som mest interessant som et åpent verktøy for visuell produksjon der materiale må forstås, genereres og revideres under tydelige begrensninger. Demonstrasjonene peker mot plakater, tette informasjonsgrafikker, komposisjoner med flere referanser og kontrollerte kampanjevarianter – ikke bare engangsgenerering av bilder. 6
10
15
Før modellen blir en fast del av produksjonen, bør den evalueres med reelle ressurser: flerspråklig tekst, etablerte merkevarelayouter, produktreferanser, vanskelige lokale redigeringer og revisjonssekvenser over flere runder. Det viktige målet er ikke om en demo ser imponerende ut, men om modellen pålitelig bevarer detaljene teamet ikke har råd til å miste.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "SenseNova U1.5-Lite-Preview samler 4K-generering og presis bilderedigering i én åpen modell"?
SenseNova U1.5 Lite Preview er en åpen 8B MoT modell som samler visuell forståelse, generering og bilderedigering, med native 4K utdata.
What are the key points to validate first?
SenseNova U1.5 Lite Preview er en åpen 8B MoT modell som samler visuell forståelse, generering og bilderedigering, med native 4K utdata. Demonstrasjonene peker mot plakater, infografikk, detaljerte illustrasjoner, lokale endringer og komposisjoner basert på flere referansebilder – med særlig vekt på kinesisk og engelsk tekst samt komplekse oppsett.
What should I do next in practice?
Åpne vekter og Apache 2.0 lisens muliggjør lokal testing og integrasjon i egne arbeidsflyter, men 4K produksjon krever fortsatt betydelige GPU ressurser.
Sources
news.aibase.comSenseNova U1.5-Lite-Preview by SenseTime - AI NEWS
eu.36kr.comHand-Drawn Sketches to Posters
comfyui-wiki.comSenseNova-U1.5 Preview: 4K Image Generation and ...
technode.comSenseTime open-sources 8B multimodal model with native 4K image output · TechNode
aiboss88.comSenseNova U1.5-Lite-Preview - SenseTime's open-source ...